感知机
输入空间: X⊆Rn , x=(x(1),x(2),⋯,x(n))
输出空间: Y={+1,−1}, y∈Y
感知机:
f(x)=sign(w⋅x+b)
其中,w=(w(1),w(2),⋯,w(n))T∈Rn 称为权值(Weight),b∈R 称为偏置(Bias)
假设空间: F={f∣f(x)=w⋅x+b}
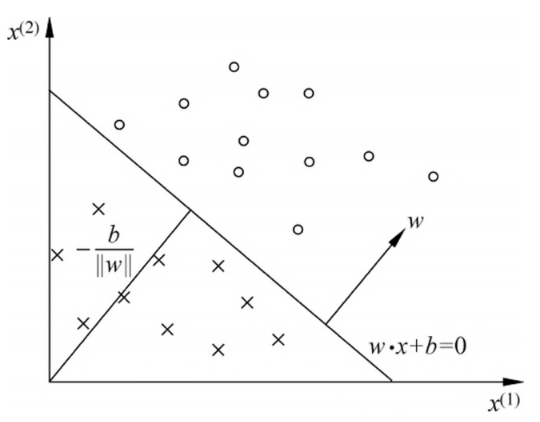
感知机有如下几何解释:线性方使用方程
w⋅x+b=0
对应于特征空间 Rn 中的一个超平面 S。其中,w 是超平面的法向量,b 是超平面的截距。
线性可分
给定数据集
T={(x1,y1),(x2,y2),⋯,(xN,yN)}
若存在某个超平面 S:w⋅x+b=0, 能够将数据集的正负实例点完全正确地划分到超平面两侧,即
{yi=+1,yi=−1,则 w⋅xi+b>0,则 w⋅xi+b<0,
那么,称 T 为线性可分数据集;否则,称 T 为线性不可分数据集。
线性可分的充要条件
设集合 S⊂Rn 是由 Rn 中的 k 个点所组成的集合,即 S={x1,x2,⋯,xk}。定义 S 的凸壳 conv(S) 为
conv(S)={x=i=1∑kλixii=1∑kλi=1, λi≥0, i=1,2,⋯,k}
凸壳是凸集
设正实例点集为 P,负实例点集为 N, 则样本集线性可分的充分必要条件是正实例点集所构成的凸壳与负实例点集所构成的凸壳互不相交。即:
样本集线性可分⟺conv(P)∩conv(N)=∅
必要性证明
样本集线性可分⟹conv(P)∩conv(N)=∅.
∀u∈conv(P), 带入超平面判别函数:
w⊤u+b=w⊤(i=1∑mλixi)+b=i=1∑mλiw⊤xi+b=i=1∑mλi(w⊤xi+b).
由于每个正实例点都满足 w⊤xi+b>0, 并且 λi≥0、∑iλi=1,因此
w⊤u+b>0
这说明正实例点的整个凸壳都位于超平面的正侧, 同理可证明负实例点凸壳位于负侧
充分性证明
conv(P)∩conv(N)=∅⟹样本集线性可分.
正、负实例点集都是非空有限点集,所以它们的凸壳都是非空紧凸集。又因为两个凸壳互不相交,所以它们之间存在一对距离最短的点。记为
u∗∈conv(P),v∗∈conv(N).
令 d=v∗−u∗, 由于两个凸壳互不相交,故 u∗=v∗,d=0.
由于凸壳一定是凸集,∀u∈conv(P) ,有:
(1−t)u∗+tu∈conv(P),0≤t≤1
根据最短距离的性质,函数
v∗−[u∗+t(u−u∗)]2
在 t=0 处取得区间 [0,1] 上的最小值,因此其右导数非负
−2(v∗−u∗)⊤(u−u∗)≥0.i.e.d⊤(u−u∗)≤0
即 d⊤u≤d⊤u∗, 同理,∀v∈conv(N),可得 d⊤v≥d⊤v∗, 因此
d⊤u≤d⊤u∗<d⊤v∗≤d⊤v.
严格不等式来自
d⊤v∗−d⊤u∗=d⊤(v∗−u∗)=d⊤d=∥d∥2>0.
定义
w=d,b=−2d⊤u∗+d⊤v∗.
于是超平面为
d⊤x−2d⊤u∗+d⊤v∗=0.
令
c=2d⊤u∗+d⊤v∗.
因为
d⊤u∗<c<d⊤v∗,
所以对于任意正实例点 x∈P,由于 x∈conv(P),有
d⊤x≤d⊤u∗<c,
即
d⊤x−c<0.
对于任意负实例点 z∈N,由于 z∈conv(N),有
d⊤z≥d⊤v∗>c,
即
d⊤z−c>0.
因此,该超平面将正、负实例点严格分开。
如果希望正实例点位于正侧,只需将 w,b 同时取反即可,不影响超平面的几何位置。
所以样本集线性可分,充分性得证。
用Python验证线性可分
Python63 行
import numpy as np
from scipy.optimize import linprog


def check_linear_separable(X, y):
    """
    根据正负样本凸壳是否相交,判断数据集是否线性可分。

    参数
    ----
    X : shape (n_samples, n_features)
        样本特征矩阵
    y : shape (n_samples,)
        标签,必须为 -1 或 +1

    返回
    ----
    bool
        True 表示线性可分,False 表示线性不可分
    """
    X = np.asarray(X, dtype=float)
    y = np.asarray(y)

    P = X[y == 1]    # 正类样本
    N = X[y == -1]   # 负类样本

    if len(P) == 0 or len(N) == 0:
        raise ValueError("数据集必须同时包含正类和负类样本")

    # 设 z = [lambda, mu]
    m, n = len(P), len(N)
    d = X.shape[1]

    # P.T @ lambda - N.T @ mu = 0
    A_eq = np.block([
        [P.T, -N.T],
        [np.ones((1, m)), np.zeros((1, n))],
        [np.zeros((1, m)), np.ones((1, n))]
    ])

    b_eq = np.r_[np.zeros(d), 1.0, 1.0]

    # 目标函数为 0,只需判断是否存在可行解
    result = linprog(
        c=np.zeros(m + n),
        A_eq=A_eq,
        b_eq=b_eq,
        bounds=(0, None),
        method="highs"
    )

    if result.status == 0:
        # 存在两个凸壳的公共点
        return False
    elif result.status == 2:
        # 约束不可行,凸壳不相交
        return True
    else:
        # 求解器未能明确判断,不能擅自归类
        raise RuntimeError(
            f"无法确定线性可分性:{result.message}"
        )
损失函数
对于任意 x0∈Rn,其到超平面 S 的距离为
∥w∥∣w⋅x0+b∣
-
若 x0 是正确分类点,则
∥w∥∣w⋅x0+b∣=⎩⎨⎧∥w∥w⋅x0+b,−∥w∥w⋅x0+b,y0=+1,y0=−1.
-
若 x0 是错误分类点,则
∥w∥∣w⋅x0+b∣=⎩⎨⎧−∥w∥w⋅x0+b,∥w∥w⋅x0+b,y0=+1,y0=−1.=−∥w∥y0(w⋅x0+b)
误分类点 xi 到 S 的距离:
−∥w∥1yi(w⋅xi+b)
所有误分类点到 S 的距离:
−∥w∥1xi∈M∑yi(w⋅xi+b)
其中,M 代表所有误分类点的集合。
损失函数:
L(w,b)=−xi∈M∑yi(w⋅xi+b)
模型参数估计:
argw,bminL(w,b)
梯度:
∇wL(w,b)=−xi∈M∑yixi,∇bL(w,b)=−xi∈M∑yi
参数更新:
- 批量梯度下降法(Batch Gradient Descent):每次迭代时使用所有误分类点来进行参数更新。
w←w+ηxi∈M∑yixi,b←b+ηxi∈M∑yi
其中,0<η≤1 代表步长。
- 随机梯度下降法(Stochastic Gradient Descent):每次随机选取一个误分类点。
w←w+ηyixi,b←b+ηyi
学习算法的原始形式
输入: 训练数据集 T={(x1,y1),(x2,y2),⋯,(xN,yN)},其中 xi∈X=Rn,yi∈Y={−1,+1},i=1,2,⋯,N;学习率 η(0<η≤1)。
输出: w,b;感知机模型 f(x)=sign(w⋅x+b)。
-
选取初值 w0,b0;
-
在训练集中选取数据 (xi,yi);
-
如果 yi(w⋅xi+b)≤0,则
w←w+ηyixib←b+ηyi
-
转至步骤(2),直至训练集中没有误分类点。
原始算法的Python实现
Python49 行
import numpy as np

class Perceptron:
    def __init__(self, eta=0.1, max_iter=10000):
        self.eta = eta
        self.max_iter = max_iter
        self.w = None
        self.b = None
        self.n_iter_ = 0
        self.converged_ = False

    def fit(self, X, y):
        X = np.asarray(X, dtype=float)
        y = np.asarray(y)

        n_samples, n_features = X.shape

        # 1. 初始化参数
        self.w = np.zeros(n_features)
        self.b = 0.0

        # 2. 反复遍历训练集
        for epoch in range(self.max_iter):
            errors = 0

            for i in range(n_samples):
                x_i, y_i = X[i], y[i]

                # 3. 判断是否误分类
                if y_i * (self.w @ x_i + self.b) <= 0:
                    self.w += self.eta * y_i * x_i
                    self.b += self.eta * y_i
                    errors += 1

            self.n_iter_ = epoch + 1

            # 4. 没有误分类点,训练结束
            if errors == 0:
                self.converged_ = True
                break

        return self

    def predict_one(self, x):
        return 1 if self.w @ x + self.b >= 0 else -1

    def predict(self, X):
        X = np.asarray(X, dtype=float)
        return np.where(X @ self.w + self.b >= 0, 1, -1)
实例
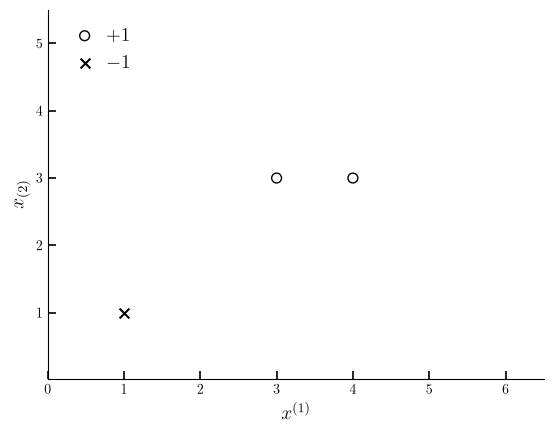
数据点为
Python2 行
X = np.array([[3,3], [4,3], [1,1]])
y = np.array([1, 1, -1])
构建最优化问题:
w,bminL(w,b)=−xi∈M∑yi(w⋅xi+b)
按照原始算法求解 w,b。η=1。
(1)取初值 w0=0, b0=0
(2)对 x1=(3,3)T,y1(w0⋅x1+b0)=0,未能被正确分类,更新 w, b
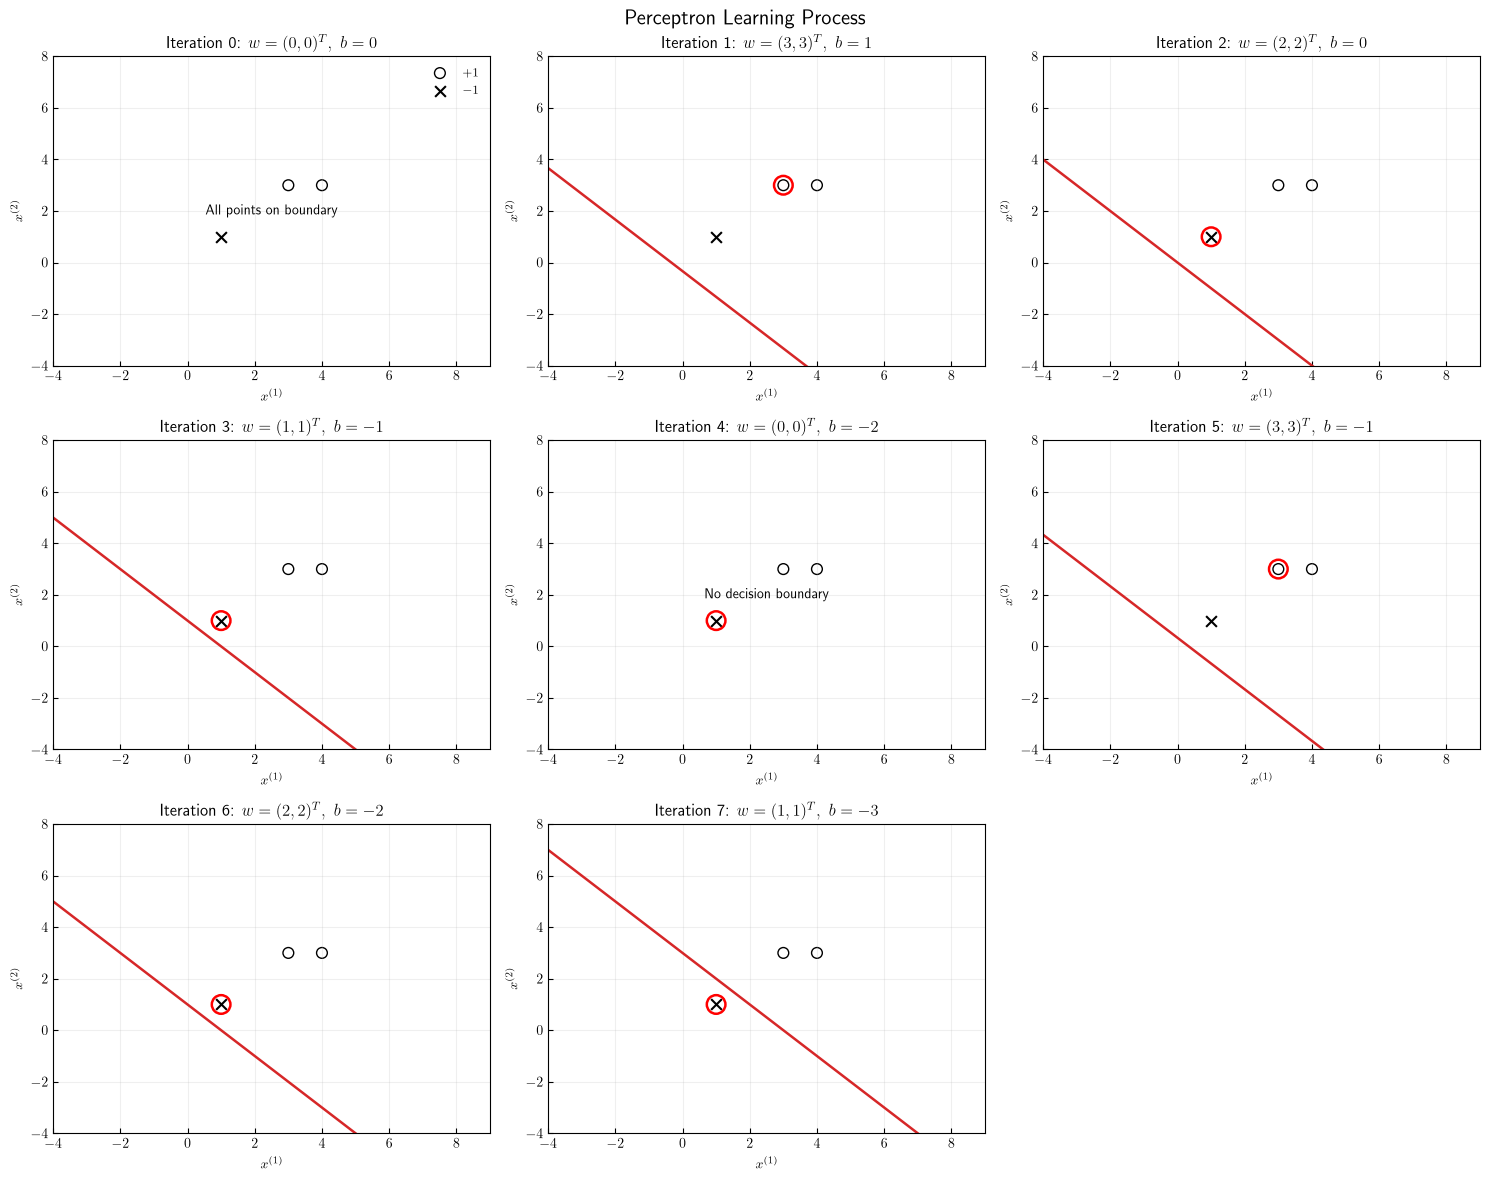
w1=w0+y1x1=(3,3)T, b1=b0+y1=1
得到线性模型
w1⋅x+b1=3x(1)+3x(2)+1
(3)对 x1,x2,显然,yi(w1⋅xi+b1)>0,被正确分类,不修改 w, b;
对 x3=(1,1)T,y3(w1⋅x3+b1)<0,被误分类,更新 w, b。
w2=w1+y3x3=(2,2)T, b2=b1+y3=0
得到线性模型
w2⋅x+b2=2x(1)+2x(2)
如此继续下去,直到
w7=(1,1)T, b7=−3
w7⋅x+b7=x(1)+x(2)−3
对所有数据点 yi(w7⋅xi+b7)>0,没有误分类点,损失函数达到极小。
分离超平面为:x(1)+x(2)−3=0
感知机模型为:f(x)=sign(x(1)+x(2)−3)
| 迭代次数 |
误分类点 |
w |
b |
w⋅x+b |
| 0 |
|
0 |
0 |
0 |
| 1 |
x1 |
(3,3)T |
1 |
3x(1)+3x(2)+1 |
| 2 |
x3 |
(2,2)T |
0 |
2x(1)+2x(2) |
| 3 |
x3 |
(1,1)T |
−1 |
x(1)+x(2)−1 |
| 4 |
x3 |
(0,0)T |
−2 |
−2 |
| 5 |
x1 |
(3,3)T |
−1 |
3x(1)+3x(2)−1 |
| 6 |
x3 |
(2,2)T |
−2 |
2x(1)+2x(2)−2 |
| 7 |
x3 |
(1,1)T |
−3 |
x(1)+x(2)−3 |
| 8 |
无 |
(1,1)T |
−3 |
x(1)+x(2)−3 |
绘图代码
Python123 行
import numpy as np
import matplotlib.pyplot as plt
import math

# ==================== 1. 输入数据 ====================
X = np.array([[3, 3], [4, 3], [1, 1]])
y = np.array([1, 1, -1])

eta = 1                 # 学习率
max_updates = 100        # 最大更新次数

# LaTeX 公式设置(需要本机安装 LaTeX)
plt.rcParams['text.usetex'] = True
plt.rcParams['text.latex.preamble'] = r'\usepackage{amsmath}'

# ==================== 2. 感知机迭代 ====================
w = np.zeros(X.shape[1], dtype=float)
b = 0.0

# 保存初始状态
history = [(w.copy(), b, None)]

for _ in range(max_updates):
    updated = False

    # 按输入顺序寻找第一个误分类点
    for i in range(len(X)):
        if y[i] * (np.dot(w, X[i]) + b) <= 0:
            w += eta * y[i] * X[i]
            b += eta * y[i]

            # 保存更新后的参数和本次误分类点
            history.append((w.copy(), b, i))
            updated = True
            break

    # 一轮扫描没有误分类点,算法收敛
    if not updated:
        break
else:
    print(f"达到最大更新次数 {max_updates},算法可能尚未收敛。")

# ==================== 3. 绘制迭代过程 ====================
n = len(history)
cols = min(3, n)
rows = math.ceil(n / cols)

fig, axes = plt.subplots(
    rows, cols,
    figsize=(5 * cols, 4 * rows),
    squeeze=False
)

# 统一坐标范围,方便比较, 实际使用可能需要微调
xmin, ymin = X.min(axis=0) - 5
xmax, ymax = X.max(axis=0) + 5
x1 = np.linspace(xmin, xmax, 300)

for step, (w, b, error_idx) in enumerate(history):
    ax = axes.flat[step]

    # 绘制两类样本
    ax.scatter(
        X[y == 1, 0], X[y == 1, 1],
        marker='o', facecolors='none',
        edgecolors='black', s=60, label=r'$+1$'
    )
    ax.scatter(
        X[y == -1, 0], X[y == -1, 1],
        marker='x', color='black',
        s=60, label=r'$-1$'
    )

    # 高亮本次更新所使用的误分类点
    if error_idx is not None:
        ax.scatter(
            X[error_idx, 0], X[error_idx, 1],
            s=180, facecolors='none',
            edgecolors='red', linewidths=1.8,
            label='Misclassified'
        )

    # 绘制 w·x + b = 0
    if np.allclose(w, 0):
        message = 'All points on boundary' if np.isclose(b, 0) \
                  else 'No decision boundary'
        ax.text(
            0.5, 0.5, message,
            transform=ax.transAxes,
            ha='center', va='center'
        )
    elif not np.isclose(w[1], 0):
        x2 = -(w[0] * x1 + b) / w[1]
        ax.plot(x1, x2, color='tab:red', lw=1.8)
    else:
        ax.axvline(-b / w[0], color='tab:red', lw=1.8)

    ax.set_title(
        rf'Iteration {step}: '
        rf'$w=({w[0]:g},{w[1]:g})^T,\ b={b:g}$'
    )
    ax.set_xlim(xmin, xmax)
    ax.set_ylim(ymin, ymax)
    ax.set_xlabel(r'$x^{(1)}$')
    ax.set_ylabel(r'$x^{(2)}$')
    ax.tick_params(direction='in')
    ax.grid(alpha=0.2)

    # 只在第一张图中显示图例
    if step == 0:
        ax.legend(frameon=False, fontsize=9)

# 隐藏多余子图
for ax in axes.flat[n:]:
    ax.set_visible(False)

fig.suptitle('Perceptron Learning Process', fontsize=15)
plt.tight_layout()
plt.show()

print(f"总更新次数:{len(history) - 1}")
print(f"最终 w = {w}, b = {b}")
算法的收敛性
记 w^=(wT,b)T,x^=(xT,1)T,则分离超平面可以写为
w^⋅x^=0
若训练集
T={(x1,y1),(x2,y2),⋯,(xN,yN)}
线性可分,其中,xi∈X⊆Rn,yi∈Y={+1,−1},则
- 存在满足条件 ∥w^opt∥=1 的超平面 w^opt⋅x^=0 可将 T 完全正确分开;且 ∃γ>0,对所有 i=1,2,⋯,N,
yi(w^opt⋅x^i)≥γ
- 令 R=max1≤i≤N∥x^i∥,则感知机算法在 T 上的误分类次数 k 满足不等式
k≤(γR)2
证明
1.由于 T 是线性可分的,由定义,存在超平面可将训练数据集完全正确分开,取此超平面为
w^opt⋅x^=wopt⋅x+bopt=0,∥w^opt∥=1
由于对有限的 i=1,2,⋯,N,均有
yi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)>0
记 γ=mini{yi(wopt⋅xi+bopt)} , 则有
yi(w^opt⋅x^i)=yi(wopt⋅xi+bopt)≥γ
2.假设 w^0=0,若实例被误分类,则更新权重。令 w^k−1 为第 k 个误分类实例之前的扩充权重向量,即
‘w^k−1=(wk−1T, bk−1)‘
若
yi(w^k−1⋅x^i)=yi(wk−1⋅xi+bk−1)≤0
则,(xi,yi) 为第 k 个误分类实例,更新参数,
{wk←wk−1+ηyixibk←bk−1+ηyii.e.w^k=w^k−1+ηyix^i
下面推导两个不等式
{w^k⋅w^opt≥kηγ∥w^k∥2≤kη2R2
w^k⋅w^opt≥kηγ:
w^k⋅w^opt=(w^k−1+ηyix^i)⋅w^opt=w^k−1⋅w^opt+ηyiw^opt⋅x^i≥w^k−1⋅w^opt+ηγ≥w^k−2⋅w^opt+2ηγ⋮≥w^1⋅w^opt+(k−1)ηγ≥w^0⋅w^opt+kηγ=kηγ
∥w^k∥2≤kη2R2:
∥w^k∥2=∥w^k−1+ηyix^i∥2=∥w^k−1∥2+2ηyiw^k−1⋅x^i+η2∥x^i∥2≤∥w^k−1∥2+η2∥x^i∥2≤∥w^k−1∥2+η2R2≤∥w^k−2∥2+2η2R2⋮≤∥w^1∥2+(k−1)η2R2≤∥w^0∥2+kη2R2=kη2R2
结合所得两个不等式,
{w^k⋅w^opt≥kηγ∥w^k∥2≤kη2R2⟹kηγ≤w^k⋅w^opt≤∥w^k∥∥w^opt∥≤kηR
得到:
kηγ≤kηR⟹k2γ2≤kR2
于是,有
k≤(γR)2
- 收敛性:对于线性可分的 T,经过有限次搜索,可得将 T 完全正确分开的分离超平面。
- 依赖性:不同的初值选择,或者迭代过程中不同的误分类点选择顺序,可能会得到不同的分离超平面。
- 对于线性不可分的 T,算法不收敛,迭代结果会发生震荡。
- 为得到唯一分离超平面,需增加约束条件。
对偶形式
在原始形式中,若(xi,yi)为误分类点,可如下更新参数:
w←w+ηyixi;b←b+ηyi
假设初始值 w0=0, b0=0,对误分类点 (xi,yi) 通过上述公式更新参数,修改 ni 次之后,w,b 的增量分别为 αiyixi 和 αiyi,其中 αi=niη。
最后学习到的参数为,
w=i=1∑Nαiyixi;b=i=1∑Nαiyi
算法 (感知机学习算法的对偶形式)
输入:线性可分的数据集 T={(x1,y1),(x2,y2),⋯,(xN,yN)},其中 xi∈Rn, yi∈{−1,+1}, i=1,2,⋯,N;学习率 η (0<η≤1);
输出:α,b;感知机模型 f(x)=sign(∑j=1Nαjyjxj⋅x+b),其中 α=(α1,α2,⋯,αN)T。
(1) α←0, b←0;
(2) 在训练集中选取数据 (xi,yi);
(3) 如果 yi(∑j=1Nαjyjxj⋅xi+b)≤0,
αib←αi+η←b+ηyi
(4) 转至 (2) 直到没有误分类数据。
(3) 若 yi(∑j=1Nαjyjxj⋅xi+b)≤0,
αi←αi+η;b←b+ηyi
迭代条件:
yi(j=1∑Nαjyjxj⋅xi+b)=yi[(α1y1x1+α2y2x2+⋯+αNyNxN)⋅xi+b]=yi(α1y1x1⋅xi+α2y2x2⋅xi+⋯+αNyNxN⋅xi+b)≤0
Gram 矩阵:
G=[xi⋅xj]N×N=x1⋅x1x2⋅x1⋮xN⋅x1x1⋅x2x2⋅x2⋮xN⋅x2⋯⋯⋯x1⋅xNx2⋅xN⋮xN⋅xN
对偶形式的Python实现
Python63 行
import numpy as np


class Perceptron:
    def __init__(self, eta=0.1, max_iter=10000):
        self.eta = eta
        self.max_iter = max_iter
        self.alpha = None
        self.b = 0.0
        self.X_train = None
        self.y_train = None
        self.converged_ = False
        self.n_iter_ = 0

    def fit(self, X, y):
        X = np.asarray(X, dtype=float)
        y = np.asarray(y, dtype=int)

        n_samples = len(X)
        self.X_train = X
        self.y_train = y

        # (1) 初始化 alpha 和 b
        self.alpha = np.zeros(n_samples)
        self.b = 0.0
        self.converged_ = False

        # 预先计算训练样本之间的内积
        gram = X @ X.T

        # (2) 反复选取训练样本
        for epoch in range(self.max_iter):
            errors = 0

            for i in range(n_samples):
                # sum(alpha_j * y_j * x_j · x_i) + b
                score = np.sum(
                    self.alpha * self.y_train * gram[:, i]
                ) + self.b

                # (3) 如果误分类,更新 alpha_i 和 b
                if y[i] * score <= 0:
                    self.alpha[i] += self.eta
                    self.b += self.eta * y[i]
                    errors += 1

            self.n_iter_ = epoch + 1

            # (4) 没有误分类点,训练结束
            if errors == 0:
                self.converged_ = True
                break

        return self

    def decision_function(self, X):
        X = np.asarray(X, dtype=float)
        gram = X @ self.X_train.T
        return gram @ (self.alpha * self.y_train) + self.b

    def predict(self, X):
        return np.where(self.decision_function(X) >= 0, 1, -1)