k近邻法
k 近邻法(k-nearest neighbor,k-NN)是一种基本的分类与回归方法。
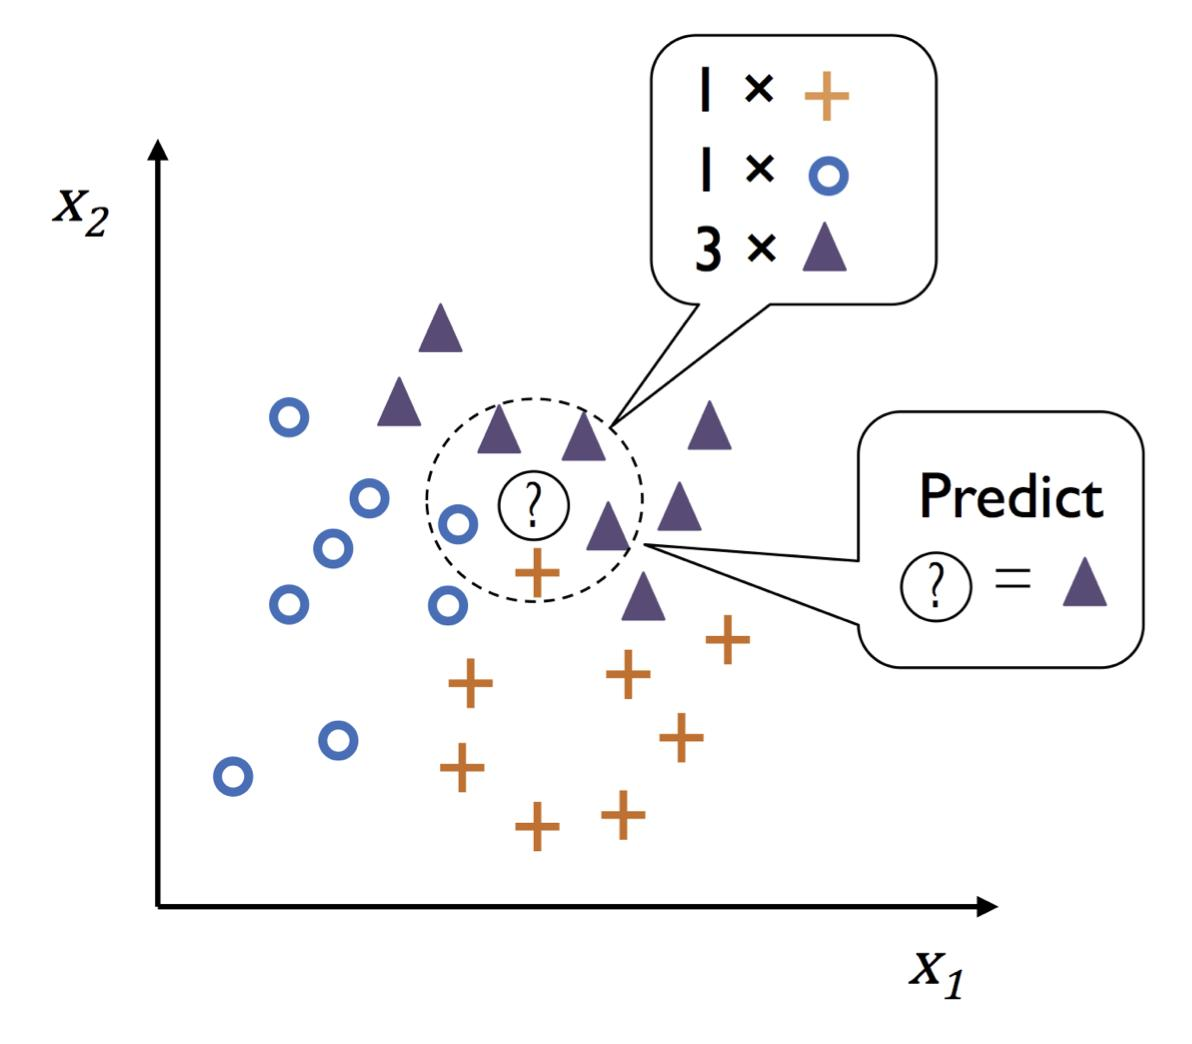
主要思想:假定给定一个训练数据集,其中实例标签已定,当输入新的实例时,可以根据其最近的 k 个训练实例的标签,预测新实例对应的标注信息。
- 分类问题:对新的实例,根据与之相邻的 k 个训练实例的类别,通过多数表决等方式进行预测。
- 回归问题:对新的实例,根据与之相邻的 k 个训练实例的标签,通过均值计算进行预测。
下面主要讨论分类问题
算法
输入:训练集:
T={(x1,y1),(x2,y2)⋯,(xN,yN)}
其中,xi∈X⊆Rn,y∈Y={c1,c2,⋯,cK},实例 x;
输出:实例 x 所属类别 y
-
根据给定的距离度量,计算 x 与 T 中点的距离;
-
在 T 中找到与 x 最邻近的 k 个点,涵盖这 k 个点的 x 的邻域记作 Nk(x);
-
在 Nk(x) 中根据分类决策规则(如多数表决)决定 x 的类别 y。
y=argmaxcjxi∈Nk(x)∑I(yi=cj),i=1,2,⋯,N; j=1,2,⋯,K
k近邻法的三要素
距离
Lp 距离:
特征空间 X 假设为 Rn,∀xi,xj∈X,xi=(xi(1),xi(2),⋯,xi(n))T,xj=(xj(1),xj(2),⋯,xj(n))T,则有
Lp(xi,xj)=(l=1∑nxi(l)−xj(l)p)p1,p≥1
L2(xi,xj)=(l=1∑nxi(l)−xj(l)2)21
- 曼哈顿距离(Manhattan distance)
L1(xi,xj)=l=1∑nxi(l)−xj(l)
- 切比雪夫距离(Chebyshev distance)
L∞(xi,xj)=lmaxxi(l)−xj(l)
k值的选取
- 较小的 k 值,学习的近似误差减小,但估计误差增大,敏感性增强,而且模型复杂,容易过拟合
- 较大的 k 值,减少学习的估计误差,但近似误差增大,而且模型简单
注:k 的取值可通过交叉验证来选择,一般低于训练集样本量的平方根。
分类决策规则
多数表决规则:由输入实例的 k 个邻近的训练实例中的多数类决定输入实例的类。
f:Rn→{c1,c2,⋯,cK}
L(Y,f(X))={1,0,Y=f(X)Y=f(X)
P(Y=f(X))=1−P(Y=f(X))
给定实例 x∈X,相应的 k 邻域 Nk(x),类别为 cj,误分类率
k1xi∈Nk(x)∑I(yi=cj)=1−k1xi∈Nk(x)∑I(yi=cj)
最小化误分类率,等价于
argcjmaxxi∈Nk(x)∑I(yi=cj)