目录108
- 卸载 MySQL
- 安装 MySQL
- MSI Installer
- ZIP Archive
- 用户登录与设置密码
- 登录 MySQL
- 设置密码
- 导入数据
- 设置环境变量
- 常用图形化工具
- Navicat
- DBeaver
- 数据库操作
- 创建、查看、选择、删除数据库
- 语法与注释说明
- 数据表操作
- 创建数据表
- 查看数据表
- 修改数据表
- 查看表结构
- 修改表结构
- 删除数据表
- 数据操作
- 添加数据
- 查询数据
- 修改数据
- 删除数据
- 数据类型
- 数字类型
- 时间和日期类型
- 字符串类型
- 表的约束
- 默认约束
- 非空约束
- 唯一约束
- 主键约束
- 字符集与校对集
- 字符集
- 校对集
- 字符集和校对集的设置
- 数据库设计范式
- 第一范式(1NF)
- 第二范式(2NF)
- 第三范式(3NF)
- 数据建模工具
- 复制表结构和数据
- 复制已有的表结构
- 创建表时复制数据
- 复制已有数据
- 解决主键冲突
- 清空数据
- 去除重复数据
- 排序和限量
- 排序
- 限量
- 分组与聚合函数
- 分组
- 聚合函数
- 运算符
- 算术运算符
- 比较运算符
- CASE 表达式
- IF() 函数
- 逻辑运算符
- 赋值运算符
- 位运算符
- 运算符优先级
- 多表查询
- 联合查询
- 连接查询
- 子查询
- 子查询分类
- 语句运行顺序
- 子查询关键字
- 公共表表达式 CTE
- 外键约束
- 添加外键约束
- 查看外键约束
- 删除外键约束
- 视图
- 内置函数
- 数学函数
- 数据类型转换函数
- 字符串长度与统计
- 字符串大小写转化
- 字符串拼接与重复
- 字符串截取与填充
- 字符串替换与插入
- 字符串修剪与反转类
- 字符串的比较
- 字符串的 ASCLL 码
- 字符串其它函数
- 获取当前时间和日期
- 日期与时间提取
- 日期时间的运算
- 获取特定日期信息
- UNIX 时间戳获取和转换
- 日期格式的转化
- 窗口函数
- 窗口函数:排名
- 窗口函数:聚合
- 窗口函数 :偏移
- 窗口函数:首尾值
- 窗口框架 Frame 子句
- 加密和散列函数
- 系统信息函数
- JSON 函数
- 自定义函数
MySQL
环境搭建与配置
卸载 MySQL
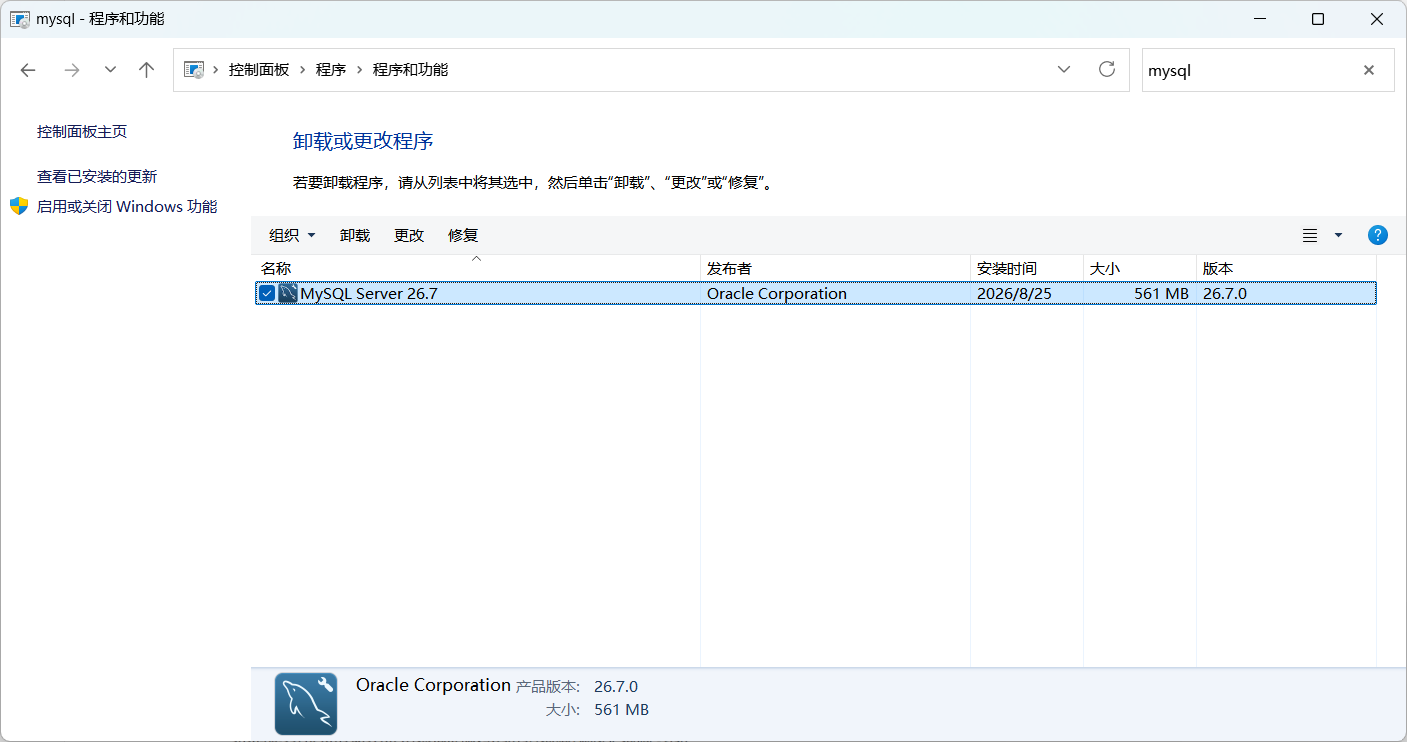
第一步:打开设置,搜索控制面板,找到程序和功能并进入,将有关 MySQL 的软件全部卸载。
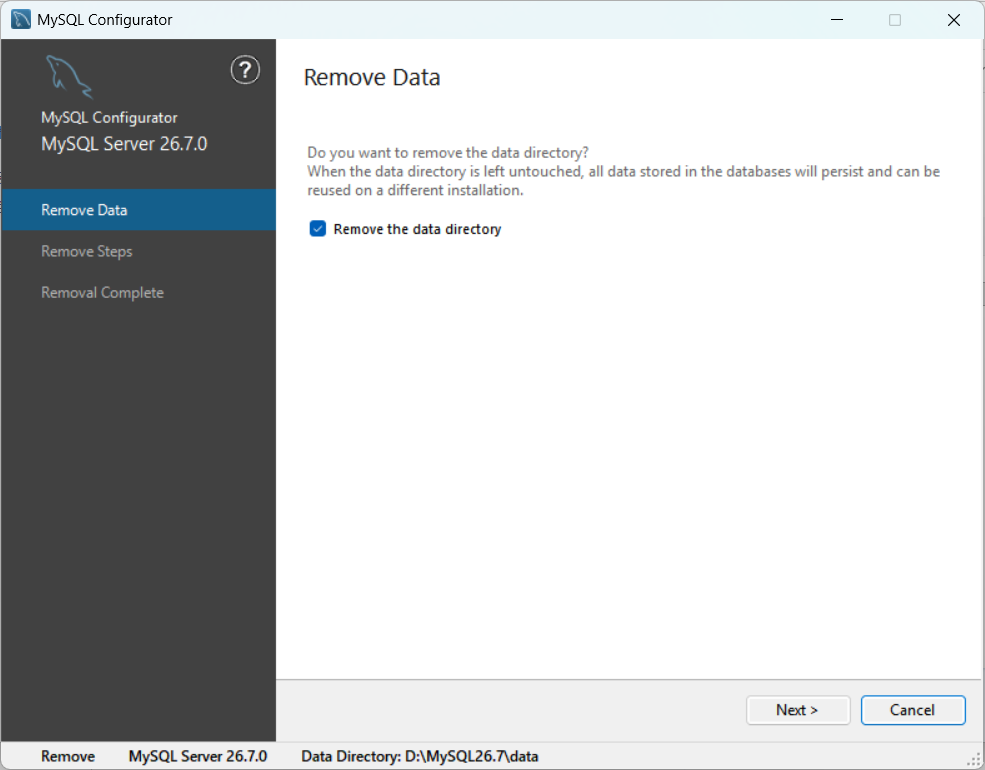
选择是否删除数据目录 -> next -> 执行 -> finish。
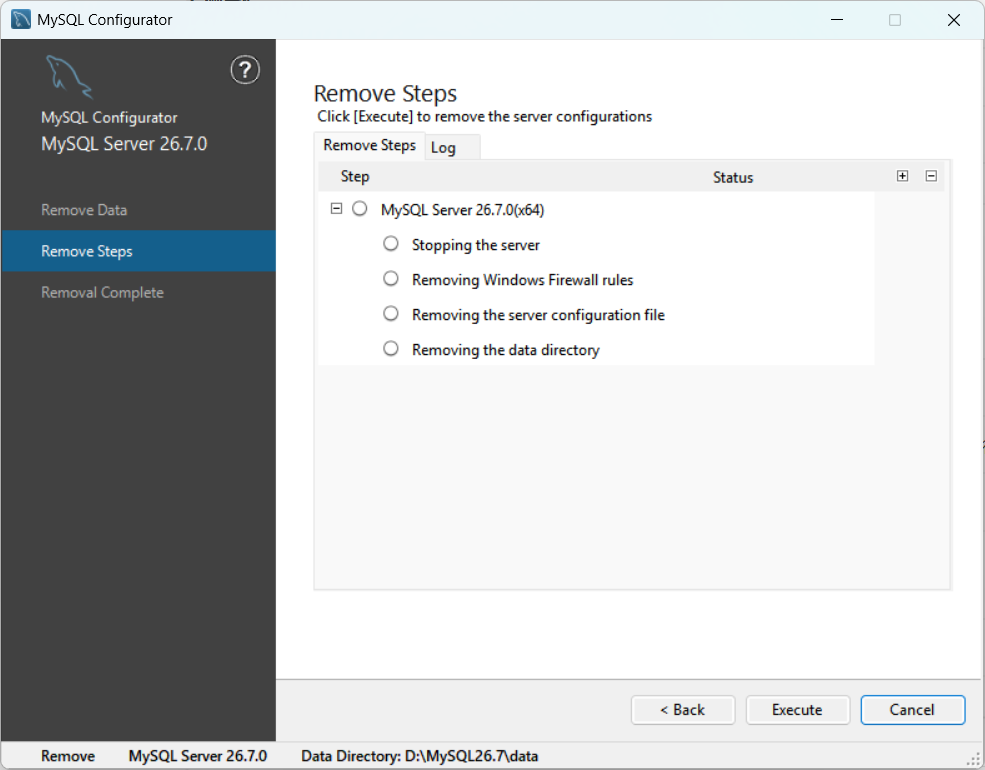
| 步骤 | 含义 |
|---|---|
| Stopping the server | 停止当前正在运行的 MySQL 服务 |
| Removing Windows Firewall rules | 移除之前在防火墙中添加的 3306 端口放行规则 |
| Removing the server configuration file | 删除 MySQL 的配置文件(my.ini) |
| Removing the data directory | 删除整个数据目录 |
| MySQL Server 26.7.0 (x64) | 整体移除 MySQL 服务器程序文件 |
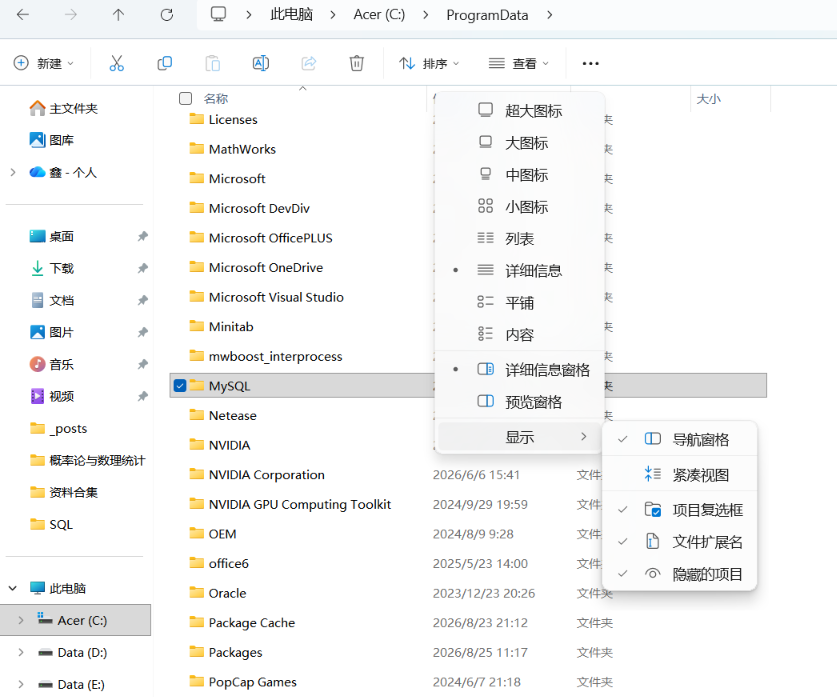
第二步:快捷键 Win+E 打开资源管理器,点击查看,勾选隐藏的项目,然后点击 C 盘下刚出现的 ProgramData,找到里面的 MySQL 文件夹右击删除。
在开始菜单下搜索服务,双击打开后找到 MySQL 停止此服务。再按快捷键 Win+R,输入 cmd 点击确认,输入 sc delete mysql 删除服务(如果显示拒绝访问,请以管理员身份打开终端)。
第三步:快捷键 Win+R,输入 regedit 打开注册表编辑器,在访问栏粘贴地址:
计算机\HKEY_LOCAL_MACHINE\SYSTEM\ControlSet001\Services\Eventlog\Application看看里面有没有 MySQL 和 MySQLD Service 两个文件夹,有的话都删除。再次在访问栏粘贴地址:
计算机\HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\Eventlog\Application同样看看里面有没有 MySQL 和 MySQLD Service 两个文件夹,有的话也都删除。
安装 MySQL
进入官方地址 https://www.mysql.com,点击 download。
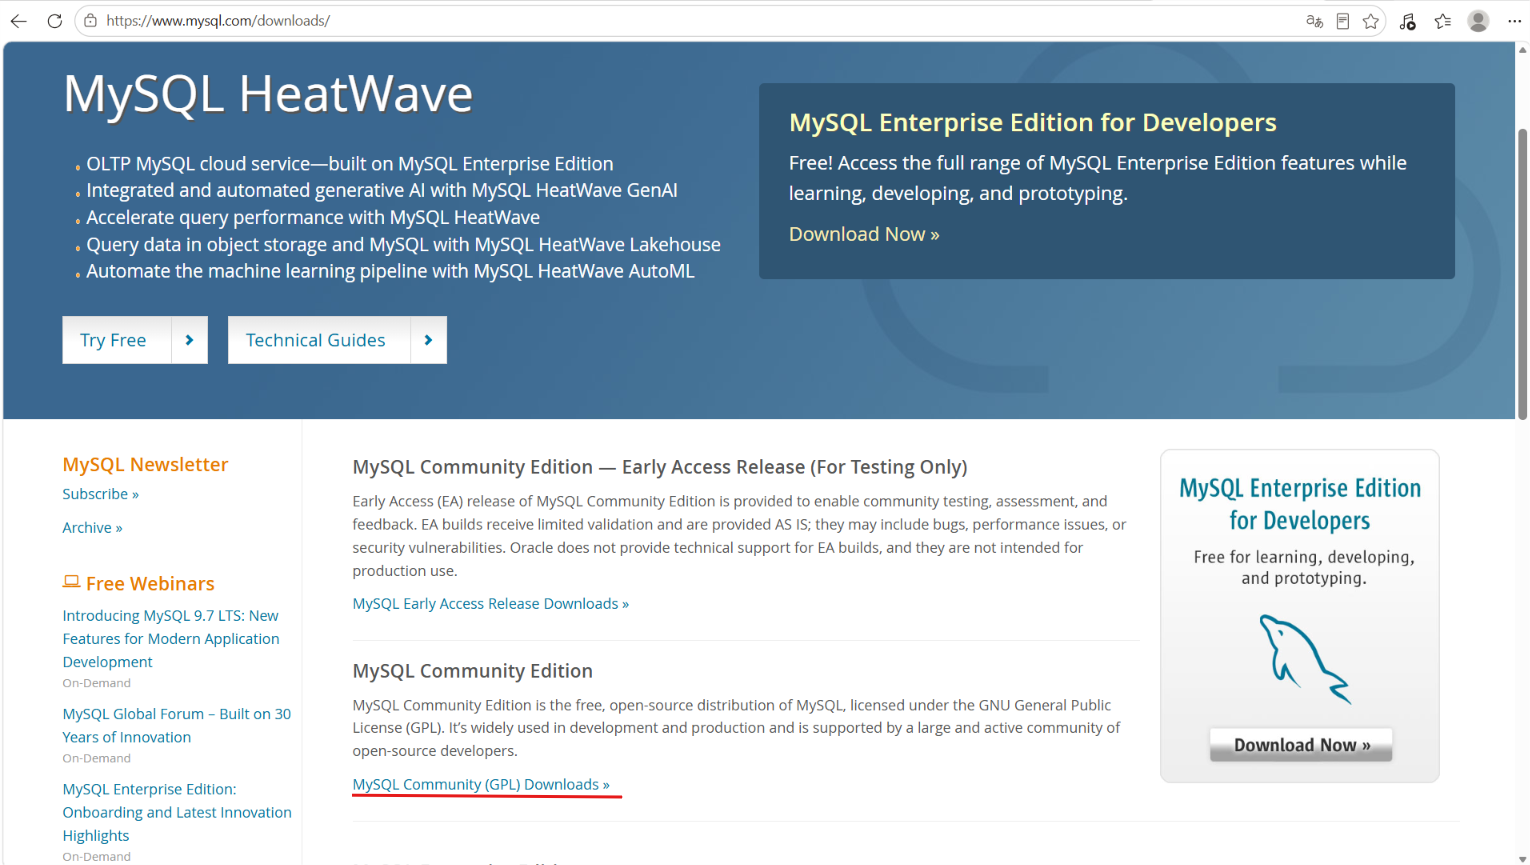
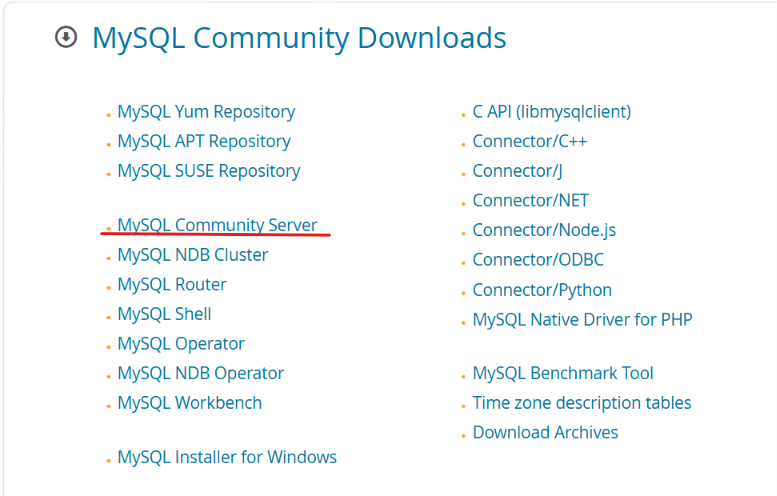
左侧是正式发布版本,右侧是历史版本。在正式发布版本中,Select Version 默认选择最新的创新版本,另外有 LTS 长期支持版(经过充分测试,更稳定,但更新较慢)。
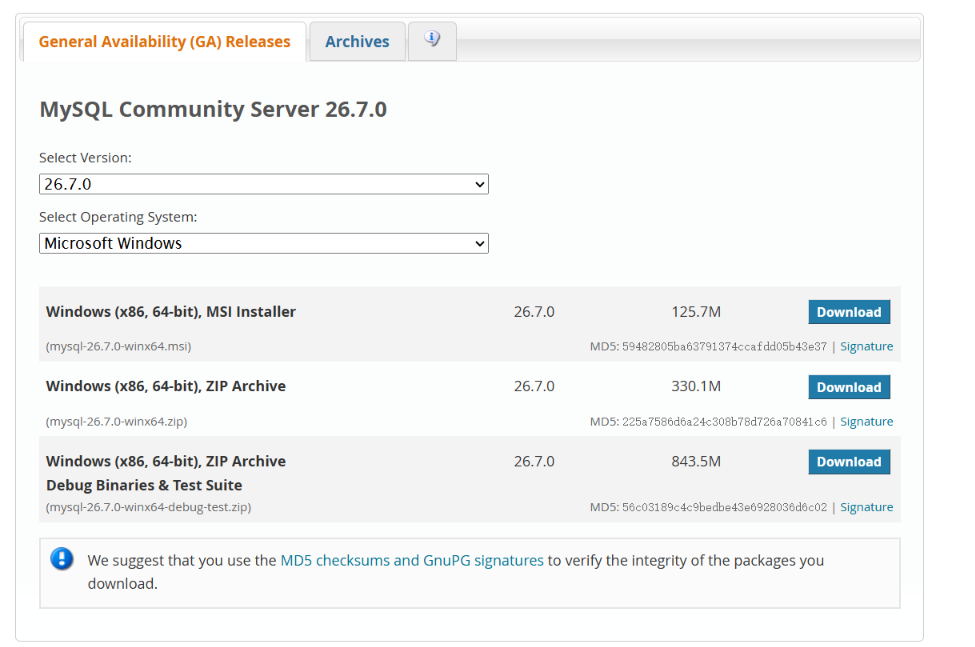
有三种下载方式:
| 版本类型 | 主要特点 |
|---|---|
| MSI Installer | 图形化安装向导,引导配置 root 密码、端口、服务名。一切全自动。 |
| ZIP Archive | 手动解压,需自己创建 my.ini、初始化 data 目录、安装服务。 |
| Debug & Test Suite | 包含 调试符号 和 测试套件,用于定位 MySQL 底层 Bug 或开发插件。 |
下面演示 MSI Installer 和 ZIP Archive 两种方式。
MSI Installer
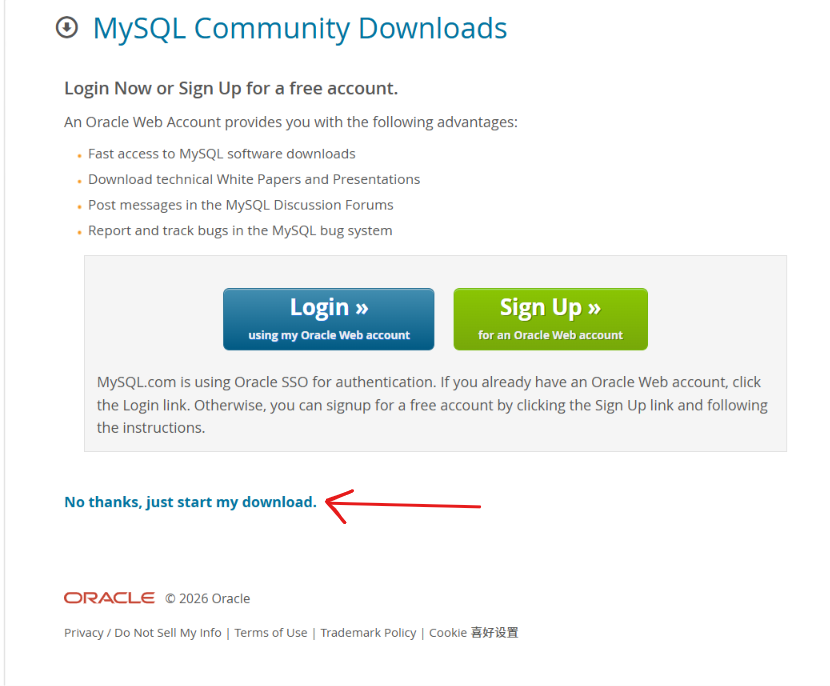
点击 Download,然后不注册直接下载。
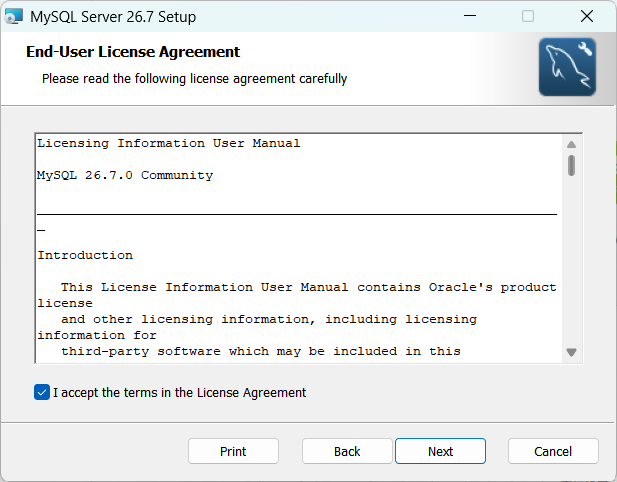
进入安装向导界面,next -> 接受协议 -> next。
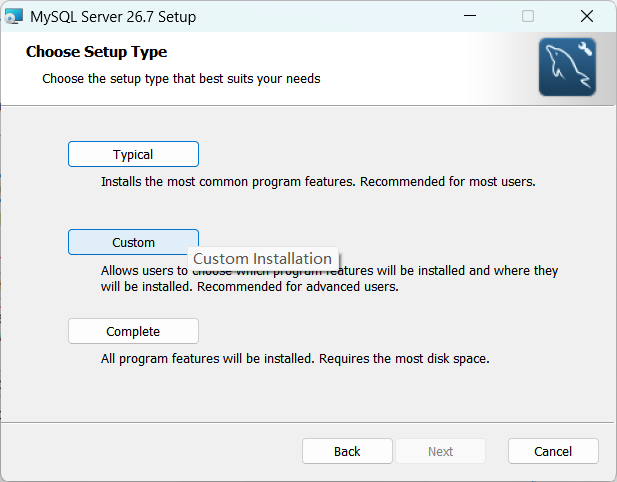
选择自定义安装,几种方式区别如下:
| 安装类型 | 含义 |
|---|---|
| Typical(典型安装) | 只安装 MySQL 服务器、MySQL 命令行客户端和命令行实用程序。 |
| Custom(自定义安装) | 自定义安装的软件和安装路径。 |
| Complete(完全安装) | 安装软件包内所有组件。 |
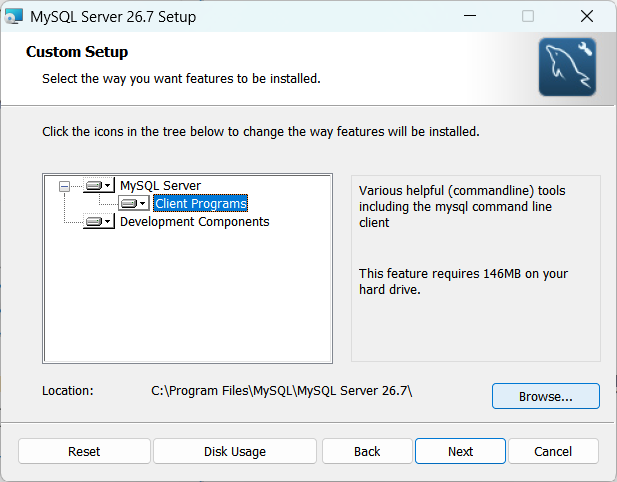
自定义安装目录 -> next -> Install -> Finish。
安装完成后进入配置向导界面,点击 next。
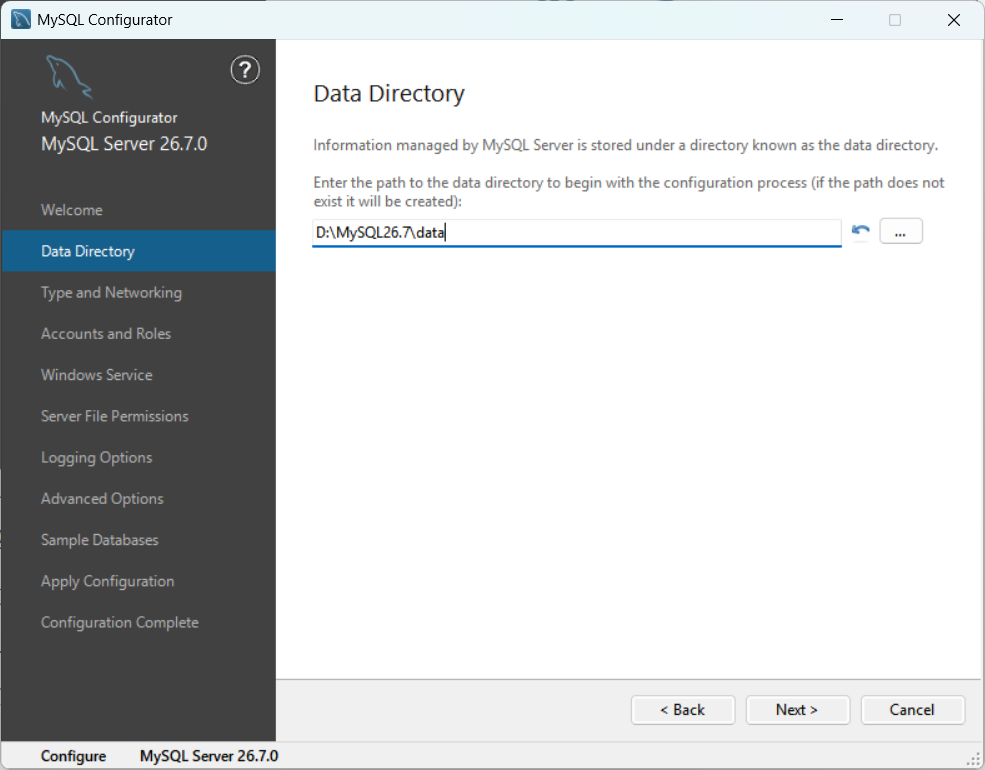
这是 MySQL 存放所有数据库文件的文件夹,包括:
- 你创建的每个数据库(表、索引等数据文件)
- MySQL 系统表(存储用户权限、元数据等)
- 日志文件(错误日志、查询日志等)
这里我修改文件夹位置为:
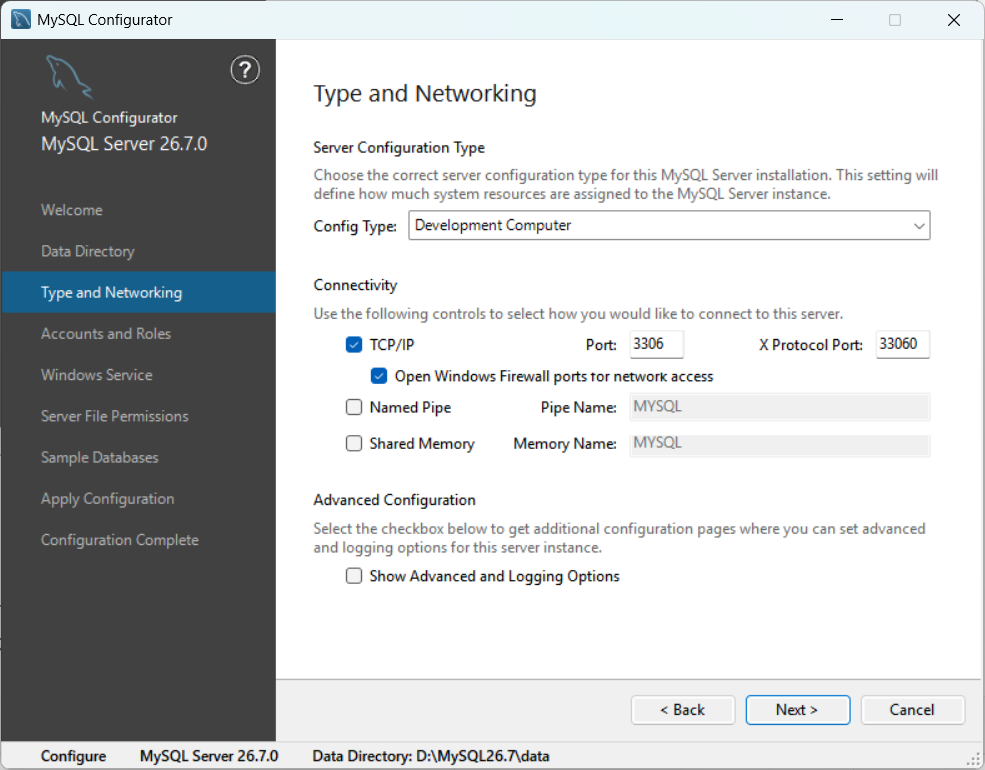
这一页一般保持默认即可,具体说明如下。
Server Configuration Type(服务器配置类型),这是一个下拉菜单,通常有三个选项:
| 选项 | 适用场景 |
|---|---|
| Development Computer(开发机) | 本地开发、学习测试 |
| Server Computer(服务器) | 作为 Web 服务器配套使用 |
| Dedicated Computer(专用服务器) | 整台机器只跑 MySQL |
如果是个人电脑学习用,保持 Development Computer 即可。
Connectivity(连接配置):
| 项目 | 含义 | 建议 |
|---|---|---|
| TCP/IP | 网络协议连接,允许本地和远程访问 | ✅ 保持勾选 |
| Port 3306 | MySQL 默认端口 | 保持 3306,除非有其他 MySQL 占用 |
| X Protocol Port 33060 | MySQL 8.0+ 的新协议端口 | 保持默认即可 |
| Open Windows Firewall ports | 防火墙放行端口 | ✅ 建议勾选,避免连接被拦截 |
| Named Pipe / Shared Memory | Windows 本地进程间通信 | 保持默认,一般用不到 |
Show Advanced and Logging Options(高级选项):勾选后会出现额外的配置页面,保持默认即可。
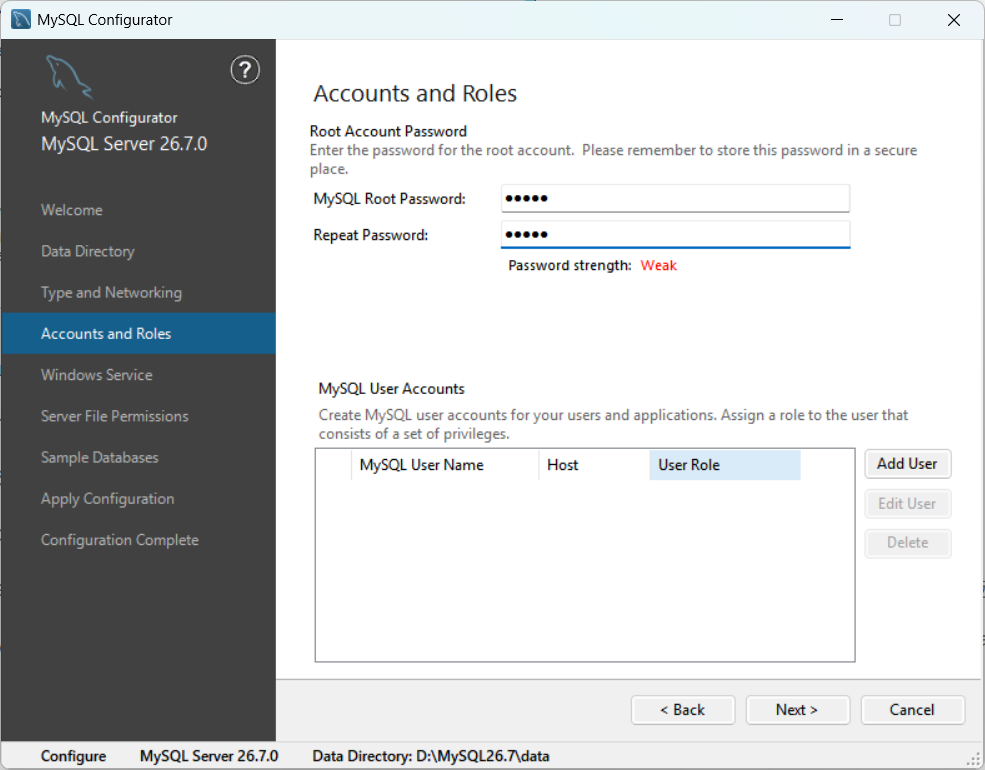
Root Account Password(设置 root 密码):这里我将密码设置为 admin。
root 是 MySQL 的超级管理员账户,拥有最高权限(创建数据库、管理用户、修改配置等)。
- MySQL Root Password:输入你的密码。
- Repeat Password:再次输入确认。
MySQL User Accounts(其他用户账户):这一部分可以添加普通用户,用于不同的应用程序或开发人员。
- Add User:添加一个新用户。
- Edit User:修改已有用户的权限或密码。
- Delete:删除一个用户。
这里先不添加其他用户。
-
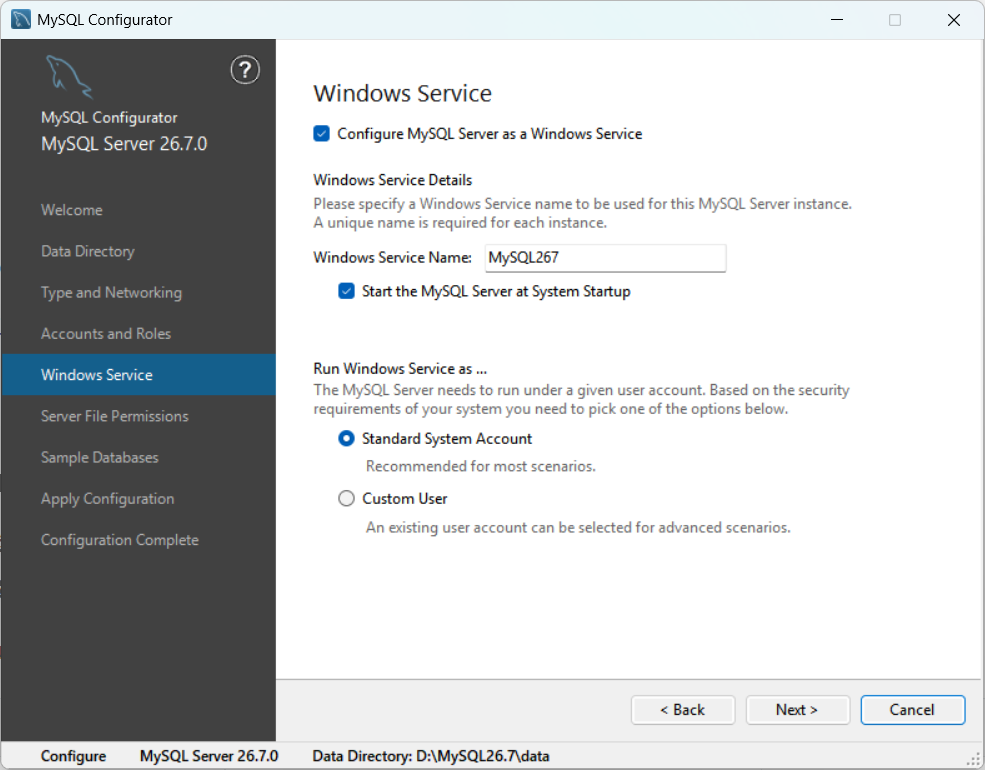
Windows Service Name(服务名称)
- 默认生成为
MySQL267(基于版本号 26.7),这是 MySQL 在 Windows 服务列表中的唯一标识名。保持默认即可。如果以后安装多个版本,不同名称能帮助区分。
- 默认生成为
-
Start the MySQL Server at System Startup(开机自启动)
-
Run Windows Service as …(运行身份)
-
Standard System Account : MySQL 使用 Windows 内置的
NT SERVICE\MySQL账号运行,权限受限但安全,绝大多数情况,推荐选择 -
Custom User:指定一个已有的 Windows 用户账户来运行 MySQL ,特殊需求,例如需要访问网络共享目录等高级场景
建议保持默认勾选 Standard System Account 即可。
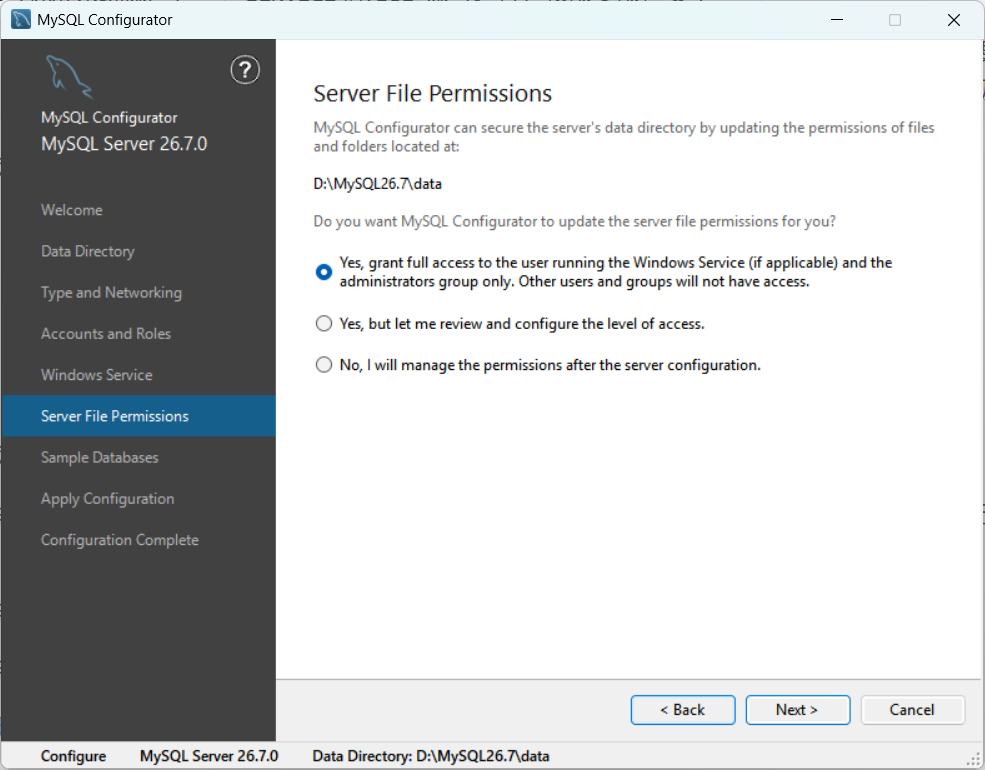
这里保持默认即可:
- 选项 1:安装程序自动设置权限,仅允许 MySQL 服务账户和 Windows 管理员组访问该目录,其他用户无法访问。
- 选项 2:安装程序帮你配置,但允许你手动调整具体的访问级别(读写/只读等)。
- 选项 3:安装程序不做任何权限设置,安装完成后由你自己手动管理。
MySQL 的数据目录(
data文件夹)包含:
- 所有数据库的物理文件(
.ibd、.frm等)- 系统表文件(用户权限、元数据等)
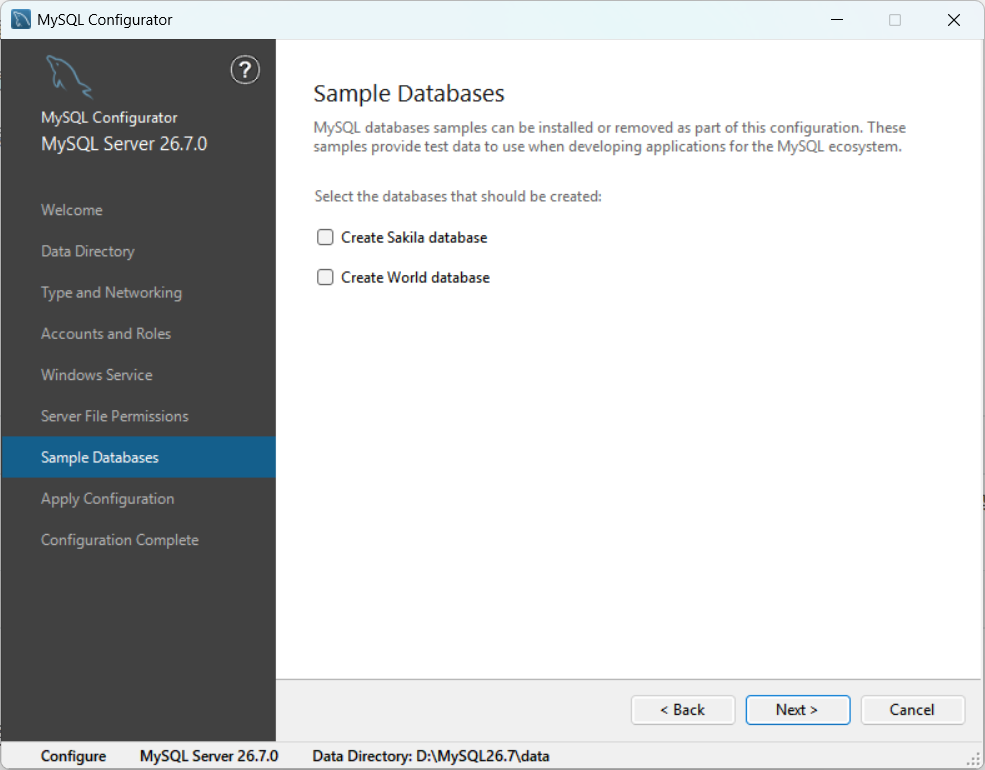
如果有需要可以勾选相应示例数据库,也可以不安装,后续可导入。
| 项目 | 含义 |
|---|---|
| Sakila | 一个经典的 DVD 租赁店数据库模型,包含电影、演员、客户、租赁记录等表,适合练习复杂查询和联结操作 |
| World | 一个简单的世界城市/国家/语言数据库,包含国家、城市、官方语言等表,适合入门级练习 |
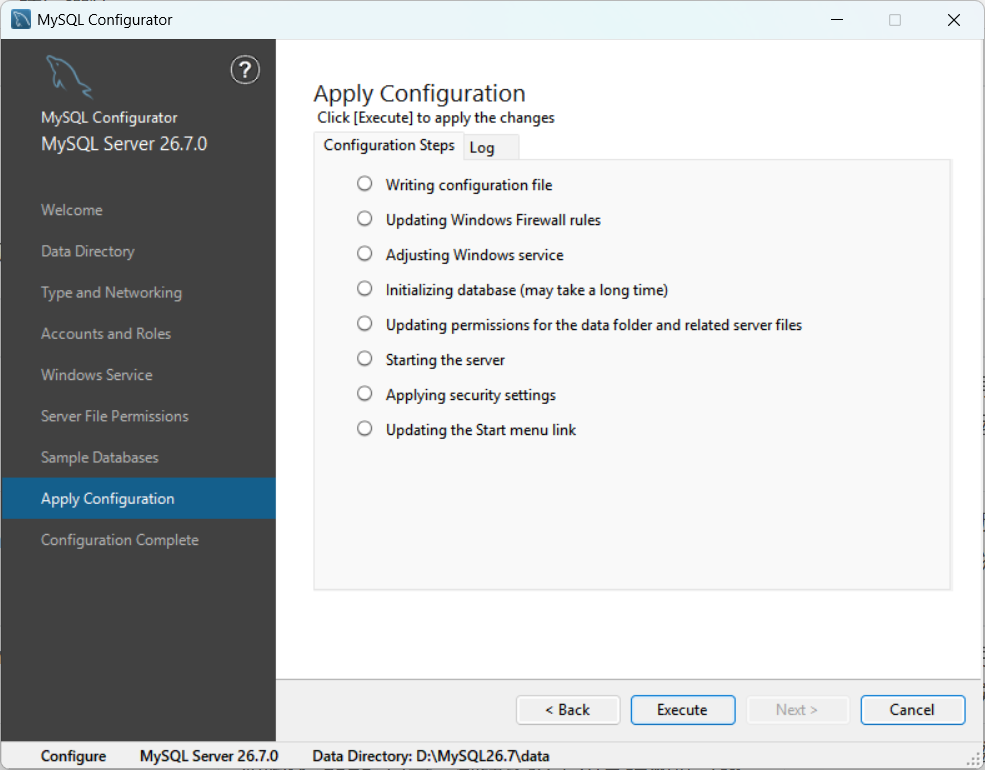
即将执行的 8 个步骤,点击 Execute 执行:
| 步骤 | 含义 | 可能遇到的问题 |
|---|---|---|
| Writing configuration file | 在 MySQL 安装目录下创建 my.ini 配置文件 |
目录权限不足会导致失败(一般管理员运行可避免) |
| Updating Windows Firewall rules | 在 Windows 防火墙中开放 3306 和 33060 端口 | 如果防火墙服务被禁用,此步骤可能跳过或警告 |
| Adjusting Windows service | 将 MySQL 注册为 Windows 系统服务(名称为你之前填的 MySQL267) |
如果同名服务已存在,会提示覆盖或冲突 |
| Initializing database | 初始化 data 目录,创建系统表和基础数据(这一步最耗时) |
目录权限不足、磁盘空间不足、路径无效可能导致失败 |
| Updating permissions for the data folder | 给 D:\MySQL26.7\data 文件夹设置访问权限(参考之前的 Server File Permissions 配置) |
一般不会失败 |
| Starting the server | 启动 MySQL 服务 | 端口被占用、配置文件语法错误会导致启动失败 |
| Applying security settings | 应用安全设置(比如你设置的 root 密码) | 网络问题可能导致连接验证超时,但很少见 |
| Updating the Start menu link | 在 Windows 开始菜单中添加快捷方式(MySQL Shell、MySQL 命令行客户端等) | 几乎不会失败 |
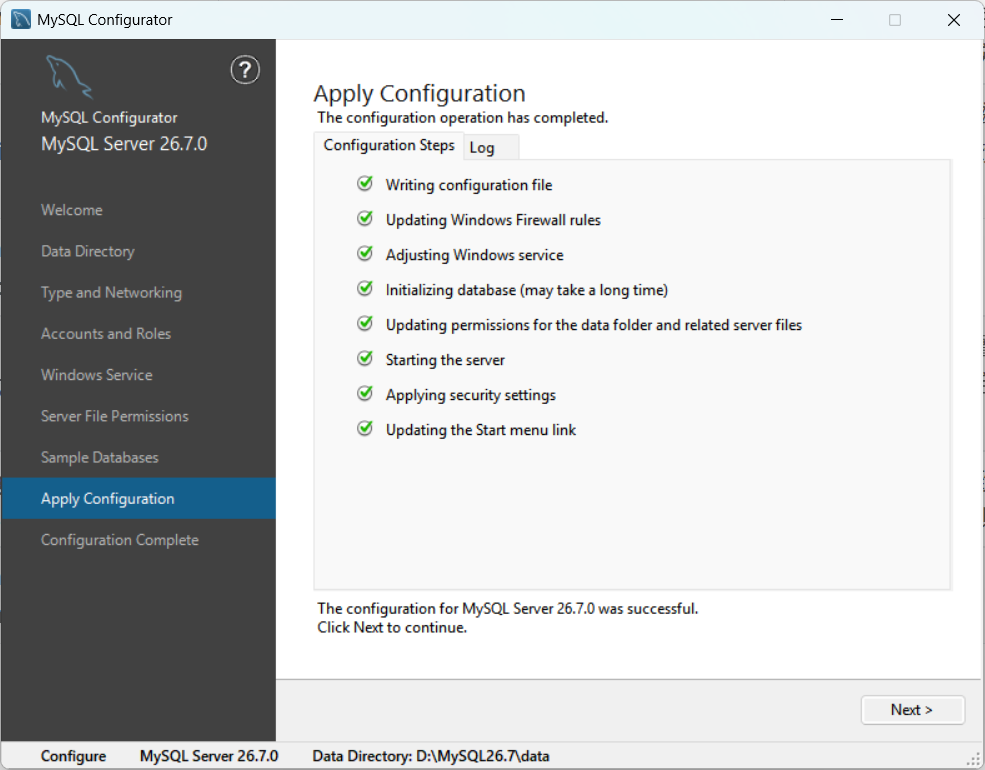
点击 next -> finish 完成安装。
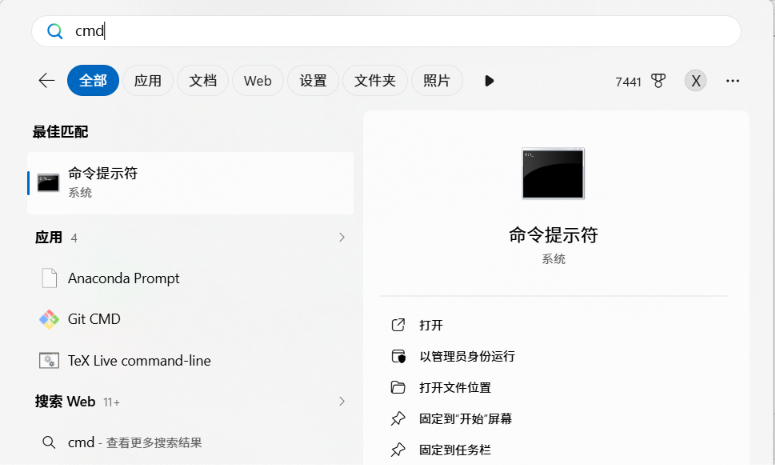
下面验证是否真的安装完成,以管理员身份打开命令提示符:
任意目录输入命令开启 MySQL 服务:
net start mysql267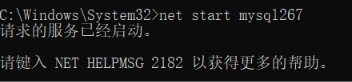
(前面勾选了 MySQL 会随 Windows 自动启动,因此这里显示已经启动了。)
ZIP Archive
Step 1:创建 D:\MySQL267 作为 MySQL 的安装目录,然后将 zip 压缩包解压到 D:\MySQL267 目录。
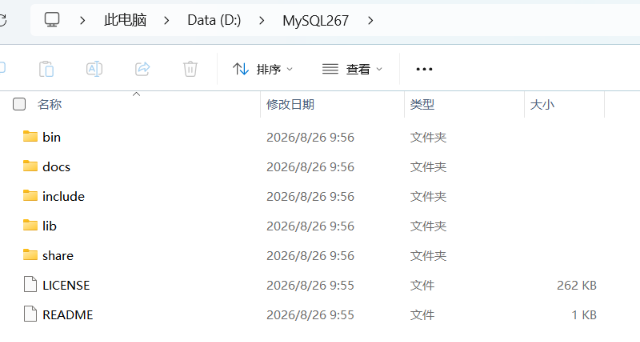
- bin:存放可执行文件,如 MySQL 服务程序
mysqld.exe、命令行客户端工具mysql.exe等。 - docs:存放相关文档,如
ChangeLog(版本更新日志)。 - include:存放头文件,如
mysql.h、mysql_version.h等(供 C/C++ 开发使用)。 - lib:存放一系列的库文件(供开发与程序链接使用)。
- share:存放字符集、语言等信息(错误信息、字符集配置等)。
- COPYING:GPL 开源协议文本文件。
- README:介绍版权、版本等基本信息。
Step 2:安装 MySQL,指将 MySQL 安装为 Windows 系统的服务,具体步骤如下。
在计算机中,服务是一种长时间运行的应用程序,多个服务用不同的端口来区分。
(1)在【命令提示符】右击,在弹出的快捷菜单中选择【以管理员身份运行】方式,启动命令行窗口。
(2)在命令模式下,切换到 MySQL 安装目录下的 bin 目录。
D:cd D:\MySQL267\bin如果安装目录包含空格,可以使用:
cd "yourpath"(3)输入以下命令开始安装。
mysqld -install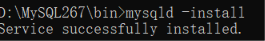
在安装 MySQL 时,还有一些常见的问题需要注意,具体如下。
(1)MySQL 安装的服务名默认为 “MySQL”,如果该名称已经存在,则会安装失败,提示 The service already exists!。此时可能是系统中已经安装了 MySQL,可以通过如下命令进行卸载,卸载后再进行安装。
mysqld -remove(2)MySQL 允许在安装或卸载时指定服务名称,从而实现多个 MySQL 服务共存,命令如下所示。
mysqld -install "服务名称"
mysqld -remove "服务名称"
例如,当需要同时安装 MySQL 26.7.0 和 8.0 时,分别指定不同的服务名称即可实现。
下面我将已经安装好的 MySQL 卸载,并重新安装指定服务名称为 mysql267:
mysqld -remove
mysqld -install "mysql267"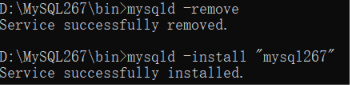
(3)MySQL 服务默认监听 3306 端口,如果该端口被其他服务占用,会导致客户端无法连接服务器。在命令行中可用 netstat -ano 命令查看端口占用情况。
例如:PID 为 4204 的进程正在监听本地地址的 3306 端口,为了获知该进程是哪一个程序,执行 tasklist | findstr "4204" 命令。如果当前是 mysqld.exe 占用了 3306 端口,说明 MySQL 服务正在工作;如果是其他程序占用了 3306 端口,只需将对应的服务停止即可。
Step 3:配置 MySQL。
创建 MySQL 配置文件:使用文本编辑器(如记事本)创建配置文件 D:\mysql267\my.ini,在配置文件中编写如下配置。
[mysqld]
basedir=D:/mysql267
datadir=D:/mysql267/data
port=3306
basedir 表示 MySQL 的安装目录,datadir 表示数据库文件的保存目录,port 表示 MySQL 服务的端口号。
在没有配置文件的情况下,MySQL 会自动检测安装目录、数据文件目录。但由于不同 MySQL 版本的路径可能有区别,所以建议通过配置文件来指定。另外,Linux 系统中通常使用 my.cnf 作为配置文件的文件名,在 Windows 系统中也可以使用该文件名。
初始化数据库:
MySQL 部分版本中已经提供了 data 目录,不需要初始化数据库。
创建 my.ini 配置文件后,数据库文件目录 D:/mysql267/data 还没有创建。接下来需要通过 MySQL 的初始化功能,自动创建数据文件目录,具体命令如下。
mysqld --initialize-insecure
--initialize表示初始化数据库,--insecure表示忽略安全性。当省略--insecure时,MySQL 将自动为默认用户 root 生成一个随机的复杂密码;加上--insecure时,root 用户的密码为空。由于自动生成的密码输入比较麻烦,因此这里选择忽略安全性。关于密码的设置会在后面进行具体讲解。
Step 4:管理 MySQL 服务。
MySQL 安装完成后,需要启动服务进程,否则客户端无法连接数据库。在前面的配置过程中,已经将 MySQL 安装为 Windows 服务。为了控制 MySQL 服务的启动与停止,可以通过两种方式来实现。
方式 1:通过命令行管理 MySQL 服务
使用管理员身份打开命令提示符,输入如下命令启动和终止名称为 MySQL267 的服务。
net start MySQL267
---
mysql267 服务正在启动 .
mysql267 服务已经启动成功。
---

net stop MySQL267
---
mysql267 服务正在停止.
mysql267 服务已成功停止。
---
MySQL 服务启动失败(来自某次失败的经历):
用记事本打开 data -> 电脑名.err,发现如下两个问题:
问题一:my.ini 配置文件里写了一个错误的参数:data=...,将 data 修改为 datadir 即可。
- 修正
my.ini:把data=改成datadir=。 - 以管理员身份打开 CMD,进入
D:\SQL\bin。 - 移除旧服务:
mysqld -remove MySQL。 - 删除旧的 data 文件夹:
rmdir /s D:\SQL\data。 - 重新安装服务:
mysqld -install MySQL。 - 重新初始化:
mysqld --initialize-insecure。 - 启动服务:
net start MySQL。
问题二:电脑上已经有另一个 MySQL 服务在运行,占用了 3306 端口,导致新服务无法启动。
方法 1:关闭已有的 MySQL 服务。
- 以管理员身份打开命令提示符。
- 查看正在运行的 MySQL 服务:
sc query | findstr MySQL。 - 停止它:
net stop MySQL(如果服务名不是 MySQL,换成实际名字,比如 MySQL80 或 MySQL57)。 - 然后重新启动你的服务:
net start MySQL。
方法 2:修改端口号(让多个 MySQL 共存)。如果希望保留原有的 MySQL 服务,可以让你新安装的 MySQL 使用其他端口:打开 D:\SQL\my.ini,找到 port=3306,改成其他端口,例如 3307。以后连接时需要指定端口:mysql -u root -p -P 3307。
方式 2:通过 Windows 服务管理器管理 MySQL 服务
通过 Windows 的服务管理器可以查看 MySQL 服务是否开启。在命令提示符中输入如下命令,就会打开 Windows 的服务管理器,点击标准,找到 mysql267。
services.msc可以直接双击 MySQL 服务项打开属性对话框,通过单击“启动”按钮修改服务的状态(当前显示关闭)。
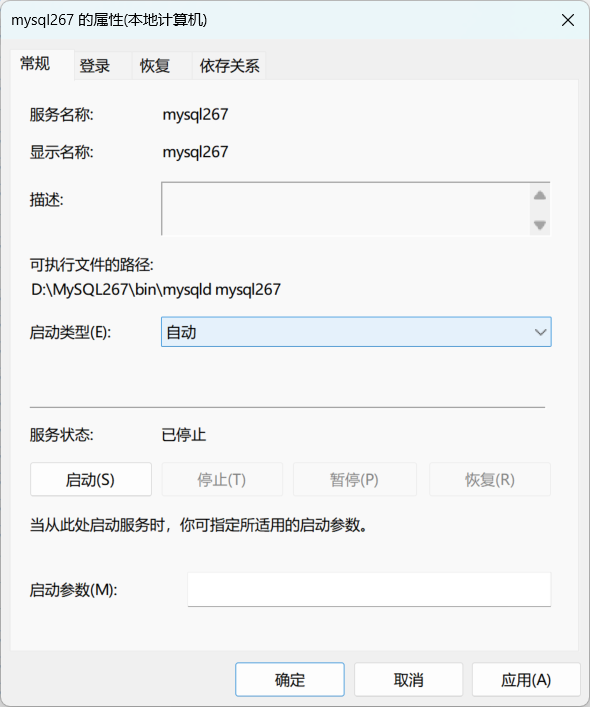
此外还有一个启动类型的选项,该选项有 3 种类型可供选择,具体如下(在 MSI 安装时也遇到过)。
(1)自动:通常与系统有紧密关联的服务才必须设置为自动,它会随系统一起启动。
(2)手动:服务不会随系统一起启动,直到需要时才会被激活。
(3)禁用:服务将不能启动。
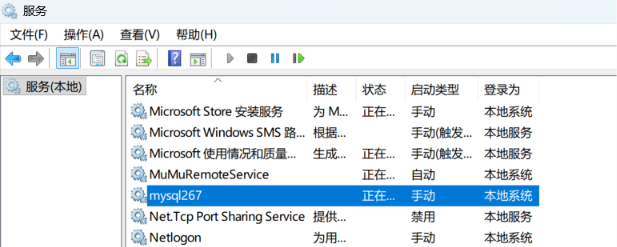
这里我开启服务并设置为手动:
用户登录与设置密码
登录 MySQL
在 MySQL 的 bin 目录中,mysql.exe 是 MySQL 提供的命令行客户端工具,用于访问数据库。该程序不能直接双击运行,需要打开命令行窗口,切换到 bin 工作目录:
D:cd D:\MySQL267\bin然后执行如下命令登录 MySQL 服务器。
mysql -u root在上述命令中,
mysql表示运行当前目录下的 mysql.exe;-u root表示以 root 用户的身份登录,其中-u和root之间的空格可以省略。
如果需要退出 MySQL,可以直接使用 exit 或 quit 命令。
exitquit命令行客户端工具还有一些常用选项。其中 -h 用于指定登录的 MySQL 服务器地址(域名或 IP),如 -h localhost 或 -h 127.0.0.1 表示登录本地服务器。选项 -P(必须用大写字母 P)用于指定连接的端口号,如 -P 3306 表示连接 3306 端口。
设置密码
为了保护数据库的安全,需要为登录 MySQL 服务器的用户设置密码。下面以设置 root 用户的密码为例,登录 MySQL 后,执行如下命令即可。
ALTER USER 'root'@'localhost' IDENTIFIED BY 'admin';上述命令表示为 localhost 主机中的 root 用户设置密码,密码为 “admin”。当设置密码后,退出 MySQL,然后重新登录时,就需要输入刚才设置的密码。
在登录有密码的用户时,需要使用的命令如下。
mysql -uroot -padmin-padmin 表示使用密码 “admin” 进行登录。如果在登录时不希望密码被直接看到,可以省略 -p 后面的密码,然后按回车键,会提示输入密码。
在设置密码后,如果需要取消密码,可以使用如下命令。
ALTER USER 'root'@'localhost' IDENTIFIED BY '';上述命令将密码设为空,即可免密码登录。
导入数据
MySQL 导入数据是将外部数据文件(如 CSV、TXT 等)加载到数据库表中的过程。所有命令基于 MySQL 8.0+ 版本。
常用的图形化操作工具都提供了导入数据功能,更方便
在导入前,确保:
- 数据文件格式正确:如 CSV 文件使用逗号分隔字段,每行以换行符结束。
- 目标表已创建:表结构与数据文件列匹配。
- 文件路径可访问:MySQL 需有权限读取文件(本地文件需启用
local_infile参数)。 - 备份数据:防止意外覆盖。
方法 1:使用 LOAD DATA INFILE 命令
这是最快速的方法,直接从文件加载到表。
LOAD DATA INFILE '文件路径'
INTO TABLE 表名
FIELDS TERMINATED BY '分隔符'
ENCLOSED BY '引号字符'
LINES TERMINATED BY '行结束符'
IGNORE 1 LINES; -- 忽略标题行
FIELDS TERMINATED BY:字段分隔符(如','为 CSV)。ENCLOSED BY:字段包围符(如'"')。LINES TERMINATED BY:行结束符(如'\n')。IGNORE n LINES:跳过前 n 行(常用于跳过标题)。
注意事项:
- 文件路径需绝对路径(如
/home/user/data.csv)。 - MySQL 需启用
local_infile:执行SET GLOBAL local_infile = 1;或修改配置文件。 - 权限问题:确保 MySQL 用户有
FILE权限。 - 错误处理:添加
IGNORE忽略无效行,或使用REPLACE覆盖重复记录。
SHOW VARIABLES LIKE 'local_infile';若为 OFF,执行:
SET GLOBAL local_infile = ON;确保客户端连接也启用了 LOCAL。你当前使用的是 MySQL 命令行客户端,必须在启动时加上 --local-infile=1 参数,而不是在进入客户端后再设置。退出当前客户端,然后重新连接:
mysql -u 你的用户名 -p --local-infile=1连接成功后,再执行导入。
设置环境变量
在启动 MySQL 客户端前,需要确保命令提示符当前位于 bin 目录;如果在其他目录,则需要通过 cd 命令切换目录。这样操作比较麻烦,可以在命令行中执行如下命令,将 MySQL 的 bin 目录添加到环境变量中。
setx PATH "%PATH%;D:\MySQL267\bin"执行上述命令后,关闭当前命令行窗口,重新打开一个新的命令行窗口即可生效。
当 PATH 变量值超过 1024 个字符时,会被自动截断。如果你电脑的 PATH 本身就比较长,可能会超出限制。
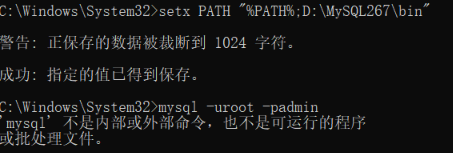
这时可以手动添加:
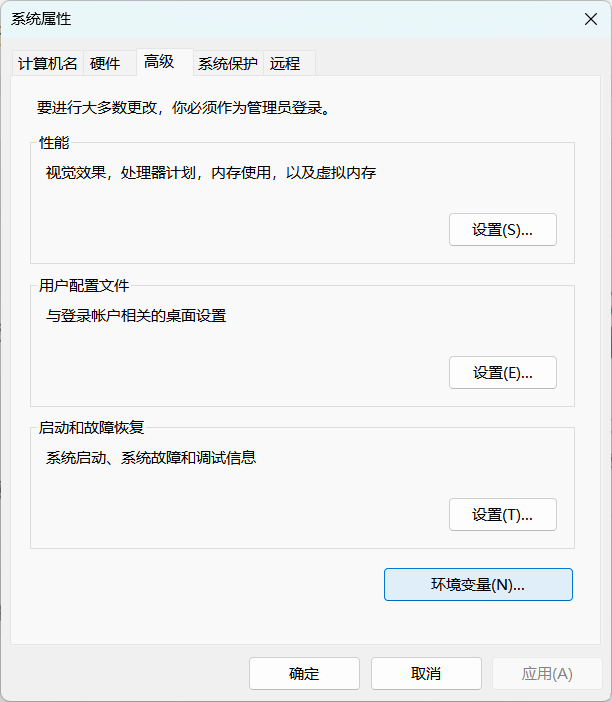
用户变量只对当前用户生效,系统变量是对所有用户都生效。如果你的电脑只有一个自己用的账户,建议都设置在系统变量下即可。
双击系统变量窗口中的 Path,弹出窗口,点击浏览,选择要添加的文件夹位置,依次确认即可。
这时即便在其它目录也能运行:
常用图形化工具
MySQL 命令行客户端的优点在于不需要额外安装,在 MySQL 软件包中已经提供。然而命令行这种操作方式不够直观,而且容易出错。为了方便地操作 MySQL,可以使用一些图形化工具。
Navicat
官网:https://www.navicat.com.cn/
产品 -> 翻到最下面有一个免费版,下载 -> 安装注册账号登录 -> 文件 -> 新建连接 -> MySQL -> 输入相应连接信息后确认。
单击工具栏中新建查询即可执行 SQL。
DBeaver
免费的通用数据库客户端,支持 MySQL、PostgreSQL、Oracle 等多种数据库。从 dbeaver.io 下载 Community 版安装,连接方式与 Navicat 类似:数据库 -> 新建连接 -> MySQL -> 填写主机、端口、用户名、密码 -> 测试连接。
基础 SQL 操作
数据库操作
创建、查看、选择、删除数据库
MySQL 中的数据库可以有多个,分别存储不同的数据。创建数据库的命令如下:
-- 创建数据库
CREATE DATABASE [IF NOT EXISTS] 数据库名 [库选项];
-- 查看所有数据库
SHOW DATABASES;
-- 删除数据库
DROP DATABASE [IF EXISTS] 数据库名称;- information_schema 和 performance_schema 数据库分别是 MySQL 服务器的数据字典(保存所有数据表和库的结构信息)和性能字典(保存全局变量等的设置);
- mysql 数据库主要负责 MySQL 服务器自己需要使用的控制和管理信息,如用户的权限关系等;
- sys 是系统数据库,包括存储过程、自定义函数等信息。
-- 显示创建 mydb 数据库的完整SQL 语句,以及数据库的默认字符集。
SHOW CREATE DATABASE 数据库名称;
MySQL 服务器中的数据需要存储到数据表中,数据表需要存储到对应的数据库下,并且 MySQL 服务器中可以存在多个数据库。因此在对数据和数据表进行操作时,首先需要选择数据库。
USE 数据库名;除了使用 USE 关键字外,在登录 MySQL 服务器时也可以直接选择要操作的数据库:
mysql -u 用户名 -p 密码 数据库名在登录密码后添加要选择的数据库名称,按回车键后,MySQL 会在登录服务器后自动选择要操作的数据库。例如,密码为 123456 的 root 用户登录后直接选择 mydb 数据库:
# 方式 1:登录时明文显示密码,直接选择数据库
mysql -uroot -p123456 mydb
# 方式 2:登录时隐藏密码,回车后再输入密码
mysql -uroot -p mydb语法与注释说明
注释
单行注释以 # 开始,也支持标准 SQL 的 --。但为了防止 -- 与 SQL 语句中负号和减法运算混淆,在第二个短横线后必须添加至少一个控制字符(如空格、制表符、换行符等)将其标识为单行注释符号。
# 此处填写单行注释内容,如:若服务器中没有 mydb 数据库,则创建,否则忽略此 SQL
CREATE DATABASE IF NOT EXISTS mydb;
-- 此处填写单行注释内容,如:若服务器中存在 mydb 数据库,则删除,否则忽略此 SQL
DROP DATABASE IF EXISTS mydb;
MySQL 也支持标准 SQL 的多行注释:
/*
此处填写多行注释内容
如:利用以下 SQL 查看当前服务器中的所有数据库
*/
SHOW DATABASES;
基本语法注意点
-
换行、缩进与结尾分隔符。MySQL 中的 SQL 语句可以单行或多行书写,多行书写时可以按回车键换行,每行中的 SQL 语句可以使用空格和缩进增强可读性。SQL 语句完成时通常使用分号(;)结尾;在命令行窗口中也可使用
\g结尾,效果与分号相同。此外,在命令行窗口中还可以使用\G结尾,如SHOW DATABASES\G会将显示结果以每条记录(一行数据)为一组,将所有字段纵向排列展示。 -
大小写问题。MySQL 的关键字在使用时不区分大小写,如 SHOW DATABASES 与 show databases 都表示获取当前 MySQL 服务器中有哪些数据库。另外,MySQL 中的所有数据库名称、数据表名称、字段名称默认情况下在 Windows 系统下都忽略大小写,在 Linux 系统下数据库与数据表名称则区分大小写,通常开发时推荐都使用小写。
-
反引号的使用。在项目开发中,为了避免用户自定义的名称与系统中的命令(如关键字)冲突,最好使用反引号(
`)包裹数据库名称、数据表名称和字段名称。反引号在键盘左上角 Tab 键的上方。
-- 错误写法(会报错):直接使用关键字作为表名和字段名
CREATE TABLE order ( id INT);
-- 加反引号
CREATE TABLE `order` ( id INT);
-- 以后对该表操作都要使用 `order`
数据表操作
创建数据表
在 MySQL 数据库中,所有数据都存储在数据表中。若要对数据进行添加、查看、修改、删除等操作,首先需要在指定的数据库中准备一张数据表。
-- 创建数据表
CREATE [TEMPORARY] TABLE [IF NOT EXISTS] 表名
    (create_definition,...)
[table_options]- 可选项 TEMPORARY 表示临时表,仅在当前会话中可见,并且在会话关闭时自动删除;
- “字段名”指的是数据表的列名;
- “字段类型”设置字段中保存的数据类型;
- 可选项“字段属性”指的是字段的某些特殊约束条件;
- 可选的“表选项”用于设置表的相关特性,如存储引擎(ENGINE)、字符集(CHARSET)和校对集(COLLATE)。
在操作数据表时,可以不使用 USE 选择数据库,而是将表名写成“数据库.表名”的形式,在任何数据库下访问其他数据库中的表。例如:
CREATE TABLE mydb.goods;命名数据表时,由于项目开发中同一个数据库可能被多个项目使用,为了避免数据重复,通常为数据表添加前缀用于区分不同的项目。前缀一般选取数据库的前几个字母,并添加一个下划线,例如 mydb_goods。
查看数据表
查看数据表
选择数据库后可通过以下语句查看:
-- 查看数据表
SHOW TABLES [FROM 数据库名] [LIKE 匹配模式];
-- 查看数据表相关信息
SHOW TABLE STATUS [FROM 数据库名] [LIKE 匹配模式];
-- 在命令行客户端可以使用 `\G` 将结果纵向排列,便于阅读:
SHOW TABLE STATUS FROM mydb LIKE '%new%'\G- Name:数据表的名称。
- Engine:数据表的存储引擎。
- Version:数据表的结构文件(如 lib_user_temp.frm)版本号。
- Row_format:记录的存储格式,包括 Dynamic(动态)、Fixed(固定)、Compressed(压缩)、Redundant(冗余)和 Compact(紧凑)。
- Data_length:数据文件的长度(MyISAM 存储引擎)或为聚簇索引分配的内存(InnoDB 存储引擎),均以字节为单位。
- Create_time:数据表的创建时间。
- Collation:数据表的校对集。
修改数据表
修改表名
-- 修改表名
# 语法格式 1,[TO|AS] 表示 TO 或 AS 任选其一
ALTER TABLE 旧表名 RENAME [TO|AS] 新表名;
# 语法格式 2
RENAME TABLE 旧表名1 TO 新表名1[, 旧表名2 TO 新表名2]...;
注意:ALTER TABLE 不支持子查询作为表名。
-- config 表里存储了当前要操作的表名叫 'log_2026'
-- 试图这样写是错误的!
ALTER TABLE (SELECT table_name FROM config WHERE id = 1) ADD COLUMN error_code INT;
修改表选项
ALTER TABLE 表名 表选项 [=] 值;示例:修改字符集并查看修改结果。
ALTER TABLE my_goods CHARSET = utf8;
SHOW CREATE TABLE my_goods;
查看表结构
查看字段信息
# 查看所有字段信息
{ DESCRIBE | DESC } 数据表名;
# 查看指定字段的信息
{ DESCRIBE | DESC } 数据表名 字段名;
执行结果中,Field 表示字段名称,Type 表示字段的数据类型,Null 表示该字段是否可以为空,Key 表示该字段是否已设置索引,Default 表示该字段是否有默认值,Extra 表示与该字段相关的附加信息。
查看完整创建语句
SHOW CREATE TABLE 表名;可查看数据表的创建语句以及表字符编码。
查看表结构
# 语法结构一
SHOW [FULL] COLUMNS FROM 数据表名 [FROM 数据库名];
# 语法结构二
SHOW [FULL] COLUMNS FROM 数据库名.数据表名;
可选项 FULL 表示显示详细内容:不添加时查询结果与 DESC 相同;添加 FULL 后不仅可以查看到 DESC 语句所能查看的信息,还可以查看到字段的权限、COMMENT 字段的注释信息等。
另外,在 SQL 语句中可以通过“FROM 数据库名”或“数据库名.数据表名”的方式查看任意数据库下的数据表结构信息。
修改表结构
修改字段名
ALTER TABLE 数据表名 CHANGE [COLUMN] 旧字段名 新字段名 字段类型 [字段属性];“字段类型”表示新字段名的数据类型,不能为空——即使与旧字段的数据类型相同,也必须重新设置。
修改字段类型
ALTER TABLE 数据表名 MODIFY [COLUMN] 字段名 新类型 [字段属性];修改字段位置
ALTER TABLE 数据表名
MODIFY [COLUMN] 字段名1 数据类型 [字段属性] [FIRST | AFTER 字段名2];
修改字段位置就是在修改字段类型的基础上添加 FIRST 或 AFTER 字段名2:前者表示将“字段名 1”调整为数据表的第 1 个字段,后者表示将“字段名 1”插入到“字段名 2”的后面。
新增字段
-- 语法格式 1:新增一个字段,并可指定其位置。
ALTER TABLE 数据表名
ADD [COLUMN] 新字段名 字段类型 [FIRST | AFTER 字段名];
-- 语法格式 2:同时新增多个字段。
ALTER TABLE 数据表名
ADD [COLUMN] (新字段名1 字段类型1, 新字段名2 字段类型2, ...);
在不指定位置的情况下,新增的字段默认添加到表的最后。另外,同时新增多个字段时不能指定字段的位置。
删除字段
将某个字段从数据表中删除,可以通过 DROP 完成。
ALTER TABLE 数据表名 DROP [COLUMN] 字段名;删除数据表
删除指定数据库中已经存在的表,在删除数据表的同时,存储在数据表中的数据都将被删除。
DROP [TEMPORARY] TABLE [IF EXISTS] 数据表1[, 数据表2] ...;数据操作
添加数据
为所有字段添加数据
为所有字段插入记录时,可以省略字段名称,严格按照数据表结构(字段的位置)插入对应的值。
INSERT [INTO] 数据表名 [VALUES | VALUE] (值1[, 值2] ...);在 MySQL 中,若创建的数据表未指定字符集,则数据表及表中的字段将使用默认字符集 latin1。因此,若插入的数据中含有中文,则会出现错误提示。例如,向 goods 表中插入含有中文的数据:
mysql> INSERT INTO goods
    -> VALUES(2, '中文', 9998, '中文描述');
ERROR 1366 (HY000): Incorrect string value: '\xb1\xca\xbc\xc7\xb1\xbe' for column 'name' at row 1
为解决中文插入的问题,通常在创建数据表时添加表选项,设置数据表的字符集:
CREATE [TEMPORARY] TABLE [IF NOT EXISTS] 表名
(字段名 字段类型 [字段属性]···) [DEFAULT] {CHARACTER SET | CHARSET} [=] utf8;
CHARACTER SET 与 CHARSET 是同义词,设置字符集时选取其一即可。其中 utf8 字符集支持世界上大多数国家的字符,通常推荐使用此字符集。
对于已经添加数据的数据表,可以通过 ALTER TABLE … CHANGE / MODIFY 完成对表字段字符集的设置,使用时需注意两者语法的不同。下面以修改 goods 表中 name 和 description 字段的字符集为例:
mysql> ALTER TABLE goods
    -> MODIFY name VARCHAR(32) CHARACTER SET utf8,
    -> MODIFY description VARCHAR(255) CHARACTER SET utf8;
Query OK, 1 row affected (0.02 sec)
Records: 1  Duplicates: 0  Warnings: 0
同时修改多个字段时,使用逗号(,)分隔。修改完成后,可以再次向 goods 表中插入以上含有中文的数据,可以看到 Query OK 的成功提示。
为部分字段添加数据
INSERT [INTO] 数据表名 (字段名1[, 字段名2] ...)
{VALUES | VALUE} (值1[, 值2] ...);- 字段名的编写顺序可与表结构(字段位置)不同,只需保证值列表中的数据与其相对应即可。
- 省略 (字段名1[, 字段名2] …) 时,会默认为表的原始字段顺序。
- 未添加数据的字段会被添加默认值 NULL。
- 值列表中的数据也可以来自别的表:
INSERT [INTO] 数据表名 (字段名1[, 字段名2] ...)
SELECT 字段名1[, 字段名2]
FROM table2 ...;
还可以使用以下方式:
INSERT [INTO] 数据表名
SET 字段名1 = 值1[, 字段名2 = 值2] ...;
在插入数据时,如果数据已经存在(即主键冲突)希望忽略,可以采用如下语句:
INSERT IGNORE ...;一次添加多行数据
INSERT [INTO] 数据表名 [(字段列表)]
{VALUES | VALUE} (值列表)[, (值列表)] ...;
“字段列表”在省略时,插入的数据需严格按照数据表创建的顺序插入;否则“值列表”插入的数据仅需与字段列表中的字段相对应即可。
示例:
mysql> INSERT INTO goods VALUES
    -> (1, 'notebook', 4998, 'High cost performance'),
    -> (2, '笔记本', 9998, '续航时间超过10个小时'),
    -> (3, 'Mobile phone', NULL, NULL);
Query OK, 3 rows affected (0.00 sec)
Records: 3  Duplicates: 0  Warnings: 0
查询数据
- 查询表中全部数据:可以使用星号
*通配符代替数据表中的所有字段名。
SELECT * FROM 数据表名;- 查询表中部分字段:在 SELECT 语句的字段列表中指定要查询的字段。
SELECT 字段名1, 字段名2, 字段名3, ... FROM 数据表名;- 条件查询:若想查询出符合条件的相关数据记录,可以使用 WHERE 实现。
SELECT * | (字段名1, 字段名2, 字段名3, ...)
FROM 数据表名 WHERE 字段名 = 值;- 使用别名。
SELECT
    字段名1 AS 新名称1,
    字段名2 AS 新名称2,
    字段名3 AS 新名称3
FROM 数据表名
WHERE 字段名 = 值;
# 或者,可省略 AS
SELECT
    字段名1 新名称1,
    字段名2 新名称2,
    字段名3 新名称3
FROM 数据表名
WHERE 字段名 = 值;修改数据
UPDATE 数据表名
SET 字段名1 = 值1[, 字段名2 = 值2, ...]
[WHERE 条件表达式];
若实际使用时没有添加 WHERE 条件,那么表中所有对应的字段都会被修改成统一的值,因此在修改数据时需谨慎操作。
删除数据
DELETE FROM 数据表名 [WHERE 条件表达式];“数据表名”指定要执行删除操作的表;WHERE 条件为可选参数,用于设置删除的条件,满足条件的记录会被删除。
在删除数据时若未指定 WHERE 条件,系统就会自动删除该表中所有的记录,因此需慎重。
数据类型与约束
数据类型
数字类型
整数类型
整数类型根据取值不同分为:
- TINYINT:占用 1 字节(8 位)
- 无符号最大值:(2^8 - 1 = 255)
- 有符号最大值:(2^7 - 1 = 127)
- 其他整数类型(SMALLINT、MEDIUMINT、INT、BIGINT)的字节数依次递增,取值范围可按相同方式计算。
有符号数和无符号(UNSIGNED)数的区别在于:该数据类型是否允许存储负数。
use mydb;

create table my_int (
int_1 int,
int_2 int unsigned,
int_3 tinyint,
int_4 tinyint UNSIGNED
);

# 插入成功测试
insert into my_int values(1000,1000,100,100);
# 插入失败测试
insert into my_int values(1000,-1000,100,100);
# 查看表结构
desc my_int;+-------+------------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+------------------+------+-----+---------+-------+
| int_1 | int | YES | | NULL | |
| int_2 | int unsigned | YES | | NULL | |
| int_3 | tinyint | YES | | NULL | |
| int_4 | tinyint unsigned | YES | | NULL | |
+-------+------------------+------+-----+---------+-------+
4 rows in set (0.046 sec)零填充(ZEROFILL):为字段设置该属性后,若数值的实际宽度小于指定的显示宽度,MySQL 会在数值左侧自动填充 0 以补足显示宽度。
重要特性:设置零填充后,字段会被自动设为无符号类型(UNSIGNED),因为负数无法使用零填充(负号 - 会与填充的 0 冲突,导致显示混乱)。
CREATE TABLE my_int2 (
    id INT,
    num INT(5) ZEROFILL
);
-- 插入测试数据
INSERT INTO my_int2 (id, num) VALUES (1, 12), (2, 12345), (3, 123456);
-- 查询结果
SELECT * FROM my_int2;+------+--------+
| id | num |
+------+--------+
| 1 | 00012 |
| 2 | 12345 |
| 3 | 123456 |
+------+--------+
3 rows in set (0.005 sec)数据类型自动转换:当插入的值与字段的数据类型不一致,或使用 ALTER TABLE 修改字段的数据类型时,MySQL 会尝试自动进行数据类型转换。
浮点数类型
MySQL 提供两种浮点数类型:
- FLOAT(单精度):4 字节
- DOUBLE(双精度):8 字节
| 数据类型 | 字节数 | 负数的取值范围 | 非负数的取值范围 |
|---|---|---|---|
| FLOAT | 4 | (-3.402823466E+38 -1.175494351E-38) | 0 和 (1.175494351E-38 3.402823466E+38) |
| DOUBLE | 8 | (-1.7976931348623157E+308 -2.2250738585072014E-308) | 0 和 (2.2250738585072014E-308 1.7976931348623157E+308) |
说明:
- 取值范围为理论极限值,实际受硬件/操作系统影响可能略小。
- 使用
UNSIGNED修饰时,取值范围不包含负数。
浮点数类型虽然取值范围极大,但精度有限:
- FLOAT:精度约为 6~7 位(有效数字)
- DOUBLE:精度约为 15 位(有效数字)
重要:若数值超出精度范围,会发生精度损失,即给定的数值与实际存储的数值不一致。
CREATE TABLE my_float (
    f1 FLOAT,
    f2 FLOAT
);

INSERT INTO my_float VALUES(111111, 1.111111);
INSERT INTO my_float VALUES(1111111, 1.1111111);
INSERT INTO my_float VALUES(1111114, 1111115);
INSERT INTO my_float VALUES(11111149, 11111159);
SELECT * FROM my_float; +----------+----------+
| f1 | f2 |
+----------+----------+
| 111111 | 1.11111 |
| 1111110 | 1.11111 |
| 1111110 | 1111120 |
| 11111100 | 11111200 |
+----------+----------+
4 rows in set (0.005 sec)定点数类型
定点数类型使用 DECIMAL(M, D) 定义:
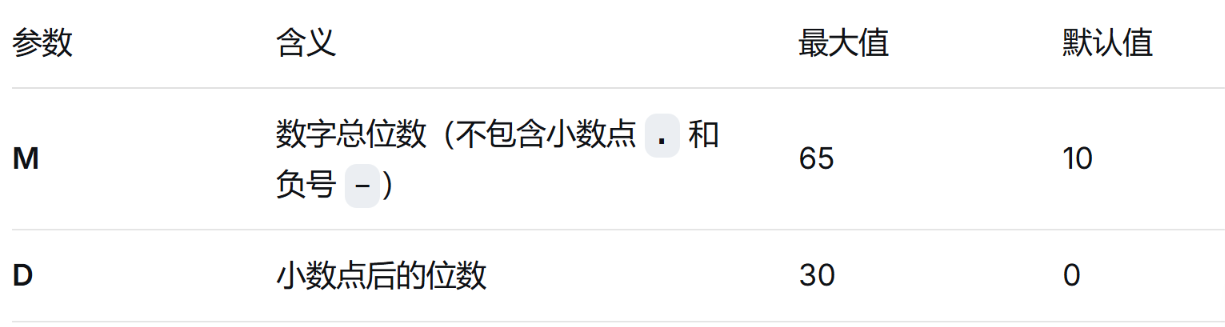
示例:DECIMAL(5,2)
- 总位数为 5,其中小数部分占 2 位
- 取值范围:
-999.99 ~ 999.99 - 系统会根据存储的数据自动分配存储空间
若不允许保存负数,可通过
UNSIGNED修饰。
-- 取值范围:-99.99 ~ 99.99
CREATE TABLE my_decimal (
    d1 DECIMAL(4,2),
    d2 DECIMAL(4,2)
);- 出现
Data truncated警告,表示数据被截断(实际为四舍五入调整)。
# 小数部分超出范围 → 四舍五入 + 警告
INSERT INTO my_decimal VALUES(1.234, 1.235);- 提示
Out of range value,表示数值超出取值范围。
INSERT INTO my_decimal VALUES(99.99, 99.999);d1 = 99.99:合法,在-99.99 ~ 99.99范围内d2 = 99.999:小数部分四舍五入后变为100.00,超出DECIMAL(4,2)的范围 → 插入失败
最后查询结果:
SELECT * FROM my_decimal;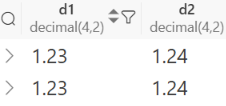
浮点数类型也可以设置位数和精度,如 float(8,2),但仍有可能损失精度。在实际使用时应避免使用浮点数类型,以免出现不能人为控制的问题。对于小数类型的设置,推荐使用定点数类型并设置合理的范围,使计算更为准确。
BIT 类型
BIT(位)类型用于存储二进制数据,语法为 BIT(M),其中 M 表示位数,取值范围为 1 ~ 64。
示例:保存字符 “A”。字符 A 的 ASCII 码为十进制 65,对应的二进制值为 1000001,共 7 位,因此至少需要 BIT(7) 来存储。
SELECT ASCII('A'); -- 获取字符 "A" 的 ASCII 码得到结果为 65,然后将十进制 65 转换为二进制,并计算其位数。
SELECT BIN(65), LENGTH(BIN(65));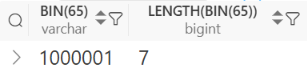
创建表并插入数据:
CREATE TABLE my_bit (b BIT(7));    -- 创建数据表,包含一个 BIT(7) 类型的字段 b
INSERT INTO my_bit VALUES (65);    -- 插入一条数据,字段 b 的值为数字 65
SELECT * FROM my_bit WHERE b = 65; -- 查询 my_bit 表中 b 字段等于数字 65 的所有记录
显示结果为 1000001。但在 MySQL 客户端,默认将 BIT 类型以 ASCII 字符形式展示(当值对应可打印字符时),所以显示为 A。
SELECT BIN(b) FROM my_bit; -- 查询表中的 b 字段,并将其以二进制字符串形式显示显示结果为 1000001。
MySQL 中的直接常量:指在 MySQL 中直接编写的字面常量,如数字 123、字符串 'abc' 等,常用于在 INSERT 语句中编写插入的数据。直接常量有多种语法形式。
- 十进制数:语法近似于日常生活中的数字,如
123、1.23、-1.23,以及科学计数法1E2、1E-2(E 不分大小写)。 - 二进制数:在二进制字符串前加前缀
b,形如b'1000001'。通过SELECT b'1000001';可查看二进制转为 ASCII 字符后的结果,即字符A。 - 十六进制数:有两种表示方式,形如
x'41'和0x41。其中,十六进制数41对应十进制数为 65。- 通过
SELECT HEX(65);可查看十进制 65 转为十六进制的结果,即41。 - 通过
SELECT x'41', 0x41;可查看 ASCII 字符,即字符A。
- 通过
- 字符串:MySQL 支持单引号和双引号定界符,形如
'abc'和"abc",推荐使用单引号定界符。若要在单/双引号字符串中书写单/双引号,需要在单/双引号前面加上反斜线\转义,即\'和\",这种方式称为转义字符。常用的转义字符如下表所示。
| 转义字符 | 含义 | 转义字符 | 含义 |
|---|---|---|---|
\0 |
空字符串 (NULL) | \t |
制表符 (HT) |
\r |
回车符 (CR) | \b |
退格 (BS) |
\n |
换行符 (LF) | \' |
单引号 |
\" |
双引号 | % |
%(常用于 LIKE 条件) |
\\ |
反斜线 | _ |
_(常用于 LIKE 条件) |
- 布尔值:有
TRUE和FALSE两个值(不分大小写),在SELECT、INSERT等语句中使用布尔值时:TRUE会转换为1FALSE会转换为0
- NULL 值:通常用来表示没有值、值不确定等含义。例如,在插入一条商品数据时,暂时不知道该商品的库存量,可将库存量设为
NULL,以后再修改。
时间和日期类型
MySQL 提供了表示日期和时间的数据类型,分别是 YEAR、DATE、TIME、DATETIME 和 TIMESTAMP。
| 数据类型 | 取值范围 | 日期格式 | 零值 |
|---|---|---|---|
YEAR |
1901 ~ 2155 | YYYY |
0000 |
DATE |
1000-01-01 ~ 9999-12-31 | YYYY-MM-DD |
0000-00-00 |
TIME |
-838:59 ~ 838:59 | HH:MM:SS |
00:00:00 |
DATETIME |
1000-01-01 00:00 ~ 9999-12-31 23:59 | YYYY-MM-DD HH:MM:SS |
0000-00-00 00:00:00 |
TIMESTAMP |
1970-01-01 00:00 ~ 2038-01-19 03:14 | YYYY-MM-DD HH:MM:SS |
0000-00-00 00:00:00 |
- 每种日期和时间类型的取值范围各不相同,选择时应根据实际业务需求合理使用。
- 如果插入的数值不合法(超出取值范围或格式错误),系统会自动将对应的零值存入数据库,而不会报错。
YEAR
YEAR 类型用于表示年份:
CREATE TABLE my_year (y YEAR);     -- 设置 y 字段的数据类型为 YEAR
INSERT INTO my_year VALUES (2020); -- 插入年份数据,2020 年
可以使用以下 3 种格式指定 YEAR 类型的值:
- 使用 4 位字符串或数字表示
- 范围:
'1901'~'2155'或1901~2155 - 示例:输入
'2020'或2020,插入到数据库中的值均为 2020
- 范围:
- 使用两位字符串表示(‘00’ ~ ‘99’)
- ‘00’ ~ ‘69’ 会被转换为 2000 ~ 2069
- ‘70’ ~ ‘99’ 会被转换为 1970 ~ 1999
- 示例:输入 ‘20’,插入到数据库中的值为 2020
- 使用两位数字表示(1 ~ 99)
- 1 ~ 69 会被转换为 2001 ~ 2069
- 70 ~ 99 会被转换为 1970 ~ 1999
- 示例:输入 20,插入到数据库中的值为 2020
在使用 YEAR 类型时,一定要区分 ‘0’ 和 0:前者字符串表示 2000,后者数字表示 0000。
DATE
用于表示日期值,不包含时间部分。使用示例如下:
CREATE TABLE my_date (d DATE);             -- 设置 d 字段的数据类型为 DATE
INSERT INTO my_date VALUES ('2020-01-21'); -- 插入日期数据
INSERT INTO my_date VALUES (CURRENT_DATE); -- 插入当前系统日期
INSERT INTO my_date VALUES (NOW());        -- 插入当前系统日期(仅取日期部分)
可以使用以下 4 种格式指定 DATE 类型的值:
- 完整字符串格式:使用
YYYY-MM-DD或YYYYMMDD字符串表示。例如,'2020-01-21'或'20200121',插入数据库中的日期都为2020-01-21。 - 缩写字符串格式:使用
YY-MM-DD或YYMMDD字符串表示。年份YY范围 ‘00’ ~ ‘99’,其中 ‘00’ ~ ‘69’ 会被转换为 2000 ~ 2069,‘70’ ~ ‘99’ 转换为 1970 ~ 1999。例如,'20-01-21'或'200121',插入数据库中的日期都为2020-01-21。 - 缩写数字格式:使用
YY-MM-DD或YYMMDD数字表示(规则与字符串格式相同)。例如,20-01-21或200121,插入数据库中的日期都为2020-01-21。 - 使用系统函数:使用
CURRENT_DATE或NOW()输入当前系统日期。例如,INSERT INTO my_date VALUES (CURRENT_DATE);
补充说明:
- 通过
SELECT CURRENT_DATE;或SELECT NOW();可查看当前日期。 - 日期中的分隔符
-还可以用.、/等符号替代,例如'2020.01.21'或'2020/01/21'同样有效。
TIME
用于表示时间值,显示形式通常为 HH:MM:SS,其中 HH 表示小时,MM 表示分钟,SS 表示秒。可以使用以下 3 种格式指定 TIME 类型的值:
- 字符串或数字格式:以
'HHMMSS'字符串或HHMMSS数字格式表示。例如,输入'345454'或345454,插入数据库中的时间为34:54:54(34 小时 54 分 54 秒)。 - “日+时间”字符串格式:以
'D HH:MM:SS'字符串格式表示,其中D表示天数,取值范围 0~34。插入时,小时部分会被计算为(D × 24 + HH),其余不变。例如:- 输入
'2 11:30:50',插入数据库中的时间为59:30:50(2×24+11=59)。 - 输入
'0 11:30:50'或简写为'11:30:50',插入数据库中的时间为11:30:50。 - 输入
'34 22:59:59',插入数据库中的时间为838:59:59(34×24+22=838,为 MySQL TIME 类型的最大值)。
- 输入
- 使用系统函数:使用
CURRENT_TIME或NOW()获取当前系统时间。例如,INSERT INTO my_time VALUES (CURRENT_TIME);或INSERT INTO my_time VALUES (NOW());(NOW()会包含日期,但存入 TIME 字段时只取时间部分)。
补充说明:
- 可以通过
SELECT CURRENT_TIME;或SELECT NOW();查看当前时间。 - TIME 类型支持的范围为
'-838:59:59'到'838:59:59',超出范围会报错或截断。
DATETIME
用于表示日期和时间,显示形式为 'YYYY-MM-DD HH:MM:SS'。可以使用以下格式指定 DATETIME 类型的值:
- 完整字符串格式:以
'YYYY-MM-DD HH:MM:SS'或'YYYYMMDDHHMMSS'字符串格式表示日期和时间,取值范围为'1000-01-01 00:00:00'至'9999-12-31 23:59:59'。例如,输入'2014-01-22 09:01:23'或'20140122090123',插入数据库中的 DATETIME 值均为2014-01-22 09:01:23。 - 缩写字符串格式:以
'YY-MM-DD HH:MM:SS'或'YYMMDDHHMMSS'字符串格式表示,其中YY为两位年份,取值范围 ‘00’ ~ ‘99’。转换规则与 DATE 类型相同:‘00’ ~ ‘69’ 映射为 2000 ~ 2069,‘70’ ~ ‘99’ 映射为 1970 ~ 1999。例如,输入'14-01-22 09:01:23',入库后为2014-01-22 09:01:23。 - 数字格式:以
YYYYMMDDHHMMSS或YYMMDDHHMMSS数字格式表示(无引号)。例如,输入20140122090123,入库后为2014-01-22 09:01:23。 - 使用系统函数:使用
NOW()获取当前系统的日期和时间。例如,INSERT INTO my_datetime VALUES (NOW());
补充说明:
- 可通过
SELECT NOW();查看当前日期时间。 - 分隔符
-和:也可替换为其他符号(如/、.),但需保持格式一致。 - 若只插入日期部分,时间将自动补为
00:00:00;若只插入时间部分,日期将默认为0000-00-00(取决于 SQL 模式)。
TIMESTAMP
TIMESTAMP(时间戳)类型用于表示日期和时间,显示格式与 DATETIME 相同,但取值范围比 DATETIME 小。与 DATETIME 相比,TIMESTAMP 具有以下特殊用法:
- 使用
CURRENT_TIMESTAMP来获取系统当前的日期和时间,例如INSERT INTO my_timestamp VALUES (CURRENT_TIMESTAMP);。 - 当插入数据时,如果对该字段无任何输入(即省略该字段)或显式插入
NULL,实际保存的值会自动替换为系统当前的日期和时间(前提是字段已设置默认值为CURRENT_TIMESTAMP或允许自动更新)。
补充说明:
- TIMESTAMP 的范围为
'1970-01-01 00:00:01'UTC 至'2038-01-19 03:14:07'UTC,受时区影响。 - 若需更大范围(如历史日期),建议使用 DATETIME 类型。
- 可通过
SELECT CURRENT_TIMESTAMP;查看当前时间戳。
字符串类型
MySQL 中的字符串类型分为:
- CHAR:固定长度字符串。
- VARCHAR:可变长度字符串。
- TEXT:大文本数据。
- ENUM:枚举类型。
- SET:字符串对象。
- BINARY:固定长度的二进制数据。
- VARBINARY:可变长度的二进制数据。
- BLOB:二进制大对象(Binary Large Object)。
CHAR 与 VARCHAR 的对比
定义方式:CHAR(M) 或 VARCHAR(M),其中 M 表示最大字符长度。以 CHAR(4) 和 VARCHAR(4) 为例,存储需求对比如下:
| 插入值 | CHAR(4) 存储需求 | VARCHAR(4) 存储需求 |
|---|---|---|
'' |
4 字节 | 1 字节 |
'ab' |
4 字节 | 3 字节 |
'abc' |
4 字节 | 4 字节 |
'abcd' |
4 字节 | 5 字节 |
- CHAR 无论实际长度如何,始终占用
M个字节(若长度不足则补空格,但取出时会去除)。 - VARCHAR 占用字节数为实际字符数加 1(用于记录长度),因此更节省空间。
TEXT 类型
TEXT 用于保存大文本数据(如文章、评论),分为 4 种子类型,存储范围如下:
| 数据类型 | 存储范围 | 数据类型 | 存储范围 |
|---|---|---|---|
| TINYTEXT | 0 ~ 2^8 - 1 字节 | MEDIUMTEXT | 0 ~ 2^24 - 1 字节 |
| TEXT | 0 ~ 2^16 - 1 字节 | LONGTEXT | 0 ~ 2^32 - 1 字节 |
TEXT 实际能保存的字符数量取决于字符串占用的字节数(与字符集有关)。
字符串类型使用注意点
-
末尾空格处理:插入数据时,若字符串末尾有空格,CHAR 类型会自动去除空格后保存,而 VARCHAR 和 TEXT 会保留空格。
-
比较时忽略末尾空格:使用
=等运算符对 CHAR、VARCHAR、TEXT 进行比较时,字符串末尾的空格会被忽略。例如,查询'a'时,也会匹配到'a ';反过来,查询条件'a '也会忽略尾随空格。 -
大小写敏感性:默认情况下,数据库使用
latin1_swedish_ci校对集(不区分大小写),因此 CHAR、VARCHAR、TEXT、ENUM、SET 类型在比较时都不区分大小写。例如,查询'a'会同时匹配'a'和'A'。而 BINARY、VARBINARY、BLOB 类型以二进制方式保存数据,因此区分大小写。 -
行大小限制:MySQL 默认规定一条记录的最大长度为 65535 字节。一般字段分配的存储空间加上额外开销不能超过此值,否则在严格模式下表创建会失败(报错
Row size too large)。但 TEXT 和 BLOB 类型字段的存储空间不受此限制,它们仅占用少量额外开销(约 12 字节)。 -
字段最大长度限制:在未超过 65535 字节的前提下,CHAR 字段的
M最大值为 255;VARCHAR 字段的M最大值取决于字符集:- 使用
latin1(默认):最大 65533 - 使用
gbk:最大 32766 - 使用
utf8:最大 21844
若表中只有一个字段且设置了
NOT NULL,则M可达到上述最大值;否则因需要额外字节存储NULL标志,最大值会相应减小。 - 使用
-
性能建议:从执行效率看,TEXT 和 BLOB 不如 CHAR 和 VARCHAR。建议仅在需要保存大量数据时才使用 TEXT 或 BLOB,否则优先考虑 CHAR 或 VARCHAR。
如何严格区分大小写进行比较
方法一:使用 BINARY 关键字
在字段名或某个值的前面加上 BINARY 关键字,可将类型转换为二进制,转换后进行比较即可严格区分大小写,同时也会区分末尾空格。
-- 直接测试比较结果
SELECT 'a' = 'A';                           -- 结果:1(相等,默认不区分大小写)
SELECT BINARY 'a' = 'A', 'a' = BINARY 'A';  -- 结果:0(不相等),0(不相等)
SELECT BINARY 'A' = 'A';                    -- 结果:1(相等)

-- 在查询条件中进行二进制比较
CREATE TABLE my_char (c CHAR(2));
INSERT INTO my_char VALUES ('A');

SELECT c FROM my_char WHERE c = 'a';         -- 查询结果为 "A"(默认不区分大小写)
SELECT c FROM my_char WHERE BINARY c = 'a';  -- 查询结果为空(严格区分)
SELECT c FROM my_char WHERE BINARY c = 'A'; -- 查询结果为 "A"方法二:设置字段的校对集(COLLATE)
latin1、gbk、utf8 编码默认的校对集分别为 latin1_swedish_ci、gbk_chinese_ci、utf8_general_ci(均不区分大小写)。将其改为对应的 _bin 校对集(如 latin1_bin、gbk_bin、utf8_bin)即可区分大小写,但此种方式在比较时仍会忽略字符串末尾的空格。
-- ① 创建表时设置字段的校对集
CREATE TABLE my_char (
    c1 CHAR(2) CHARACTER SET latin1 COLLATE latin1_bin,
    c2 CHAR(2) CHARACTER SET gbk COLLATE gbk_bin,
    c3 CHAR(2) CHARACTER SET utf8 COLLATE utf8_bin
);

-- ② 插入测试数据
INSERT INTO my_char VALUES ('A', 'A', 'A');

-- ③ 查询测试
SELECT c1 = 'a', c2 = 'a', c3 = 'a' FROM my_char;  -- 结果均为 0(不相等,严格区分)
SELECT c1 = 'A', c2 = 'A', c3 = 'A' FROM my_char; -- 结果均为 1(相等)ENUM 类型
ENUM 又称为枚举类型,定义方式为 ENUM('值1', '值2', '值3', ..., '值n'),其中括号内的列表称为枚举列表。ENUM 类型的数据只能从枚举列表中取值,并且只能取一个值。
-- ① 创建表
CREATE TABLE my_enum (gender ENUM('male', 'female'));

-- ② 插入两条测试记录
INSERT INTO my_enum VALUES ('male'), ('female');

-- ③ 查询记录(结果为 "female")
SELECT * FROM my_enum WHERE gender = 'female';

-- ④ 插入枚举列表中不存在的值测试
INSERT INTO my_enum VALUES ('m');
-- 报错:ERROR 1265 (01000): Data truncated for column 'gender' at row 1- 枚举列表最多可包含 65535 个值。
- 每个枚举值都有一个对应的顺序编号(从 1 开始)。实际存储在记录中的是编号,而非字符串本身,因此无需担心过长的值占用过多存储空间。
- 但在使用
SELECT、INSERT等语句时,依然直接使用列表中的值(字符串)进行操作,内部会自动转换为对应的编号存储。 - 如果插入
NULL,则允许(前提是字段允许为空),且编号为NULL;若插入''(空字符串),则编号为 0,表示无效值。 - 插入无效值时会报错或给出警告。
SET 类型
SET 用于保存字符串对象,定义格式为 SET('值1', '值2', '值3', ..., '值n')。SET 类型的列表中最多可以有 64 个值,每个值都有一个顺序编号。类似地,为了节省空间,实际保存在记录中的是编号,但在使用 SELECT、INSERT 等语句时,仍然使用列表中的值进行操作。
SET 类型与 ENUM 的区别在于:SET 可以从列表中选择一个或多个值来保存,多个值之间用逗号 , 分隔;而 ENUM 只能从列表中选择一个值(类似于单选框与复选框的关系)。
-- ① 创建表
CREATE TABLE my_set (hobby SET('book', 'game', 'code'));

-- ② 插入 3 条测试记录
INSERT INTO my_set VALUES ('1'), ('book'), ('book, code');

-- ③ 查询记录(结果为 "book, code")
SELECT * FROM my_set WHERE hobby = 'book, code';-
ENUM 类型类似于单选框,SET 类型类似于复选框。
-
优势:ENUM 和 SET 类型能够规范数据,限定只能插入规定的数据项;同时节省存储空间,查询速度比 CHAR、VARCHAR 类型更快。
-
中文支持:ENUM 和 SET 类型列表中的值都可以使用中文,但必须设置支持中文的字符集。例如:
SQL1 行CREATE TABLE my_enum (gender ENUM('男', '女')) CHARSET=GBK; -
空格处理:在填写列表、插入值、查找值等操作时,ENUM 和 SET 类型都会自动忽略末尾的空格。
BINARY 和 VARBINARY 类型
BINARY 和 VARBINARY 类似于 CHAR 和 VARCHAR,但存储的是二进制数据。定义方式为 BINARY(M) 或 VARBINARY(M),其中 M 表示二进制数据的最大字节长度。
- BINARY 为固定长度:若实际数据长度不足
M,会在末尾用\0(空字符)补齐以达到指定长度。例如BINARY(3)插入'a'时,实际存储为'a\0\0';插入'ab'时存储为'ab\0'。 - VARBINARY 为可变长度,按实际数据长度存储,不填充。
-- ① 创建表,插入测试记录
CREATE TABLE my_binary (b1 BINARY(4), b2 VARBINARY(4));
INSERT INTO my_binary VALUES ('abc', 'xyz');

-- ② 查询记录(\0 在显示时通常表现为空格)
SELECT b1 FROM my_binary WHERE b1 = 'abc\0'; -- 结果:abc(带填充符)
SELECT b2 FROM my_binary WHERE b2 = 'xyz';   -- 结果:xyz

-- ③ 由于区分大小写,以下查询结果均为空
SELECT b1 FROM my_binary WHERE b1 = 'ABC\0';
SELECT b2 FROM my_binary WHERE b2 = 'XYZ';- 查询 BINARY 类型字段时,条件字符串也需添加
\0填充符,否则无法匹配。 - BINARY 和 VARBINARY 类型区分大小写,因为存储的是二进制数据。
- 与 CHAR/VARCHAR 的字符串比较不同,二进制比较严格按字节值进行。
BLOB 类型
BLOB 用于保存数据量很大的二进制数据,如图片、PDF 文档等。BLOB 分为 4 种子类型,存储范围如下:
| 数据类型 | 存储范围 | 数据类型 | 存储范围 |
|---|---|---|---|
| TINYBLOB | 0 ~ 2^8 - 1 字节 | MEDIUMBLOB | 0 ~ 2^24 - 1 字节 |
| BLOB | 0 ~ 2^16 - 1 字节 | LONGBLOB | 0 ~ 2^32 - 1 字节 |
与 TEXT 类型的区别:
- BLOB 类型数据根据二进制编码进行比较和排序(区分大小写)。
- TEXT 类型数据根据文本模式进行比较和排序(通常不区分大小写,取决于校对集)。
-- 创建表,插入测试记录
CREATE TABLE my_blob (b BLOB);
INSERT INTO my_blob VALUES ('data');

-- 查询记录(结果为 "data")
SELECT b FROM my_blob WHERE b = 'data';

-- 由于区分大小写,以下查询结果为空
SELECT b FROM my_blob WHERE b = 'Data';附:JSON 数据类型
MySQL 从 5.7.8 版本开始提供了 JSON 数据类型。MySQL 中 JSON 类型值常见的形式有两种,分别为 JSON 数组和 JSON 对象:
- JSON 数组:
["abc", 10, null, true, false]。JSON 数组中保存的数据可以是任意类型,使用[和]包裹,多个值之间用逗号分隔。 - JSON 对象:
{"k1": "value", "k2": 10}。JSON 对象使用{和}包裹,保存的是一组键值对(key-value),如k1和k2为键名,"value"和10为对应的值。
与直接使用字符串类型相比,JSON 数据类型的优势:
- 自动验证格式:插入时会校验是否为合法的 JSON 数据。
- 优化存储格式:以内部二进制格式存储,读取效率更高。
注意事项:
- JSON 数据类型所需的空间大致与 LONGBLOB 或 LONGTEXT 相同。
- JSON 字段不能有默认值(即不能设置
DEFAULT)。
使用示例:
-- 创建表,插入测试记录
CREATE TABLE my_json (j1 JSON, j2 JSON);
INSERT INTO my_json VALUES ('{"k1": "value", "k2": 10}', '["run", "sing"]');

-- 查询记录
SELECT * FROM my_json;
表的约束
默认约束
默认约束用于为字段指定默认值。插入新记录时若未给该字段赋值,数据库会自动填入默认值。默认值通过 DEFAULT 关键字定义,基本语法:
字段名 数据类型 DEFAULT 默认值注意事项:
BLOB、TEXT类型不支持默认约束。- 若字段允许
NULL,默认值可设为NULL;若设为非空值,需确保该值符合字段数据类型。 DESC结果的 Default 列显示(NULL)表示未设置默认值,而非默认值为NULL,但在终端中可能不显示括号。- 默认值可以是常量或表达式(表达式需加括号,如
DEFAULT (CURRENT_DATE),具体取决于版本)。
使用示例:
CREATE TABLE users (
    id INT,
    name VARCHAR(20) DEFAULT '匿名',
    created_at DATE DEFAULT (CURRENT_DATE)
);
DESC users;+------------+-------------+------+-----+-----------+-------------------+
| Field | Type | Null | Key | Default | Extra |
+------------+-------------+------+-----+-----------+-------------------+
| id | int | YES | | NULL | |
| name | varchar(20) | YES | | 匿名 | |
| created_at | date | YES | | curdate() | DEFAULT_GENERATED |
+------------+-------------+------+-----+-----------+-------------------+
3 rows in set (0.022 sec)-- 删除默认约束
ALTER TABLE users MODIFY name VARCHAR(20);
DESC users;+------------+-------------+------+-----+-----------+-------------------+
| Field | Type | Null | Key | Default | Extra |
+------------+-------------+------+-----+-----------+-------------------+
| id | int | YES | | NULL | |
| name | varchar(20) | YES | | NULL | |
| created_at | date | YES | | curdate() | DEFAULT_GENERATED |
+------------+-------------+------+-----+-----------+-------------------+
3 rows in set (0.017 sec)-- 添加默认约束
ALTER TABLE users MODIFY name VARCHAR(20) DEFAULT '匿名';
DESC users;+------------+-------------+------+-----+-----------+-------------------+
| Field | Type | Null | Key | Default | Extra |
+------------+-------------+------+-----+-----------+-------------------+
| id | int | YES | | NULL | |
| name | varchar(20) | YES | | 匿名 | |
| created_at | date | YES | | curdate() | DEFAULT_GENERATED |
+------------+-------------+------+-----+-----------+-------------------+
3 rows in set (0.017 sec)非空约束
非空约束值字段的值不能为 NULL;通过 NOT NULL 定义:
字段名 数据类型 NOT NULL;为现有表添加或删除非空约束的方式与默认约束类似。若目标列中已存在 NULL 值,添加非空约束会失败,提示错误 Invalid use of NULL value。此时需先将该列的所有 NULL 值更新为非空值,再执行添加操作。-NOT NULL 和 DEFAULT NULL 不能同时使用。
CREATE TABLE not_null (
    n1 INT,
    n2 INT NOT NULL,
    n3 INT NOT NULL DEFAULT 18
);
DESC not_null;+-------+------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+------+------+-----+---------+-------+
| n1 | int | YES | | NULL | |
| n2 | int | NO | | NULL | |
| n3 | int | NO | | 18 | |
+-------+------+------+-----+---------+-------+
3 rows in set (0.015 sec)唯一约束
唯一约束用于保证字段的唯一性,即字段的值不能重复出现,通过 UNIQUE 定义,基本语法:
-- 列级约束
字段名 数据类型 UNIQUE
-- 表级约束
UNIQUE(字段名1, 字段名2, ...)- 列级约束定义在一个列上,只对该列起作用。
- 表级约束独立于列的定义,可以作用于表的多个列。
单一情形
当表级约束只建立在一个字段上时,其作用与列级约束相同:
-- 列级约束
CREATE TABLE test1(
    id INT UNSIGNED UNIQUE,
    username VARCHAR(10) UNIQUE
);
DESC test1;
-- 表级约束
CREATE TABLE test2(
    id INT UNSIGNED,
    username VARCHAR(10),
    UNIQUE(id),
    UNIQUE(username)
);
DESC test2;两个表的结构相同,Key 列为 UNI 表示唯一约束添加成功。
+----------+--------------+------+-----+---------+-------+
| Field    | Type         | Null | Key | Default | Extra |
+----------+--------------+------+-----+---------+-------+
| id       | int unsigned | YES  | UNI | NULL    |       |
| username | varchar(10)  | YES  | UNI | NULL    |       |
+----------+--------------+------+-----+---------+-------+
2 rows in set (0.014 sec)
唯一约束的添加和删除无法通过修改字段属性的方式操作,而是按照索引的方式操作。
对于 test1 和 test2,由于创建时未显式指定约束名称,MySQL 会自动将列名作为唯一约束的索引名称(即 id 和 username)。可先通过以下语句确认具体的约束名称(输出中通常可见 UNIQUE KEY id (id) 等字样):
SHOW CREATE TABLE test1;
SHOW CREATE TABLE test2;
| test1 | CREATE TABLE `test1` (
`id` int unsigned DEFAULT NULL,
`username` varchar(10) DEFAULT NULL,
UNIQUE KEY `id` (`id`),
UNIQUE KEY `username` (`username`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci |-- 删除 test1 表中的 id 唯一约束,同理可删除 username 唯一约束
ALTER TABLE test1 DROP INDEX id;+----------+--------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+----------+--------------+------+-----+---------+-------+
| id | int unsigned | YES | | NULL | |
| username | varchar(10) | YES | UNI | NULL | |
+----------+--------------+------+-----+---------+-------+
2 rows in set (0.014 sec)添加唯一约束时可以显式命名(添加唯一约束时会创建索引,名称可省略,默认为字段名):
-- 列级约束
CREATE TABLE test1(
    id INT UNSIGNED,
    username VARCHAR(10)
);
-- 表级约束
CREATE TABLE test2(
    id INT UNSIGNED,
    username VARCHAR(10)
);

-- 为 test1 表添加 id 唯一约束(指定名称 uq_id)
ALTER TABLE test1 ADD CONSTRAINT uq_id UNIQUE (id);

-- 为 test1 表添加 username 唯一约束(指定名称 uq_username)
ALTER TABLE test1 ADD CONSTRAINT uq_username UNIQUE (username);

-- 删除 test1 表中的 id 唯一约束,同理其它
ALTER TABLE test1 DROP INDEX uq_id;复合唯一约束
当表级约束建立在多个字段上时,只有多个字段的值都相同才视为重复记录:
CREATE TABLE test5(
    id INT UNSIGNED, username VARCHAR(10),
    UNIQUE(id, username)
);
DESC test5;

-- 插入不重复记录,成功
INSERT INTO test5 VALUES(1, '2');
INSERT INTO test5 VALUES(1, '3');
-- 插入重复记录,失败
INSERT INTO test5 VALUES(1, '2');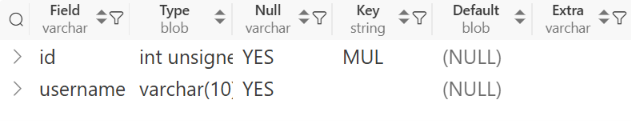
复合唯一约束的添加和删除操作与单列唯一约束原理相同(都通过索引管理),但需特别注意索引名称。创建时未显式命名时,MySQL 会自动生成索引名(通常取第一个列名):
SHOW CREATE TABLE test5;-- 删除 test5 表上的复合唯一约束
ALTER TABLE test5 DROP INDEX id;删除后若想重新添加,有两种方式。
方式一:显式命名。
ALTER TABLE test5 ADD CONSTRAINT uq_id_username UNIQUE (id, username);方式二:系统自动命名(通常取第一个列名)。
ALTER TABLE test5 ADD UNIQUE (id, username);主键约束
主键约束(PRIMARY KEY)用于唯一标识表中的每一行记录,被主键约束的字段必须同时满足唯一性(UNIQUE)和非空性(NOT NULL)。
每张表只能有一个主键,但主键可以由一个字段(单列主键)或多个字段组合(复合主键)构成。
创建表时定义主键约束
主键支持列级和表级两种定义方式。
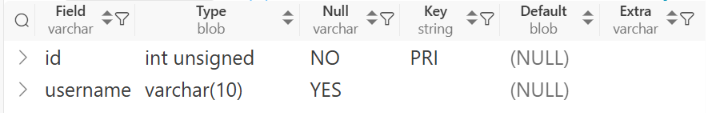
- 列级约束(单列主键):直接在字段类型后添加
PRIMARY KEY。
CREATE TABLE test_pk1 (
    id INT UNSIGNED PRIMARY KEY,  -- 列级定义
    username VARCHAR(10)
);
- 表级约束(单列或复合主键):在所有字段定义结束后单独声明。
-- 单列主键(表级)
CREATE TABLE test_pk2 (
    id INT UNSIGNED,
    username VARCHAR(10),
    PRIMARY KEY (id)               -- 表级定义
);

-- 复合主键(必须是表级)
CREATE TABLE test_pk3 (
    id INT UNSIGNED,
    username VARCHAR(10),
    PRIMARY KEY (id, username)     -- id 和 username 组合唯一
);为现有表添加主键约束
如果建表时遗漏了主键,可以使用 ALTER TABLE 添加。必须确保该列的数据全部非空且唯一,否则添加会失败。
-- 先确保列中无 NULL 且无重复值
UPDATE test_pk1 SET id = 1 WHERE id IS NULL;
DELETE FROM test_pk1 WHERE id IN (SELECT ...); -- 去重操作

-- 添加主键(表级写法)
ALTER TABLE test_pk1 ADD PRIMARY KEY (id);

-- 添加复合主键
ALTER TABLE test_pk3 ADD PRIMARY KEY (id, username);如果表中已有主键,直接
ADD PRIMARY KEY会报错(Multiple primary key defined),必须先删除旧主键。
删除主键约束
删除主键使用固定的 DROP PRIMARY KEY 语法(不需要指定列名,因为每张表只有一个主键):
ALTER TABLE test_pk1 DROP PRIMARY KEY;- 删除主键后,字段依然保留
NOT NULL属性(主键残留的非空特性不会自动消失)。 - 如果该列是
AUTO_INCREMENT(自增列),删除主键时会报错,需要先修改自增属性。
自动增长
实际开发中,主键常与 AUTO_INCREMENT 配合使用,由数据库自动生成递增的数值,适合作为代理主键,避免每次插入记录时手动检查主键值是否重复。
自动增长通过 AUTO_INCREMENT 实现,基本语法:
字段名 数据类型 AUTO_INCREMENT规则与注意点:
- 一个表中只能有一个自动增长字段,该字段必须是整数类型,且必须定义为键(如
UNIQUE KEY、PRIMARY KEY)。 - 若为自动增长字段插入
NULL、0、DEFAULT,或插入时省略该字段,则使用自动增长值;若插入具体值,则直接使用该值。 - 自动增长值从
1开始,每次加1。若插入的值大于当前自动增长值,则下次自动增长值调整为当前最大值加1;若小于当前自动增长值,则不影响自动增长值(但可能因重复而报错)。 - 使用
DELETE删除记录时,自动增长值不会减小,也不会填补空缺(自增值只增不减)。
CREATE TABLE users (
    id INT UNSIGNED AUTO_INCREMENT PRIMARY KEY,  -- 自动生成 1, 2, 3...
    name VARCHAR(20)
);

INSERT INTO users (name) VALUES ('张三'), ('李四');  -- 无需手动指定 id
查看当前自动增长值(下一次插入时自动增长值为 3):
SHOW CREATE TABLE users;为现有的表修改或删除自动增长:
-- 修改自动增长值(将自增起始值设为 10)
ALTER TABLE users AUTO_INCREMENT = 10;

-- 删除自动增长(移除 AUTO_INCREMENT 属性)
ALTER TABLE users MODIFY id INT UNSIGNED;

-- 重新为 id 添加自动增长
ALTER TABLE my_auto MODIFY id INT UNSIGNED AUTO_INCREMENT;- 删除自动增长并重新添加后,自动增长的初始值会自动设为该列现有最大值加 1。
- 修改自动增长值(如
ALTER TABLE ... AUTO_INCREMENT = 10)时,若指定的值小于该列现有最大值,修改不会生效(系统保留当前最大值加 1 作为起始值)。
通过以下命令查看 MySQL 维护自动增长的两个系统变量:
SHOW VARIABLES LIKE 'auto_increment%';auto_increment_increment(默认值 1):步长。auto_increment_offset(默认值 1):起始偏移量。
更改这两个变量可以改变自动增长的计算方式。
字符集与校对集
MySQL 默认字符集为 latin1(ISO-8859-1 的别名),属于单字节编码。中文字符为多字节编码,若要保存中文,需将字符集设置为支持中文的字符集,如 GBK 或 UTF8。校对集(Collation)定义字符之间的比较规则,用于排序和比较操作。
字符集
字符(character)包括文字、标点符号、图形符号、数字等。计算机以二进制保存数据,字符需按一定规则转换为二进制后存储,该过程称为字符编码(character encoding);一系列字符的编码规则组合即构成字符集(character set, charset)。查看 MySQL 支持的所有字符集:
SHOW CHARACTER SET;
-- 包含字符集名称(Charset)、描述信息(Description)、默认校对集(Default collation)以及单字符最大字节数(Maxlen)
常用字符集:
| 字符集 | 单字符最大长度 | 支持的语言 |
|---|---|---|
| latin1 | 1 字节 | 西欧字符、希腊字符等 |
| gbk | 2 字节 | 简体及繁体中文、日文、韩文等 |
| utf8 | 3 字节 | 世界上大部分国家的文字 |
由于历史原因,MySQL 中的 utf8 编码与标准 UTF-8(RFC 3629)存在差异:
- 标准 UTF-8 规定一个字符最多使用 4 字节。
- MySQL 中的 utf8 编码最多使用 3 字节,无法存储 emoji 等特殊字符。
为解决该问题,MySQL 从 5.5.3 版本开始新增 utf8mb4 编码,一个字符最多 4 字节,完全兼容标准 UTF-8。如需支持完整的 UTF-8 规范(含特殊符号),建议使用 utf8mb4。
校对集
校对集(Collation)指字符之间的比较规则,用于字符串的排序和比较操作。每个字符集都有一个或多个对应的校对集,其中有一个为默认校对集(Default collation)。校对集的选择会影响查询结果的排序顺序和大小写敏感性。
校对集名称通常由三部分组成,用下划线 _ 分隔:
- 开头:对应的字符集名称(如
latin1、utf8)。 - 中间:国家名或
general(表示通用)。 - 结尾:
ci、cs或bin,分别表示:ci:不区分大小写(Case Insensitive);cs:区分大小写(Case Sensitive);bin:以二进制方式进行比较(Binary)。
查看 MySQL 支持的所有校对集:
SHOW COLLATION;字符集和校对集的设置
字符集和校对集的设置分为四个方面:MySQL 环境、数据库、数据表以及字段。
MySQL 环境
查看与字符集相关的变量:
SHOW VARIABLES LIKE 'character%';mysql> show variables like 'character%';
+--------------------------+-----------------------------+
| Variable_name | Value |
+--------------------------+-----------------------------+
| character_set_client | gbk |
| character_set_connection | gbk |
| character_set_database | utf8mb4 |
| character_set_filesystem | binary |
| character_set_results | gbk |
| character_set_server | utf8mb4 |
| character_set_system | utf8mb3 |
| character_sets_dir | D:\mysql267\share\charsets\ |
+--------------------------+-----------------------------+
8 rows in set, 1 warning (0.193 sec)上述结果表示当前会话使用的字符集,不同客户端环境中输出可能不同:
- 会话指从客户端登录服务器到退出的整个过程;依次打开两个客户端并登录,就产生两个会话。
- 不同客户端可以设置不同的字符环境配置。
各变量含义:
| character_set_client     | 客户端字符集
| character_set_connection | 客户端与服务器连接使用的字符集
| character_set_database   | 默认数据库使用的字符集
| character_set_filesystem | 文件系统字符集
| character_set_results    | 将查询结果返回给客户端的字符集
| character_set_server     | 服务器默认字符集
| character_set_system     | 服务器用来储存标识符的字符集
| character_sets_dir | 安装字符集的目录character_set_server决定新建数据库默认使用的字符集;数据库的字符集决定数据表的默认字符集,数据表的字符集决定字段的默认字符集。character_set_client、character_set_connection和character_set_results分别对应客户端、连接层和查询结果的字符集。通常三者保持一致,具体由客户端的编码决定,从而保证输入字符和查询结果均不出现乱码。
通过 SET 变量名 = 值; 可更改变量的值:
SET character_set_client = gbk;
SET character_set_connection = gbk;
SET character_set_results = gbk;
MySQL 还提供快捷命令 SET NAMES 字符集;,可一次性修改以上三个变量:
SET NAMES gbk;- 使用
SET或SET NAMES修改字符集仅对当前会话有效,不影响其他会话;会话结束后,下次连接仍使用默认值。 - 与
character_set_connection、character_set_database、character_set_server对应的校对集分别由变量collation_connection、collation_database、collation_server指定。 - 若字段使用
utf8字符集而客户端使用gbk字符集,MySQL 会自动进行编码转换。由于二者属于不同字符集,大部分常见字符可成功转换,但遇到某个字符集中不存在的特殊字符时可能出现乱码。
数据库
创建数据库时设定字符集和校对集的语法:
[DEFAULT] CHARACTER SET [=] charset_name
[DEFAULT] COLLATE [=] collation_name
CHARACTER SET用于指定字符集,COLLATE用于指定校对集。- 若创建数据库时未指定,则继承服务器系统变量
character_set_server和collation_server的当前值。 - 若仅指定字符集,则使用该字符集的默认校对集;若仅指定校对集,则使用该校对集对应的字符集。
[DEFAULT]是可选修饰词,仅增强语句可读性,写不写结果都一样,后续语法同理。
-- 创建数据库,指定字符集为 utf8,使用默认校对集 utf8_general_ci
CREATE DATABASE mydb_1 CHARACTER SET utf8;

-- 创建数据库,指定字符集为 utf8,校对集为 utf8_bin
CREATE DATABASE mydb_2 CHARACTER SET utf8 COLLATE utf8_bin;
数据表
数据表的字符集与校对集在表选项中设定,语法与数据库级类似;若未指定,则自动使用该数据库的字符集。
[DEFAULT] CHARACTER SET [=] charset_name
[DEFAULT] COLLATE [=] collation_nameCREATE TABLE my_charset (
username VARCHAR(20)
) CHARACTER SET utf8 COLLATE utf8_bin;上述语句创建了 my_charset 表,指定字符集为 utf8,校对集为 utf8_bin。
CHARACTER SET可简写为CHARSET。- 通过
SHOW CREATE TABLE my_charset;查看建表语句,其中字符集和校对集的设置会显示为DEFAULT CHARACTER SET=utf8 COLLATE=utf8_bin的形式。
字段
字段的字符集与校对集可在字段属性中单独设定;若未指定,则自动继承该数据表的设置。
[CHARACTER SET charset_name] [COLLATE collation_name]CREATE TABLE my_charset (
username VARCHAR(20) CHARACTER SET utf8 COLLATE utf8_bin
);上述语句为 username 字段单独指定字符集 utf8、校对集 utf8_bin,该设置覆盖表级别的字符集与校对集。
数据库设计
数据库设计通常划分为六个阶段:需求分析、概念数据库设计、逻辑数据库设计、物理数据库设计、数据库实施,以及数据库运行和维护。
- 需求分析:深入调研与分析用户需求,整理为需求分析报告。关键在于双方充分沟通,防止因理解偏差影响后续开发。主要工作包括:
- 收集数据:企业内部数据常分散于不同部门和人员手中,需全面归集,同时理解业务流程、数据处理方式及性能要求,可借助数据流图等工具辅助梳理。
- 解决冲突:处理命名冲突(同名异义、异名同义)、属性冲突和结构冲突。例如,商品库存是否包含已下单未出库数量;到货量与入库量以何为准;用户名、昵称与真实姓名的区分;性别采用“男/女”、“0/1”还是“f/m”表示等。
- 制定数据标准:明确编码规则,如商品编号的位数、扩展性、每位含义;订单编号的生成规则、防重复机制、包含的信息,以及是否引入随机数防止被猜测等。
- 概念数据库设计:将用户需求综合、归纳与抽象,形成概念模型,使设计人员摆脱具体数据库技术细节,集中分析数据及其内在联系,通常通过绘制 E-R 图直观呈现对需求的理解。
- 逻辑数据库设计:面向具体数据库系统,将概念设计成果(如 E-R 图)转换为 DBMS 支持的数据模型(如关系模型),完成实体、属性及联系的转换。此阶段需遵循规范化理论(如范式),避免数据冗余、插入异常、删除异常等问题。
- 物理数据库设计:确定数据库的存储结构和文件类型等。DBMS 通常已承担大部分工作以保证独立性与可移植性,设计人员主要需结合硬件与操作系统特性,选择合适的存储引擎和字段数据类型,并评估磁盘空间需求。
- 数据库实施:将设计成果落地,包括使用 SQL 语句创建数据库、数据表,编写并调试应用程序等。
- 数据库运行和维护:系统正式投入生产后,持续进行维护、调整、备份及升级等工作。
数据库设计范式
数据库设计对数据的存储性能和操作有重要影响。为避免不规范设计导致的数据冗余、插入异常、删除异常和更新异常等问题,需满足一定的规范化要求,即范式(Normal Form)。
范式按约束程度分为多个级别,最常用的是第一范式(1NF)、第二范式(2NF)和第三范式(3NF),由 Edgar Frank Codd 于 1971 年相继提出,此后又发展出 Boyce-Codd 范式(BCNF)、第四范式(4NF)和第五范式(5NF)等。实际工程中,数据库设计通常满足第三范式即可。
第一范式(1NF)
第一范式要求数据库表中的每一列都是不可再分的基本数据项,即同一列中不能包含多个值,也不能有重复的属性。换言之,实体的某个属性必须具有原子性,不可再分割为更小的字段。
用户联系方式表 1(问题:联系方式列包含多个值)
| 编号 | 联系方式 |
|---|---|
| 1 | 张三 邮箱: zhangsan@example.com, 手机号: 18900000000 |
| 2 | 李四 邮箱: lisi@example.com, 手机号: 15900000000, 17300000000 |
问题:“联系方式”列包含用户名、邮箱、手机号等多个信息,且手机号可能有多个,该列可进一步拆分为更基本的字段,违反 1NF 的原子性要求。
用户联系方式表 2(问题:重复属性)
| 编号 | 用户名 | 邮箱 | 手机号 | 手机号 |
|---|---|---|---|---|
| 1 | 张三 | zhangsan@example.com | 18900000000 | |
| 2 | 李四 | lisi@example.com | 15900000000 | 17300000000 |
问题:表中出现两列同名“手机号”,表示重复的属性,同样违反 1NF(同一列不能有多个值,且属性不应重复)。
为满足 1NF,应将用户和联系方式拆分为两个表保存,两表之间为一对多联系。
用户表
| 用户编号 | 用户名 |
|---|---|
| 1 | 张三 |
| 2 | 李四 |
联系方式表
| 编号 | 用户编号 | 联系方式 | 具体值 |
|---|---|---|---|
| 1 | 1 | 邮箱 | zhangsan@example.com |
| 2 | 1 | 手机号 | 18900000000 |
| 3 | 2 | 邮箱 | lisi@example.com |
| 4 | 2 | 手机号 | 15900000000 |
| 5 | 2 | 手机号 | 17300000000 |
用户表中“用户编号”为主键,联系方式表中的“用户编号”为外键,用于关联用户表。每个用户可拥有多条联系方式记录,从而保证每列均为不可再分的原子值,满足第一范式要求。
第二范式(2NF)
第二范式建立在第一范式的基础上,要求实体的属性完全依赖于主键,不能仅依赖主键的一部分(针对复合主键而言)。简言之,非主键字段需完全依赖主键。
订单表
订单编号 |
订单商品 | 购买件数 | 下单时间 |
|---|---|---|---|
| 1 | 铅笔 | 3 | 2019-01-20 8:30 |
| 2 | 钢笔 | 2 | 2019-01-20 8:30 |
| 3 | 圆珠笔 | 1 | 2019-02-12 9:20 |
用户表
用户编号 |
订单编号 |
用户名 | 付款状态 |
|---|---|---|---|
| 1 | 1 | 张三 | 已支付 |
| 1 | 2 | 张三 | 未支付 |
| 2 | 3 | 李四 | 已支付 |
在用户表中,用户编号和订单编号组成复合主键:付款状态完全依赖复合主键,而用户名只依赖用户编号(部分依赖),因此不满足第二范式。
这种设计存在以下问题:
- 插入异常:若一个用户没有下过订单,则该用户无法被插入。
- 删除异常:若删除一个用户的所有订单,则该用户信息也会被一并删除。
- 更新异常:由于用户名冗余,修改用户名时需要更新多条记录,一旦漏改就会出现数据不一致。
为满足第二范式,需将复合主键中的一部分(订单编号)作为独立主键,并将依赖该主键的属性分离出来,使每个表的非主键属性都完全依赖于各自的主键:
- 订单表:以“订单编号”为主键,包含“用户编号”(外键)、“下单时间”、“付款状态”等与订单直接相关的字段。
- 用户表:以“用户编号”为主键,包含“用户名”等仅依赖用户本身的属性。
这样,用户名不再出现在订单表中,消除了部分函数依赖,满足第二范式,同时避免了上述异常问题。
用户表
| 用户编号 | 用户名 |
|---|---|
| 1 | 张三 |
| 2 | 李四 |
订单表
| 订单编号 | 用户编号 | 订单商品 | 购买件数 | 下单时间 | 付款状态 |
|---|---|---|---|---|---|
| 1 | 1 | 铅笔 | 3 | 2019-01-20 8:30 | 已支付 |
| 2 | 1 | 钢笔 | 2 | 2019-01-20 8:30 | 未支付 |
| 3 | 2 | 圆珠笔 | 1 | 2019-02-12 9:20 | 已支付 |
第三范式(3NF)
第三范式建立在第二范式的基础上,要求数据表中每一列数据都和主键直接相关,而不能间接相关。简言之,非主键字段不能相互依赖。
用户表(不满足 3NF)
| 用户编号 | 用户名 | 用户等级 | 享受折扣 |
|---|---|---|---|
| 1 | 张三 | 1 | 0.95 |
| 2 | 李四 | 1 | 0.95 |
| 3 | 王五 | 2 | 0.85 |
表中用户享受的折扣与用户等级相关:折扣依赖于等级,等级依赖于用户编号,属于传递依赖。这种设计存在以下问题:
- 插入异常:新插入用户的等级若在 1、2 之外,其享受的折扣无处参考。
- 删除异常:若删除某个等级下的所有用户,该等级对应的折扣也被删除。
- 更新异常:修改某个用户的等级时,折扣必须随之修改;修改某个等级的折扣时,又因折扣存在冗余而容易漏改。
要满足第三范式,应将等级和折扣分离到独立的等级表中,用户表中只保留用户编号和等级(外键),折扣信息由等级表管理,从而消除传递依赖。
用户表
| 用户编号 | 用户名 | 用户等级 |
|---|---|---|
| 1 | 张三 | 1 |
| 2 | 李四 | 1 |
| 3 | 王五 | 2 |
等级表
| 用户等级 | 享受折扣 |
|---|---|
| 1 | 0.95 |
| 2 | 0.85 |
函数依赖:函数依赖(Functional Dependency)是由数学派生的术语,是数据依赖的一种类型,表示根据一个属性(或属性集)的值可以确定另一个属性(或属性集)的值。例如,将商品关系模式中的属性“商品 id”设为 X,属性集(商品名称、商品价格)设为 Y,根据 X 可以确定 Y,说明 X 决定了 Y,Y 函数依赖于 X,记为 X → Y。
函数依赖按依赖属性的不同分为完全函数依赖、部分函数依赖和传递函数依赖:
- 完全函数依赖:使用订单编号和用户编号可以决定付款状态;而只有订单编号无法决定是哪个用户创建了订单,只有用户编号也无法决定是哪个订单。因此,付款状态完全函数依赖于(订单编号、用户编号)属性集。
- 部分函数依赖:用户名依赖用户编号,但不依赖订单编号,因此用户名部分函数依赖于(订单编号、用户编号)属性集。
- 传递函数依赖:享受折扣依赖用户等级,用户等级依赖用户编号,所以享受折扣传递函数依赖于用户编号。
由此可见:第一范式限定关系模式的所有属性都是不可分的基本数据项,第二范式消除了部分函数依赖,第三范式消除了传递函数依赖。
反范式(逆规范化):反范式是一种逆规范化设计,目的是提高查询效率。范式虽然减少了数据冗余,但增加了表的数量,使查询变得复杂,尤其是多表连接查询时会降低查询性能。例如,商品销量可以通过查询订单表中的购买记录计算得出,当需要查询大量商品的销量时,就要花费许多时间计算。
为提高查询效率,可以在商品表中增加一个销量字段,商品被购买时更新该字段,而不必每次查询都计算销量。这种方式的缺点是容易出现数据不一致,例如用户购买商品后程序意外未更新销量,销量数据就有误。
实际开发中若采用反范式设计,应提前评估可能出现的问题并准备解决方案,例如通过存储过程操作、定期检查数据一致性等。
数据建模工具
在数据库设计过程中,对于业务复杂、修改频繁的场合,手工绘制 E-R 图非常低效,可利用数据建模工具提高效率。常见的数据建模工具有 ERwin Data Modeler、Power Designer、MySQL Workbench 等。
单表操作
复制表结构和数据
复制已有的表结构
创建一个与已有数据表相同结构的数据表(只复制结构,不复制数据):
CREATE [TEMPORARY] TABLE [IF NOT EXISTS] 表名
{ LIKE 旧表名 | (LIKE 旧表名) }- 复制原表的列定义、主键、索引、约束。
- 不复制数据,新表为空表。
- 不复制外键、触发器、分区等(MySQL 8.0 中
LIKE会复制生成列,即表内部的公式,复制时照抄公式,但不会复制外键约束)。
创建表时复制数据
CREATE [TEMPORARY] TABLE [IF NOT EXISTS] 表名
    [(列定义 [, 列定义] ...)]
    [表选项 (如 ENGINE=InnoDB, CHARSET=utf8mb4, ...)]
    [AS] 查询语句 (SELECT ...);
表选项用于指定存储引擎、字符集、注释等。
-- 只复制数据
CREATE TABLE scores_data_only AS
SELECT * FROM scores;

-- 使用 WHERE 1=0 让 SELECT 返回空集
CREATE TABLE scores_empty_struct AS
SELECT * FROM scores WHERE 1=0;
-- 结果:新表有相同的列名和类型,但没有任何数据,也没有主键和索引

CREATE TABLE scores_with_pk (
    id INT PRIMARY KEY AUTO_INCREMENT,  -- 手动指定主键和自增
    name VARCHAR(20),
    subject VARCHAR(20),
    score INT
) AS
SELECT * FROM scores;  -- 查询结果的数据会塞进上面定义的列里
-- 此时新表不仅有了数据,还拥有了主键和自增属性| 特性 | CREATE ... LIKE |
CREATE ... AS SELECT |
|---|---|---|
| 复制主键/索引/自增 | ✅ 自动保留 | ❌ 必须手动定义或丢失 |
| 复制默认值 | ✅ 自动保留 | ❌ 必须手动定义或丢失 |
| 复制数据 | ❌ 不复制 | ✅ 可以灵活选择复制哪些数据 |
| 复制生成列 | ✅ 保留 | ❌ 转为普通列(丢失计算公式) |
复制已有数据
数据复制(也称蠕虫复制):从已有的数据中获取数据,并将获取到的数据插入到对应的数据表中,从而实现数据的成倍增加。
此种方式要求获取数据与插入数据的表结构相同,否则可能插入不成功。
INSERT [INTO] 数据表名1 [(字段列表)] SELECT [字段列表] FROM 数据表名2;- 数据表名 1 是目标表(插入数据的表),数据表名 2 是源表(提供数据的表)。
- 若字段列表省略,则默认所有字段对应插入。
- 常用于同一个表(如
my_goods表)的自我复制,可在短期内快速增加数据量,用于测试表的压力及效率。
主键冲突问题:若目标表中含有主键(且主键具有唯一性),再次执行相同复制语句时可能因主键重复而报错。例如:
INSERT INTO mydb.my_goods SELECT * FROM sh_goods;
----
ERROR 1062 (23000): Duplicate entry '1' for key 'PRIMARY'为避免主键冲突,可以指定除主键外的字段列表进行复制,让主键自动生成或手动赋值。例如:
INSERT INTO mydb.my_goods (category_id, name, keyword, price, content)
SELECT category_id, name, keyword, price, content
FROM sh_goods;临时表是一种仅在当前会话中可见、并在当前会话关闭时自动删除的数据表,主要用于临时存储数据。创建临时表只需在 CREATE 与 TABLE 关键字之间添加 TEMPORARY 关键字。创建临时表有两种方式:
-- 方式 1:定义结构创建
CREATE TEMPORARY TABLE mydb.tmp_table1 (id INT);

-- 方式 2:从查询结果创建(复制结构和数据)
CREATE TEMPORARY TABLE mydb.tmp_table2 SELECT id, name FROM shop.sh_goods;- 创建临时表时可以指定 MySQL 服务器中存在的数据库,也可以指定不存在的数据库。若数据库不存在,后续操作临时表时必须使用
数据库.临时表名的格式来引用。 - 临时表支持常规的
SELECT、INSERT、UPDATE、DELETE等操作,用法与普通表一致。 SHOW TABLES命令无法查看临时表。- 临时表不支持使用
RENAME TABLE ... TO重命名,只能通过ALTER TABLE修改表名。
解决主键冲突
在对数据表插入数据时,若表中的主键含有实际的业务意义,插入数据时若不能确定对应的主键是否存在,往往会出现主键冲突的情况。例如,mydb.my_goods 表经过数据复制以后,再插入编号为 20 的商品信息(橡皮,用于修正书写错误):
INSERT INTO mydb.my_goods (id, name, content, keyword)
VALUES (20, '橡皮', '修正书写错误', '文具');
----
ERROR 1062 (23000): Duplicate entry '20' for key 'PRIMARY'
系统提示插入数据的主键发生冲突。MySQL 提供了两种解决方式:主键冲突更新和主键冲突替换。
主键冲突更新
在插入数据时若发生主键冲突,则将该插入操作转为更新操作。基本语法格式:
INSERT [INTO] 数据表名 [(字段列表)] {VALUES | VALUE} (值列表)
ON DUPLICATE KEY UPDATE 字段名1 = 新值1 [, 字段名2 = 新值2] ...;
示例:插入 id = 20 的商品信息,若主键已存在则更新其名称、内容和关键词。
INSERT INTO mydb.my_goods (id, name, content, keyword)
VALUES (20, '橡皮', '修正书写错误', '文具')
ON DUPLICATE KEY UPDATE
    name = '橡皮',
    content = '修正书写错误',
    keyword = '文具';
主键冲突替换
在插入数据时若发生主键冲突,则先删除该条记录,再重新插入。基本语法格式:
REPLACE [INTO] 数据表名 [(字段列表)]
{VALUES | VALUE} (值列表) [, (值列表)] ...
示例:使用 REPLACE 插入 id = 20 的商品信息。
REPLACE INTO mydb.my_goods (id, name, content, keyword)
VALUES (20, '橡皮', '修正书写错误', '文具');
验证插入结果:
SELECT name, content, keyword FROM mydb.my_goods WHERE id = 20;清空数据
除了使用 DELETE 语句删除数据外,还可以使用如下指令:
TRUNCATE [TABLE] 表名TRUNCATE 与 DELETE 的区别:
- 实现方式不同:
TRUNCATE本质是先执行DROP删除数据表,再根据有效的表结构文件(.frm)重新创建表来实现数据清空;而DELETE是逐条删除表中的记录。 - 执行效率不同:对于大型数据表(如千万级记录),
TRUNCATE的清除效率远高于DELETE;但对于小型数据集,DELETE效率一般更高。 - 对 AUTO_INCREMENT 的影响不同:
TRUNCATE清空后,自动增长字段会从默认初始值重新开始;而DELETE删除记录后,自动增长值保持不变。 - 删除范围不同:
TRUNCATE只能清空全部记录;DELETE可通过WHERE条件删除部分记录。 - 返回值含义不同:
TRUNCATE的返回值通常无意义;DELETE返回被删除的记录数。 - SQL 语言分类不同:
DELETE属于 DML(数据操作语言);TRUNCATE通常被视为 DDL(数据定义语言)。
去除重复数据
SELECT DISTINCT 选项 字段列表 FROM 数据表select选项默认值为ALL,表示保留所有查询到的记录。- 当设置为
DISTINCT时,表示去除重复记录,只保留一条。 SELECT DISTINCT a, b是按 a 和 b 的联合组合来去重的。
排序和限量
排序
为了使查询结果满足用户需求,通常会对查询出的数据进行升序或降序排序。MySQL 提供了两种排序方式:
- 单字段排序:按一个字段进行排序。
- 多字段排序:按多个字段进行排序(先按第一个字段排序,若相同再按第二个字段排序,以此类推)。
--- 单字段排序的基本语法格式:
SELECT
	* | (字段列表)
FROM
	数据表名
ORDER BY 字段名 [ASC | DESC];

-- 多字段排序的基本语法格式:
SELECT
	* | {字段列表}
FROM
	数据表名
ORDER BY
字段名1 [ASC | DESC] [, 字段名2 [ASC | DESC]] ...;-
当数据表的字符集为
utf8时,默认不会按中文拼音顺序排序。若需按中文拼音排序,可以使用CONVERT(字段名 USING gbk)函数强制转换,例如:SQL1 行ORDER BY CONVERT(name USING gbk) ASC;
限量
限制记录数
问题:对于一次性查询出的大量记录,不仅不便于阅读查看,还会浪费系统效率。
SELECT
	[select 选项] 字段列表
FROM
	数据表名
[WHERE 条件表达式]
[ORDER BY 字段 ASC|DESC]
LIMIT [OFFSET, ] 记录数;记录数:表示限定获取的最大记录数量。若记录数大于实际符合要求的记录数,则以实际记录数为准。- 当
LIMIT后仅含记录数参数时,表示从第 1 条记录开始获取。 OFFSET(偏移量)为可选项,用于设置从哪条记录开始。MySQL 中第 1 条记录的偏移量为0,第 2 条为1,依此类推。
更新与删除操作的排序和限量
在 MySQL 中,除了对查询记录进行排序和限量外,对数据表中记录的更新与删除操作也可以进行排序和限量。
数据更新的排序与限量:
UPDATE 数据表名 SET 字段 = 新值, ... [WHERE 条件表达式]
ORDER BY 字段 ASC|DESC LIMIT 记录数;
数据删除的排序与限量:
DELETE FROM 数据表名 [WHERE 条件表达式]
ORDER BY 字段 ASC|DESC LIMIT 记录数;
ORDER BY用于指定按某个字段的顺序(升序或降序)来更新或删除符合条件的记录。- 若未添加
WHERE条件,则可以使用LIMIT限制受影响的行数。
示例:将 sh_goods 表中价格最便宜的两种商品的库存设置为 500。
UPDATE sh_goods SET stock = 500
ORDER BY price ASC
LIMIT 2;
该语句会先按价格升序排列,然后只更新前两条记录(即价格最低的两件商品),将其库存修改为 500。
分组与聚合函数
分组
在 MySQL 中,可以使用 GROUP BY 根据一个或多个字段进行分组,字段值相同的记录归为一组。对于分组后的数据,可以使用 HAVING 进行条件筛选。
分组统计
SELECT [select 选项]
	字段列表
FROM
	数据表名
[WHERE 条件表达式]
GROUP BY 字段名;
在 MySQL 5.7 及更高版本中(默认启用 ONLY_FULL_GROUP_BY 模式),SELECT 后的字段列表只能是分组字段(即 GROUP BY 中出现的字段),或者是使用了聚合函数(如 COUNT、SUM、AVG、MAX、MIN 等)的非分组字段。若直接获取未分组的非聚合字段,MySQL 会报错。
分组排序
分组后可以配合 ORDER BY 排序:
SELECT [select 选项]
	字段列表
FROM 数据表名
[WHERE 条件表达式]
GROUP BY 字段名
ORDER BY 字段名 [ASC | DESC];
问题记录
Q:在 MySQL 中,table1 有 a、b、c 三个字段,table2 有 b、c、d 三个字段,现在将它们按照 b 内连接,然后 GROUP BY table1.c 和 GROUP BY table2.c 有区别吗?
A:在绝大多数场景下,二者返回的结果并不相同。
table1(按 b=1 连接):
| a | b | c |
|---|---|---|
| 1 | 1 | A |
| 2 | 1 | B |
table2(按 b=1 连接):
| b | c | d |
|---|---|---|
| 1 | X | 10 |
| 1 | Y | 20 |
执行 INNER JOIN 后,由于 b=1 匹配,会生成 4 行中间结果:
| a | b | t1.c | t2.c | d |
|---|---|---|---|---|
| 1 | 1 | A | X | 10 |
| 1 | 1 | A | Y | 20 |
| 2 | 1 | B | X | 10 |
| 2 | 1 | B | Y | 20 |
- 按
table1.c分组:会分成 A 和 B 两个组,每组各有 2 行数据。 - 按
table2.c分组:会分成 X 和 Y 两个组,每组也各有 2 行数据。
结论:分组依据的“标签”都不同了,聚合计算(如 COUNT(*)、SUM(d))自然针对的是完全不同的数据集合。
即使 table1.c 和 table2.c 存的值恰好一样,如果是一对多或多对多的关系,结果依然不同。
table1(b=1 有多行):
| a | b | c |
|---|---|---|
| 1 | 1 | A |
| 2 | 1 | A |
table2(b=1 有多行):
| b | c | d |
|---|---|---|
| 1 | A | 10 |
| 1 | B | 20 |
执行 INNER JOIN 后,由于 b=1 匹配,会生成 4 行中间结果:
| a | b | t1.c | t2.c | d |
|---|---|---|---|---|
| 1 | 1 | A | A | 10 |
| 1 | 1 | A | B | 20 |
| 2 | 1 | A | A | 10 |
| 2 | 1 | A | B | 20 |
- 按
table1.c分组:所有table1.c = 'A'的行归为一组。 - 按
table2.c分组:table2.c = 'A'的行和= 'B'的行分成两组。
这两个分组策略完全不同,因为参与分组的依据来自不同的表。
多分组统计
MySQL 还支持按照某个字段分组后,再对已分组的数据进行再次分组,以实现多分组统计。
SELECT [select 选项]
	字段列表
FROM 数据表名
[WHERE 条件表达式]
GROUP BY 字段名1 [ASC | DESC] [, 字段名2 [ASC | DESC]] ...;
回溯统计
回溯统计(WITH ROLLUP):在根据指定字段分组后,系统自动对分组的字段向上进行一次新的统计,并产生一个新的统计数据,且该数据对应的分组字段值为 NULL。基本语法格式:
SELECT [select 选项] 字段列表 FROM 数据表名
[WHERE 条件表达式]
GROUP BY 字段名1 [ASC | DESC] [, 字段名2 [ASC | DESC]] ... WITH ROLLUP;
WITH ROLLUP与ORDER BY互斥:同一查询中两者不能同时使用。
CREATE TABLE sales (
    category VARCHAR(20),   -- 商品类型
    product  VARCHAR(20),   -- 商品名称
    amount   INT            -- 销售额
);

INSERT INTO sales VALUES
('电子产品', '手机',   5000),
('电子产品', '电脑',   8000),
('电子产品', '耳机',   1000),
('服装',     '外套',   2000),
('服装',     '裤子',   1500),
('食品', '零食', 500);SELECT category, SUM(amount) AS total
FROM sales
GROUP BY category;+----------+-------+
| category | total |
+----------+-------+
| 服装 | 3500 |
| 电子产品 | 14000 |
| 食品 | 500 |
| NULL | 18000 |
+----------+-------+
4 rows in set (0.009 sec)SELECT category, product, SUM(amount) AS total
FROM sales
GROUP BY category, product WITH ROLLUP;+----------+---------+-------+
| category | product | total |
+----------+---------+-------+
| 服装 | 外套 | 2000 |
| 服装 | 裤子 | 1500 |
| 服装 | NULL | 3500 |
| 电子产品 | 手机 | 5000 |
| 电子产品 | 电脑 | 8000 |
| 电子产品 | 耳机 | 1000 |
| 电子产品 | NULL | 14000 |
| 食品 | 零食 | 500 |
| 食品 | NULL | 500 |
| NULL | NULL | 18000 |
+----------+---------+-------+
10 rows in set (0.010 sec)如果业务数据中本身就存在 NULL 值,为了准确识别哪些行是汇总行,MySQL 提供了 GROUPING() 函数。它在汇总行返回 1,在普通数据行返回 0。
+----------+---------+-------+-------+--------+
| category | product | total | g_cat | g_prod |
+----------+---------+-------+-------+--------+
| 服装     | 外套    |  2000 |     0 |      0 |
| 服装     | 裤子    |  1500 |     0 |      0 |
| 服装     | NULL    |  3500 |     0 |      1 |
| 电子产品 | 手机    |  5000 |     0 |      0 |
| 电子产品 | 电脑    |  8000 |     0 |      0 |
| 电子产品 | 耳机    |  1000 |     0 |      0 |
| 电子产品 | NULL    | 14000 |     0 |      1 |
| 食品     | 零食    |   500 |     0 |      0 |
| 食品     | NULL    |   500 |     0 |      1 |
| NULL     | NULL    | 18000 |     1 |      1 |
+----------+---------+-------+-------+--------+
10 rows in set (0.009 sec)
g_cat = 1表示这一行的category是回溯产生的 NULL;g_prod = 1表示这一行的product是回溯产生的 NULL;- 都为 0 则是正常明细行。
统计筛选
当对查询的数据执行分组操作时,可以利用 HAVING 根据条件进行数据筛选,它与 WHERE 功能类似,但存在以下区别:
WHERE操作是从数据表中获取数据,将数据从磁盘存储到内存中;而HAVING是对已存放到内存中的数据进行操作。HAVING位于GROUP BY子句之后,而WHERE位于GROUP BY子句之前。HAVING关键字后可以使用聚合函数(如SUM、COUNT、AVG等),而WHERE则不可以。HAVING用于过滤分组后的结果,其条件应基于聚合函数(如MAX()、MIN()、COUNT()等)或分组列(即GROUP BY中的列)。WHERE中不能使用SELECT中定义的别名,因为执行WHERE时SELECT还没被执行,别名还不存在;但HAVING中可以使用SELECT中定义的别名。- 一般过滤原始数据用
WHERE,过滤分组后的统计结果用HAVING。
SELECT [select 选项]
	字段列表
FROM
	数据表名
[WHERE 条件表达式]
GROUP BY
	字段名 [ASC | DESC], ... [WITH ROLLUP]
HAVING
条件表达式;从 WHERE 条件之后的所有语句(包括 GROUP BY、WITH ROLLUP、HAVING)都是对内存中的数据进行操作。
使用别名
在 MySQL 中执行查询操作时,可以为字段、表达式、函数或数据表设置别名,以缩短名称长度或提高可读性。
字段别名语法:
SELECT 字段1 [AS] 别名1, 字段2 [AS] 别名2 [, ...] FROM 表名AS关键字可省略,用空格代替。例如category_id AS cid或category_id cid均可。
表别名语法:
SELECT 表别名.字段 [, ...] FROM 表名 [AS] 表别名- 同样,
AS可省略。表别名常用于多表连接查询,可简化表名引用。
示例:
SELECT category_id AS cid, AVG(price) AS avg_price
FROM sh_goods
GROUP BY category_id
ORDER BY cid;  -- 这里别名就起效了,不用再写 ORDER BY category_id
在 HAVING 中使用别名可以避免重复书写整个表达式:
SELECT
    category_id,
    SUM(price * stock) / SUM(stock)   -- 加权平均
FROM sh_goods
GROUP BY category_id
HAVING SUM(price * stock) / SUM(stock) > 100;
-- 这里必须把整个公式重新写一遍,极其冗余SELECT
category_id,
SUM(price * stock) / SUM(stock) AS weighted_avg_price
FROM sh_goods
GROUP BY category_id
HAVING weighted_avg_price > 100; -- 直接引用别名,干净利落聚合函数
| 函数名 | 描述 |
|---|---|
COUNT() |
返回参数字段的数量,不统计为 NULL 的记录(有字段时) |
SUM() |
返回参数字段之和 |
AVG() |
返回参数字段的平均值 |
MAX() |
返回参数字段的最大值 |
MIN() |
返回参数字段的最小值 |
GROUP_CONCAT() |
返回符合条件的参数字段值的连接字符串 |
JSON_ARRAYAGG() |
将符合条件的参数字段值作为单个 JSON 数组返回(MySQL 5.7.22 新增) |
JSON_OBJECTAGG() |
将符合条件的参数字段值作为单个 JSON 对象返回(MySQL 5.7.22 新增) |
COUNT()、SUM()、AVG()、MAX()、MIN()和GROUP_CONCAT()函数中可以在参数前添加DISTINCT关键字,表示对不重复的记录进行相关操作。COUNT()的参数设置为*时,表示统计符合条件的所有记录(包含 NULL 值)。
运算符
算术运算符
在数据库操作中,SELECT、UPDATE 和 DELETE 等语句均可使用条件表达式,用于获取、更新或删除符合给定条件的数据。
| 运算符 | 描述 | 示例 | 运算符 | 描述 | 示例 |
|---|---|---|---|---|---|
+ |
加运算 | SELECT 5+2; |
/ |
除运算 | SELECT 5/2; |
- |
减运算 | SELECT 5-2; |
% |
取模运算 | SELECT 5%2; |
* |
乘运算 | SELECT 5*2; |
- 运算符两端的数据可以是具体数值(如
5),也可以是数据表中的字段(如price)。 - 参与运算的数据称为操作数,操作数与运算符组合在一起称为表达式(如
5 + 2)。 - 在 MySQL 中,可以直接使用
SELECT查看运算结果,如上表中的示例所示。
无符号的加减乘法运算
在 MySQL 中,若运算符 + 和 * 的操作数均为无符号整型,则运算结果也保持无符号整型。例如,商品表 sh_goods 中的 id 字段即为无符号整型。以下查询对 sh_goods 表中前 5 条记录的 id 分别进行加 1、减 1 和乘 2 操作:
SELECT id, id + 1, id - 1, id * 2 FROM sh_goods LIMIT 5;| id | id + 1 | id - 1 | id * 2 |
|---|---|---|---|
| 1 | 2 | 0 | 2 |
| 2 | 3 | 1 | 4 |
| 3 | 4 | 2 | 6 |
| 4 | 5 | 3 | 8 |
| 5 | 6 | 4 | 10 |
有符号的减法运算
在 MySQL 中,默认情况下运算符 - 的操作数若都为无符号整型,则结果一定是无符号整型。若操作数的差值为负数,系统会报错。例如,对 sh_goods 表中前 5 条记录的 id 执行减 3 操作:
SELECT id - 3 FROM sh_goods LIMIT 5;执行结果报错:
ERROR 1690 (22003): BIGINT UNSIGNED value is out of range in '(`shop`.`sh_goods`.`id` - 3)'因为减法运算的结果为负数,超出了无符号整型的范围。无论运算符 - 的操作数是否含有符号,若要获得有符号的运算结果,可以使用 CAST(... AS SIGNED) 将无符号整型 id 强制转换为有符号整型。
SELECT CAST(id AS SIGNED) - 3 FROM sh_goods LIMIT 5;含有精度的运算
算术运算不仅适用于整数,也可对浮点数进行运算。精度规则:
- 加减运算:结果的精度(小数点后的位数)等于参与运算的操作数中的最大精度。例如
1.2 + 1.400,操作数最大精度为 3(1.400),结果精度为 3。 - 乘法运算:结果的精度等于参与运算的操作数精度之和。例如
1.2 * 1.400,1.2精度为 1,1.400精度为 3,结果精度为 4(1+3)。
‘/’ 运算
运算符 / 在 MySQL 中用于除法操作,且运算结果使用浮点数表示。浮点数的精度等于被除数(/ 运算符左侧的操作数)的精度加上系统变量 div_precision_increment 设置的除法精度增长值。若除数为 0,则结果为 NULL。
可通过以下语句查看 div_precision_increment 的默认值:
SHOW VARIABLES LIKE 'div_precision_increment';NULL 参与算术运算
在算术运算中,NULL 是一个特殊值,它参与的算术运算结果均为 NULL。例如,使用 NULL 参与加减乘除运算:
SELECT NULL + 1, NULL - 1, NULL * 2, NULL / 3;以上结果均为 NULL。
DIV 和 MOD 运算
在 MySQL 中,运算符 DIV 与 / 都能实现除法运算,区别在于 DIV 的运算结果会去掉小数部分,只返回整数部分(即整除)。示例:
SELECT 8 / 3, 8 DIV 3;| 8 / 3 | 8 DIV 3 |
|---|---|
| 2.6667 | 2 |
运算符 MOD 与 % 功能相同,都用于取模运算。示例:
SELECT 8 MOD 5, -8 MOD 5, 8 MOD -5, -8 MOD -5;| 8 MOD 5 | -8 MOD 5 | 8 MOD -5 | -8 MOD -5 |
|---|---|---|---|
| 3 | -3 | 3 | -3 |
取模运算符号规则:运算结果的正负与被模数(% 或 MOD 左侧的操作数)的符号相同,与模数(右侧操作数)的符号无关。
其它数学函数
| 函数 | 描述 |
|---|---|
CEIL(x) |
返回大于等于 x 的最小整数 |
FLOOR(x) |
返回小于等于 x 的最大整数 |
FORMAT(x, y) |
返回小数点后保留 y 位的 x(进行四舍五入) |
ROUND(x[, y]) |
计算离 x 最近的整数;若设置参数 y,与 FORMAT(x, y) 功能相同 |
TRUNCATE(x, y) |
返回小数点后保留 y 位的 x(舍弃多余小数位,不进行四舍五入) |
ABS(x) |
获取 x 的绝对值 |
MOD(x, y) |
求模运算,与 x % y 功能相同 |
PI() |
计算圆周率 |
SQRT(x) |
求 x 的平方根 |
POW(x, y) |
幂运算函数,计算 x 的 y 次方,与 POWER(x, y) 功能相同 |
RAND() |
默认返回 0 到 1 之间的随机数,包括 0 和 1 |
- 若要获取指定区间(
min ≤ num ≤ max)内的随机数,可使用表达式FLOOR(min + RAND() * (max - min + 1))或FLOOR(min + RAND() * (max - min))(取决于是否包含上限)。例如,获取 1 到 10 之间的随机整数:FLOOR(1 + RAND() * 10)。 - 可以在
RAND()中设置一个数(字符型、整数、浮点数都可以)作为随机种子,使得每次运行结果相同,如RAND(4)。
比较运算符
比较运算符常用于条件表达式中对结果进行限定。MySQL 中比较运算符的结果值有 3 种:1(TRUE,真)、0(FALSE,假)或 NULL。
| 运算符 | 描述 |
|---|---|
= |
用于相等比较 |
<=> |
可以进行 NULL 值比较的相等运算符 |
> |
表示大于比较 |
< |
表示小于比较 |
>= |
表示大于等于比较 |
<>、!= |
表示不等于比较 |
BETWEEN...AND... |
比较一个数据是否在指定的闭区间范围内,若在则返回 1,若不在则返回 0 |
NOT BETWEEN...AND... |
比较一个数据是否不在指定的闭区间范围内,若不在则返回 1,若在则返回 0 |
IS |
比较一个数据是否是 TRUE、FALSE 或 UNKNOWN,若是则返回 1,否则返回 0 |
IS NOT |
比较一个数据是否不是 TRUE、FALSE 或 UNKNOWN,若不是则返回 1,否则返回 0 |
IS NULL |
比较一个数据是否是 NULL,若是则返回 1,否则返回 0 |
IS NOT NULL |
比较一个数据是否不是 NULL,若不是则返回 1,否则返回 0 |
LIKE '匹配模式' |
获取匹配到的数据 |
NOT LIKE '匹配模式' |
获取匹配不到的数据 |
数据类型自动转换
在 MySQL 中,比较运算符可以对数字和字符串进行比较。若参与比较的操作数数据类型不同,MySQL 会自动将其转换为同类型数据后再进行比较。例如:
SELECT 5 >= '5', 3.0 <> 3;| 5 >= ‘5’ | 3.0 <> 3 |
|---|---|
| 1 | 0 |
比较结果为 NULL
比较运算符 =、>、<、>=、<=、<>、!= 在与 NULL 进行比较时,结果均为 NULL。例如:
SELECT 0 = NULL, NULL < 1, NULL > 2;| 0 = NULL | NULL < 1 | NULL > 2 |
|---|---|---|
| NULL | NULL | NULL |
当操作数中包含 NULL 时,上述比较运算符的结果均为 NULL。
= 与 <=> 的区别
运算符 = 与 <=> 均可用于比较数据是否相等,区别在于 <=> 可以对 NULL 值进行比较。例如:
SELECT NULL = NULL, NULL = 1, NULL <=> NULL, NULL <=> 1;| NULL = NULL | NULL = 1 | NULL <=> NULL | NULL <=> 1 |
|---|---|---|---|
| NULL | NULL | 1 | 0 |
BETWEEN…AND…
在条件表达式中,可使用 BETWEEN...AND... 判断一个数据是否在指定的闭区间范围内。基本语法:
BETWEEN 条件1 AND 条件2expr BETWEEN min AND max 等价于 (expr >= min) AND (expr <= max),表示条件 1 到条件 2 之间的范围(包含两端值),且条件 1 必须小于等于条件 2。
SELECT * FROM sh_goods WHERE price BETWEEN 2000 AND 6000;
-- 等价于
SELECT * FROM sh_goods WHERE price >= 2000 AND price <= 6000;
IS NULL
在条件表达式中,若需要判断字段是否为 NULL,应使用 MySQL 专门提供的 IS NULL 或 IS NOT NULL 运算符,而不是使用 = 或 <>(后两者在与 NULL 比较时结果恒为 NULL,无法正确判断)。
-- 获取 sh_goods 表中关键词不为空且价格最高的两件商品
SELECT id, name, price, keyword
FROM sh_goods
WHERE keyword IS NOT NULL  # 这里不能写成 keyword = NULL(永远返回 NULL,不是 TRUE)
ORDER BY price DESC
LIMIT 2;
LIKE 与 NOT LIKE
LIKE 运算符用于模糊匹配,NOT LIKE 用于获取匹配不到的数据,使用方式相同。
-- 需求:在 sh_goods 表中,获取商品名称中含有"笔"的商品 id、name、price 和 content
SELECT id, name, price, content
FROM sh_goods
WHERE name LIKE '%笔%';%:匹配任意长度的任意字符(包括零个字符)。_:匹配单个任意字符。
% 通配符举例:
| 查询模式 | 匹配的字符串 | 不匹配的字符串 | 原理解析 |
|---|---|---|---|
'张%' |
张三、张伟强、张 | 李四、小张 | 必须以“张”开头,后面跟任意个(0 个、1 个或多个)字符,所以单独的“张”也匹配。 |
'%科' |
百科、百科知识、科 | 科学、学科 | 必须以“科”结尾,前面跟任意个字符。注意单独的“科”匹配(前面 0 个字符)。 |
'%科技%' |
高科技公司、科技、学科技术 | 高技公司 | 只要字符串中包含“科技”两个字即可。 |
'%' |
所有非 NULL 字符串(包括空字符串 '') |
NULL 值 |
因为 % 可以代表任意个数的任意字符,所以它匹配一切非空文本。 |
_ 通配符举例:
| 查询模式 | 匹配的字符串 | 不匹配的字符串 | 原理解析 |
|---|---|---|---|
'张_' |
张三、张四、张A | 张、张三四 | 必须是两个字符,第一个是“张”,第二个任意。 |
'___' |
abc、123、中A1 | ab、abcd | 字符串长度必须恰好是 3(不论是中文、英文还是数字)。 |
'_科技' |
高科技、低科技、1科技 | 科技 | 前面必须有一个任意字符,后面紧跟“科技”。 |
在 MySQL 中查询数据时,除了可以使用 LIKE 实现模糊查询,还可以利用 REGEXP 关键字指定正则匹配模式,轻松完成更为复杂的查询。正则表达式常用模式:
| 模式 | 描述 | 示例(匹配条件) | 匹配示例 | 不匹配示例 |
|---|---|---|---|---|
^ |
匹配字符串的开始位置 | '^张' |
张三、张伟 | 小张、王张 |
$ |
匹配字符串的结束位置 | '有限公司$' |
腾讯有限公司 | 有限公司北京分公司 |
. |
匹配除换行符 (\n) 外的任意单个字符 |
'a.b' |
aab, acb, a1b | ab, aab(只匹配单个字符) |
[...] |
字符集合,匹配方括号内的任意一个字符 | '[abc]' |
a, b, c | d, e |
[^...] |
负值字符集合,匹配不在方括号内的任意一个字符 | '[^abc]' |
d, e, 1 | a, b, c |
* |
匹配前面的元素零次或多次 | 'a*' |
(空), a, aa, aaa | 严格要求匹配其他字符时 |
+ |
匹配前面的元素一次或多次 | 'a+' |
a, aa, aaa | (空) |
? |
匹配前面的元素零次或一次 | 'a?' |
(空), a | aa, aaa |
{n} |
匹配前面的元素恰好 n 次 | 'a{2}' |
aa | a, aaa |
{n,} |
匹配前面的元素至少 n 次 | 'a{2,}' |
aa, aaa | a |
{n,m} |
匹配前面的元素至少 n 次,至多 m 次 | 'a{2,4}' |
aa, aaa, aaaa | a, aaaaa |
| |
交替,匹配符号左右两侧的任意一个模式 | 'com|cn' |
com, cn | org, net |
(...) |
分组,将括号内的元素作为一个整体 | '(ab)+' |
ab, abab | a, b, aba |
[[:<:]] |
匹配单词的开头 | '[[:<:]]for' |
forget, for | before(for 不在开头) |
[[:>:]] |
匹配单词的结尾 | 'ack[[:>:]]' |
black | blackbird(ack 不在结尾) |
[:class:] |
匹配特定的字符类 | '[[:digit:]]' |
1, 2, 3 | a, b, c |
示例:获取 sh_goods 表中 content(描述)字段内含有“人”或“必备”词语的商品 id、name 和 content 字段内容:
SELECT id, name, content
FROM sh_goods
WHERE content REGEXP '人|必备';
REGEXP 与 RLIKE 是同义词。
其它比较函数
| 函数 | 描述 |
|---|---|
IN() |
比较一个值是否在一组给定的集合内 |
NOT IN() |
比较一个值是否不在一组给定的集合内 |
GREATEST() |
返回最大的一个参数值,至少两个参数 |
LEAST() |
返回最小的一个参数值,至少两个参数 |
ISNULL() |
测试参数是否为空 |
COALESCE() |
返回第一个非空参数 |
INTERVAL() |
返回小于第一个参数的参数索引 |
STRCMP() |
比较两个字符串 |
简单说明:
IN():常用于WHERE条件中,如id IN (1, 2, 3),只返回条件结果为TRUE的行。NOT IN():与IN()相反,表示不在集合内。GREATEST():返回多个值中的最大值,如GREATEST(10, 20, 5)返回20。LEAST():返回多个值中的最小值。ISNULL():判断参数是否为NULL,若是则返回1,否则返回0。COALESCE():返回参数列表中第一个非NULL的值,常用于提供默认值,如COALESCE(phone, '无电话')。INTERVAL():例如INTERVAL(10, 5, 15, 30)返回1,因为10大于5且小于15(索引从 0 开始,5的索引为 0,15的索引为 1)。STRCMP():比较两个字符串,若相同返回0,若第一个小于第二个返回-1,否则返回1。
关于 IN 的说明:
SELECT
    device_id, gender, age, university
FROM
    user_profile
WHERE
    university NOT IN ('复旦大学');
NULL 代表“未知值”。对于“未知值”,数据库无法判断它是否“不属于”复旦大学,因此整个条件的结果既不是 TRUE(真),也不是 FALSE(假),而是 UNKNOWN(未知)。
WHERE 子句只返回条件结果为 TRUE 的行。如果业务上需要将“学校为空”的记录也视为“不属于复旦大学”,需要显式加上 IS NULL 判断:
SELECT device_id, gender, age, university
FROM user_profile
WHERE university NOT IN ('复旦大学')
   OR university IS NULL;
如果 NOT IN 的括号里不是固定值,而是一个子查询(例如 WHERE university NOT IN (SELECT ...)),且子查询返回的结果集中包含 NULL,那么整个查询将返回空结果集(一条数据都没有)。
CASE 表达式
在 MySQL 中,CASE 表达式是一种条件判断工具,它类似于编程语言中的 if...else if...else 或 switch 语句。
需要特别注意的是:CASE 是一个表达式(Expression),而不是一个语句(Statement)。这意味着它只能返回一个值,通常用在 SELECT、WHERE、ORDER BY 和 GROUP BY 子句中。
CASE 表达式必须包含 CASE、WHEN、THEN、END 这四个关键部分,ELSE 是可选的。
CASE
    WHEN 条件1 THEN 结果1  -- 后面没有逗号
    WHEN 条件2 THEN 结果2
    ...
    ELSE 默认结果
END
注意事项:
- 数据类型必须一致:所有
THEN和ELSE返回的数据类型必须相同或可以隐式转换。比如不能第一个THEN返回数字1,第二个返回字符串'男',否则会报错。 - 短路原则(优先级):MySQL 会按
WHEN的顺序从上到下执行。一旦匹配到第一个满足条件的WHEN,就会执行对应的THEN并立即退出整个CASE,不会继续执行后面的WHEN。因此,粒度细的条件要写在前面,粒度粗的写在后面。
IF() 函数
IF() 函数可以在任何 SQL 查询语句(如 SELECT、WHERE)中直接使用,类似于 Excel 里的 IF 函数。
IF(条件表达式, 条件为真时的返回值, 条件为假时的返回值)逻辑运算符
逻辑运算符常用于条件表达式中的逻辑判断,与比较运算符结合使用。参与逻辑运算的操作数以及逻辑判断的结果只有 3 种:1(TRUE,真)、0(FALSE,假)或 NULL。
| 运算符 | 描述 |
|---|---|
AND 或 && |
逻辑与。操作数全部为真,则结果为 1;否则为 0 |
OR 或 || |
逻辑或。操作数中只要有一个为真,则结果为 1;否则为 0 |
NOT 或 ! |
逻辑非。操作数为 0,则结果为 1;操作数为 1,则结果为 0 |
XOR |
逻辑异或。操作数一个为真、一个为假,则结果为 1;若全部为真或全部为假,则结果为 0 |
补充说明:
- 仅有逻辑非(
NOT或!)是一元运算符,其余均为二元运算符。 NOT和!虽然功能相同,但在一个表达式中同时出现时,先运算!,再运算NOT。
逻辑与
- 在使用
&&连接多个相等比较的条件时,可以使用(a, b) = (x, y)的方式简化(a = x && b = y)的书写。 - 逻辑与(
AND或&&)操作中,若一个操作数为NULL,另一个操作数为1(真),则结果为NULL;若另一个操作数为0(假),则结果为0;若两个都是NULL,则结果为NULL。
逻辑或
逻辑或操作中,若一个操作数为 NULL,另一个操作数为 1(真),则结果为 1;若另一个操作数为 0(假),则结果为 0(假);若两个都是 NULL,则结果为 NULL。
逻辑非
- 当操作数为
0(假)时,结果为1(真)。 - 当操作数为
1(真)时,结果为0(假)。 - 当操作数为
NULL时,结果为NULL。
逻辑异或
逻辑异或(XOR)用于比较两个操作数:
- 两个操作数同时为
1(真)或同时为0(假)时,结果为0(假)。 - 两个操作数一个为
1、另一个为0时,结果为1(真)。 - 若操作数中含有
NULL,则结果为NULL。
赋值运算符
在 MySQL 中,= 是一个比较特殊的运算符,既可以用于比较数据是否相等,又可以用于赋值。为了避免系统无法区分 = 到底表示比较还是赋值,MySQL 特意增加了 := 符号用于表示赋值运算。
使用建议:
- 在
INSERT...SET和UPDATE...SET语句中出现的=都会被认定为赋值运算符。 - 除此之外的其他场景(如为用户变量赋值),若需要赋值操作,推荐使用
:=来明确表达意图,避免歧义。
示例:
-- 赋值(使用 :=)
SET @var := 10;

-- 比较(使用 =)
SELECT * FROM goods WHERE price = 100;

-- 在 UPDATE 中 = 表示赋值
UPDATE goods SET price = 50 WHERE id = 1;位运算符
位运算符是针对二进制数的每一位进行运算的符号,运算结果类型为 BIGINT,最大范围可达 64 位。
| 运算符 | 描述 | 示例 |
|---|---|---|
& |
按位与 | SELECT b'1001' & b'1011'; 结果为 9 |
| |
按位或 | SELECT b'1001' | b'1011'; 结果为 11 |
^ |
按位异或 | SELECT b'1001' ^ b'1011'; 结果为 2 |
<< |
按位左移 | SELECT b'1001' << 2; 结果为 36 |
>> |
按位右移 | SELECT b'1001' >> 2; 结果为 2 |
~ |
按位取反 | SELECT ~b'1001' & b'1011'; 结果为 2 |
版本差异说明:
- MySQL 5.7 中,位运算的操作数只能是
BIGINT类型(64 位整数)。 - MySQL 8.0 中,允许使用二进制字符串类型(如
BINARY、VARBINARY、BLOB)作为位运算的操作数。 - 因此,在 MySQL 5.7 中对二进制类型字段进行位运算的 SQL 语句,在 MySQL 8.0 中可能产生不同的结果,系统会给出相应的警告信息。
示例(MySQL 8.0 中 VARBINARY 类型参与位运算):
SELECT VARBINARY '1001' & VARBINARY '1011';相关函数:
| 函数 | 描述 | 示例 |
|---|---|---|
BIT_COUNT(N) |
返回在参数 N 中设置的比特位(二进制位为 1)的数量 |
SELECT BIT_COUNT(b'1011'); 结果为 3 |
BIT_AND() |
按位返回与的结果(聚合函数,通常用于 GROUP BY) | SELECT BIT_AND(b1) FROM table; 结果为 0 |
BIT_OR() |
按位返回或的结果(聚合函数,通常用于 GROUP BY) | SELECT BIT_OR(b1) FROM btable; 结果为 7 |
BIT_XOR() |
按位返回异或的结果(聚合函数,通常用于 GROUP BY) | SELECT BIT_XOR(b1) FROM btable; 结果为 5 |
补充说明:
BIT_COUNT()为标量函数,返回单个数值中二进制位为 1 的个数。BIT_AND()、BIT_OR()、BIT_XOR()均为聚合函数,常用于GROUP BY分组统计,对每组内的所有值进行按位运算后返回一个结果。- 示例中
b1为表中的二进制类型或整型字段。
运算符优先级
| 运算符优先级(从高到低) | 运算符 |
|---|---|
| 最高 | INTERVAL |
| ↓ | BINARY、COLLATE |
| ↓ | ! |
| ↓ | -(一元负号)、~(一元按位取反) |
| ↓ | ^ |
| ↓ | *、/、DIV、%、MOD |
| ↓ | -(减法)、+ |
| ↓ | <<、>> |
| ↓ | & |
| ↓ | | |
| ↓ | =(比较)、<=>、>=、>、<、<=、<>、!=、IS、LIKE、REGEXP、IN |
| ↓ | BETWEEN、CASE、WHEN、THEN、ELSE |
| ↓ | NOT |
| ↓ | AND、&& |
| ↓ | XOR |
| ↓ | OR、|| |
| 最低 | =(赋值)、:= |
说明:
- 同一行中的运算符具有相同的优先级。
- 除赋值运算符(
=、:=)为从右到左运算外,其余同级别运算符在同一个表达式中出现时,按从左到右的顺序依次运算。 - 可以使用括号调整优先级,如
(2 + 3) * 5。
多表操作
多表查询
联合查询
联合查询是多表查询的一种方式,在保证多个 SELECT 语句的查询字段数相同的情况下,合并多个查询的结果。
SELECT ...
UNION [ALL | DISTINCT] SELECT ...
[UNION [ALL | DISTINCT] SELECT ...];UNION是实现联合查询的关键字。ALL和DISTINCT是联合查询的选项:ALL:保留所有查询结果(包括重复记录)。DISTINCT:默认值,可省略,表示去除完全重复的记录,只保留一条。
在联合查询中,多个 SELECT 语句的查询字段个数必须相同,且最终结果集中只保留 第一个 SELECT 语句对应的字段名称。即使后续 SELECT 查询的字段与第一个 SELECT 的字段含义或数据类型不同,MySQL 也会根据查询字段出现的顺序对结果进行合并。也就是说,结果集的列名由第一个 SELECT 决定,后续查询的列名被忽略。
若要对联合查询的结果进行排序等操作,需要使用圆括号 () 将每个 SELECT 语句包裹起来,并在 SELECT 语句内部或联合查询的最后添加 ORDER BY 子句。同时,若要排序生效,必须在 ORDER BY 后添加 LIMIT 限定(通常推荐使用大于表记录数的任意值,以确保所有排序后的记录都被包含)。
(SELECT id, name, price FROM sh_goods WHERE category_id <> 3
 ORDER BY price DESC LIMIT 7)
UNION
(SELECT id, name, price FROM sh_goods WHERE category_id = 3
ORDER BY price ASC LIMIT 3);示例:分别查看学校为山东大学或者性别为男性的用户的 device_id、gender、age 和 gpa 数据,结果不去重。
只要满足一个条件就被筛选出来;若一个人满足两个条件只筛选一次,这就是 OR 与 UNION 的细节差异——OR 自带去重,UNION 可以等价于 OR,而 UNION ALL 可以不去重。
示例:user_profile
| id | device_id | gender | age | university | gpa | active_days_within_30 | question_cnt | answer_cnt |
|---|---|---|---|---|---|---|---|---|
| 1 | 2138 | male | 21 | 北京大学 | 3.4 | 7 | 2 | 12 |
| 2 | 3214 | male | 复旦大学 | 4 | 15 | 5 | 25 | |
| 3 | 6543 | female | 20 | 北京大学 | 3.2 | 12 | 3 | 30 |
| 4 | 2315 | female | 23 | 浙江大学 | 3.6 | 5 | 1 | 2 |
| 5 | 5432 | male | 25 | 山东大学 | 3.8 | 20 | 15 | 70 |
| 6 | 2131 | male | 28 | 山东大学 | 3.3 | 15 | 7 | 13 |
| 7 | 4321 | male | 28 | 复旦大学 | 3.6 | 9 | 6 | 52 |
SELECT
    device_id, gender, age, gpa
FROM user_profile
WHERE university = '山东大学'
UNION ALL
SELECT
    device_id, gender, age, gpa
FROM user_profile
WHERE gender = 'male';| device_id | gender | age | gpa |
|---|---|---|---|
| 5432 | male | 25 | 3.8 |
| 2131 | male | 28 | 3.3 |
| 2138 | male | 21 | 3.4 |
| 3214 | male | None | 4 |
| 5432 | male | 25 | 3.8 |
| 2131 | male | 28 | 3.3 |
| 4321 | male | 28 | 3.6 |
使用 OR 的结果(去重后):
SELECT
    device_id, gender, age, gpa
FROM user_profile
WHERE (university = '山东大学') OR (gender = 'male');| device_id | gender | age | gpa |
|---|---|---|---|
| 3234 | male | 21 | 3.7 |
| 3235 | male | None | 3.3 |
| 3238 | male | 25 | 3.5 |
| 3239 | male | 25 | 3.8 |
| 3240 | male | None | 4.0 |
连接查询
MySQL 中常用的连接查询有:交叉连接、内连接、左外连接、右外连接。
交叉连接
交叉连接返回的结果是被连接的两个表中所有数据行的笛卡尔积。
SELECT 查询字段 FROM 表1 CROSS JOIN 表2;内连接
根据匹配条件返回第一个表和第二个表所有匹配成功的记录。
SELECT 查询字段 FROM 表1
[INNER] JOIN 表2 ON 匹配条件;
在 INNER JOIN 语法中,ON 用于指定内连接的查询条件。若不设置 ON,则与交叉连接(CROSS JOIN)等价。
虽然也可以使用 WHERE 来完成条件的限定,效果与 ON 相同,但二者在执行效率上存在差异:
WHERE是在表连接操作完成之后,对已生成的全部连接结果进行过滤,当数据量较大时,会先产生大量中间结果,浪费性能。ON是在连接过程中直接根据条件进行匹配,只保留符合条件的数据,减少了不必要的数据组合,效率更高。
因此,在实际开发中,推荐使用 ON 来实现内连接的条件匹配,而非 WHERE。
内连接可以作用于多个表:先生成前两个表的结果,再与第三个表作用。
SELECT 查询字段 FROM 表1
[INNER] JOIN 表2 ON 匹配条件1
[INNER] JOIN 表3 ON 匹配条件2
...;自连接查询是内连接中的一种特殊形式:相互连接的表在物理上是同一个表,但在逻辑上将其视为两个独立的表来使用。
例:查询 “李经理” 领导的所有下属员工。
CREATE TABLE employees (
    id INT PRIMARY KEY,
    name VARCHAR(50),
    manager_id INT  -- 指向本表 id,表示上级领导
);

INSERT INTO employees (id, name, manager_id) VALUES
(1, '张总', NULL),   -- 最高领导
(2, '李经理', 1),    -- 张总的下属
(3, '王组长', 2),    -- 李经理的下属
(4, '赵组长', 2),    -- 李经理的下属
(5, '小刘', 3);      -- 王组长的下属

-- 自连接查询
SELECT e2.id, e2.name, e2.manager_id
FROM employees e1
JOIN employees e2 ON e1.id = e2.manager_id
WHERE e1.name = '李经理';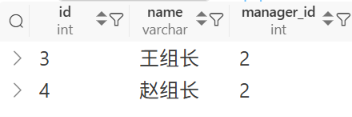
- 在
FROM子句中,当你写出表名 别名时,这个别名就被立即创建并绑定给了这张表,供当前整条 SQL 语句使用。
在连接查询时,若数据表连接的字段同名,则连接时的匹配条件可以使用 USING 代替 ON:
SELECT 查询字段
FROM 表1 [CROSS|INNER|LEFT|RIGHT] JOIN 表2
USING (同名的连接字段列表);
多个同名连接字段之间可以使用逗号分隔。
ON:可以连接任意两个列,列名不必相同(如a.id = b.manager_id)。USING (列名):要求连接的两个表中都必须存在这个列名,且自动进行左表.列名 = 右表.列名的等值匹配。它不能像ON那样把不同的列名关联起来。
只有在两个表有完全同名的关联列时(实际开发中不常使用),USING 才作为简化写法出现。
例如,假设有 employee_info 表(存员工姓名)和 employee_salary 表(存员工薪资),两表都有 employee_id 字段:
-- 用 ON 的写法
SELECT * FROM employee_info i JOIN employee_salary s ON i.employee_id = s.employee_id;

-- 用 USING 的等价写法(更简洁)
SELECT * FROM employee_info i JOIN employee_salary s USING (employee_id);
左外连接
内连接只能获取符合连接条件的记录,而外连接不仅可以获取符合连接条件的记录,还可以保留主表与从表不能匹配的记录。
左外连接也称左连接,用于返回连接关键字(LEFT JOIN)左表(主表)中所有的记录,以及右表(从表)中符合连接条件的记录。当左表的某行记录在右表中没有匹配的记录时,右表中相关的字段将被填充为 NULL。
SELECT 查询字段
FROM 表1 LEFT [OUTER] JOIN 表2 ON 匹配条件;
右外连接
右外连接也称右连接,用于返回连接关键字(RIGHT JOIN)右表(主表)中所有的记录,以及左表(从表)中符合连接条件的记录。当右表的某行记录在左表中没有匹配的记录时,左表中相关的字段将被填充为 NULL。
SELECT 查询字段
FROM 表1 RIGHT [OUTER] JOIN 表2 ON 匹配条件;
等价于:
SELECT 查询字段
FROM 表2 LEFT [OUTER] JOIN 表1 ON 匹配条件;
综合示例
创建示例表:
-- 产品分类表
CREATE TABLE categories (
    cat_id   INT PRIMARY KEY,
    cat_name VARCHAR(50) NOT NULL
);

-- 产品表(cat_id 允许为 NULL,表示该产品未归类)
CREATE TABLE products (
    prod_id   INT PRIMARY KEY,
    prod_name VARCHAR(50) NOT NULL,
    cat_id    INT,
    FOREIGN KEY (cat_id) REFERENCES categories(cat_id)
);

-- 插入分类(3 个)
INSERT INTO categories (cat_id, cat_name) VALUES
(1, '电子产品'),
(2, '家居用品'),
(3, '食品饮料');

-- 插入产品(5 个,其中 2 个未分类)
INSERT INTO products (prod_id, prod_name, cat_id) VALUES
(101, '智能手机', 1),
(102, '笔记本电脑', 1),
(103, '沙发', 2),
(104, '矿泉水', NULL),   -- 未分类
(105, '饼干', NULL); -- 未分类交叉连接(就是笛卡尔积):
结果显示中
prod_name和cat_name的左右顺序由SELECT后的字段顺序决定。当两个表中有相同的字段名时,SELECT时会造成混乱,因此常用表1.字段、表2.字段的写法;本例两个表没有相同字段名,可以不这样操作。
SELECT p.prod_name, c.cat_name
FROM products p
CROSS JOIN categories c;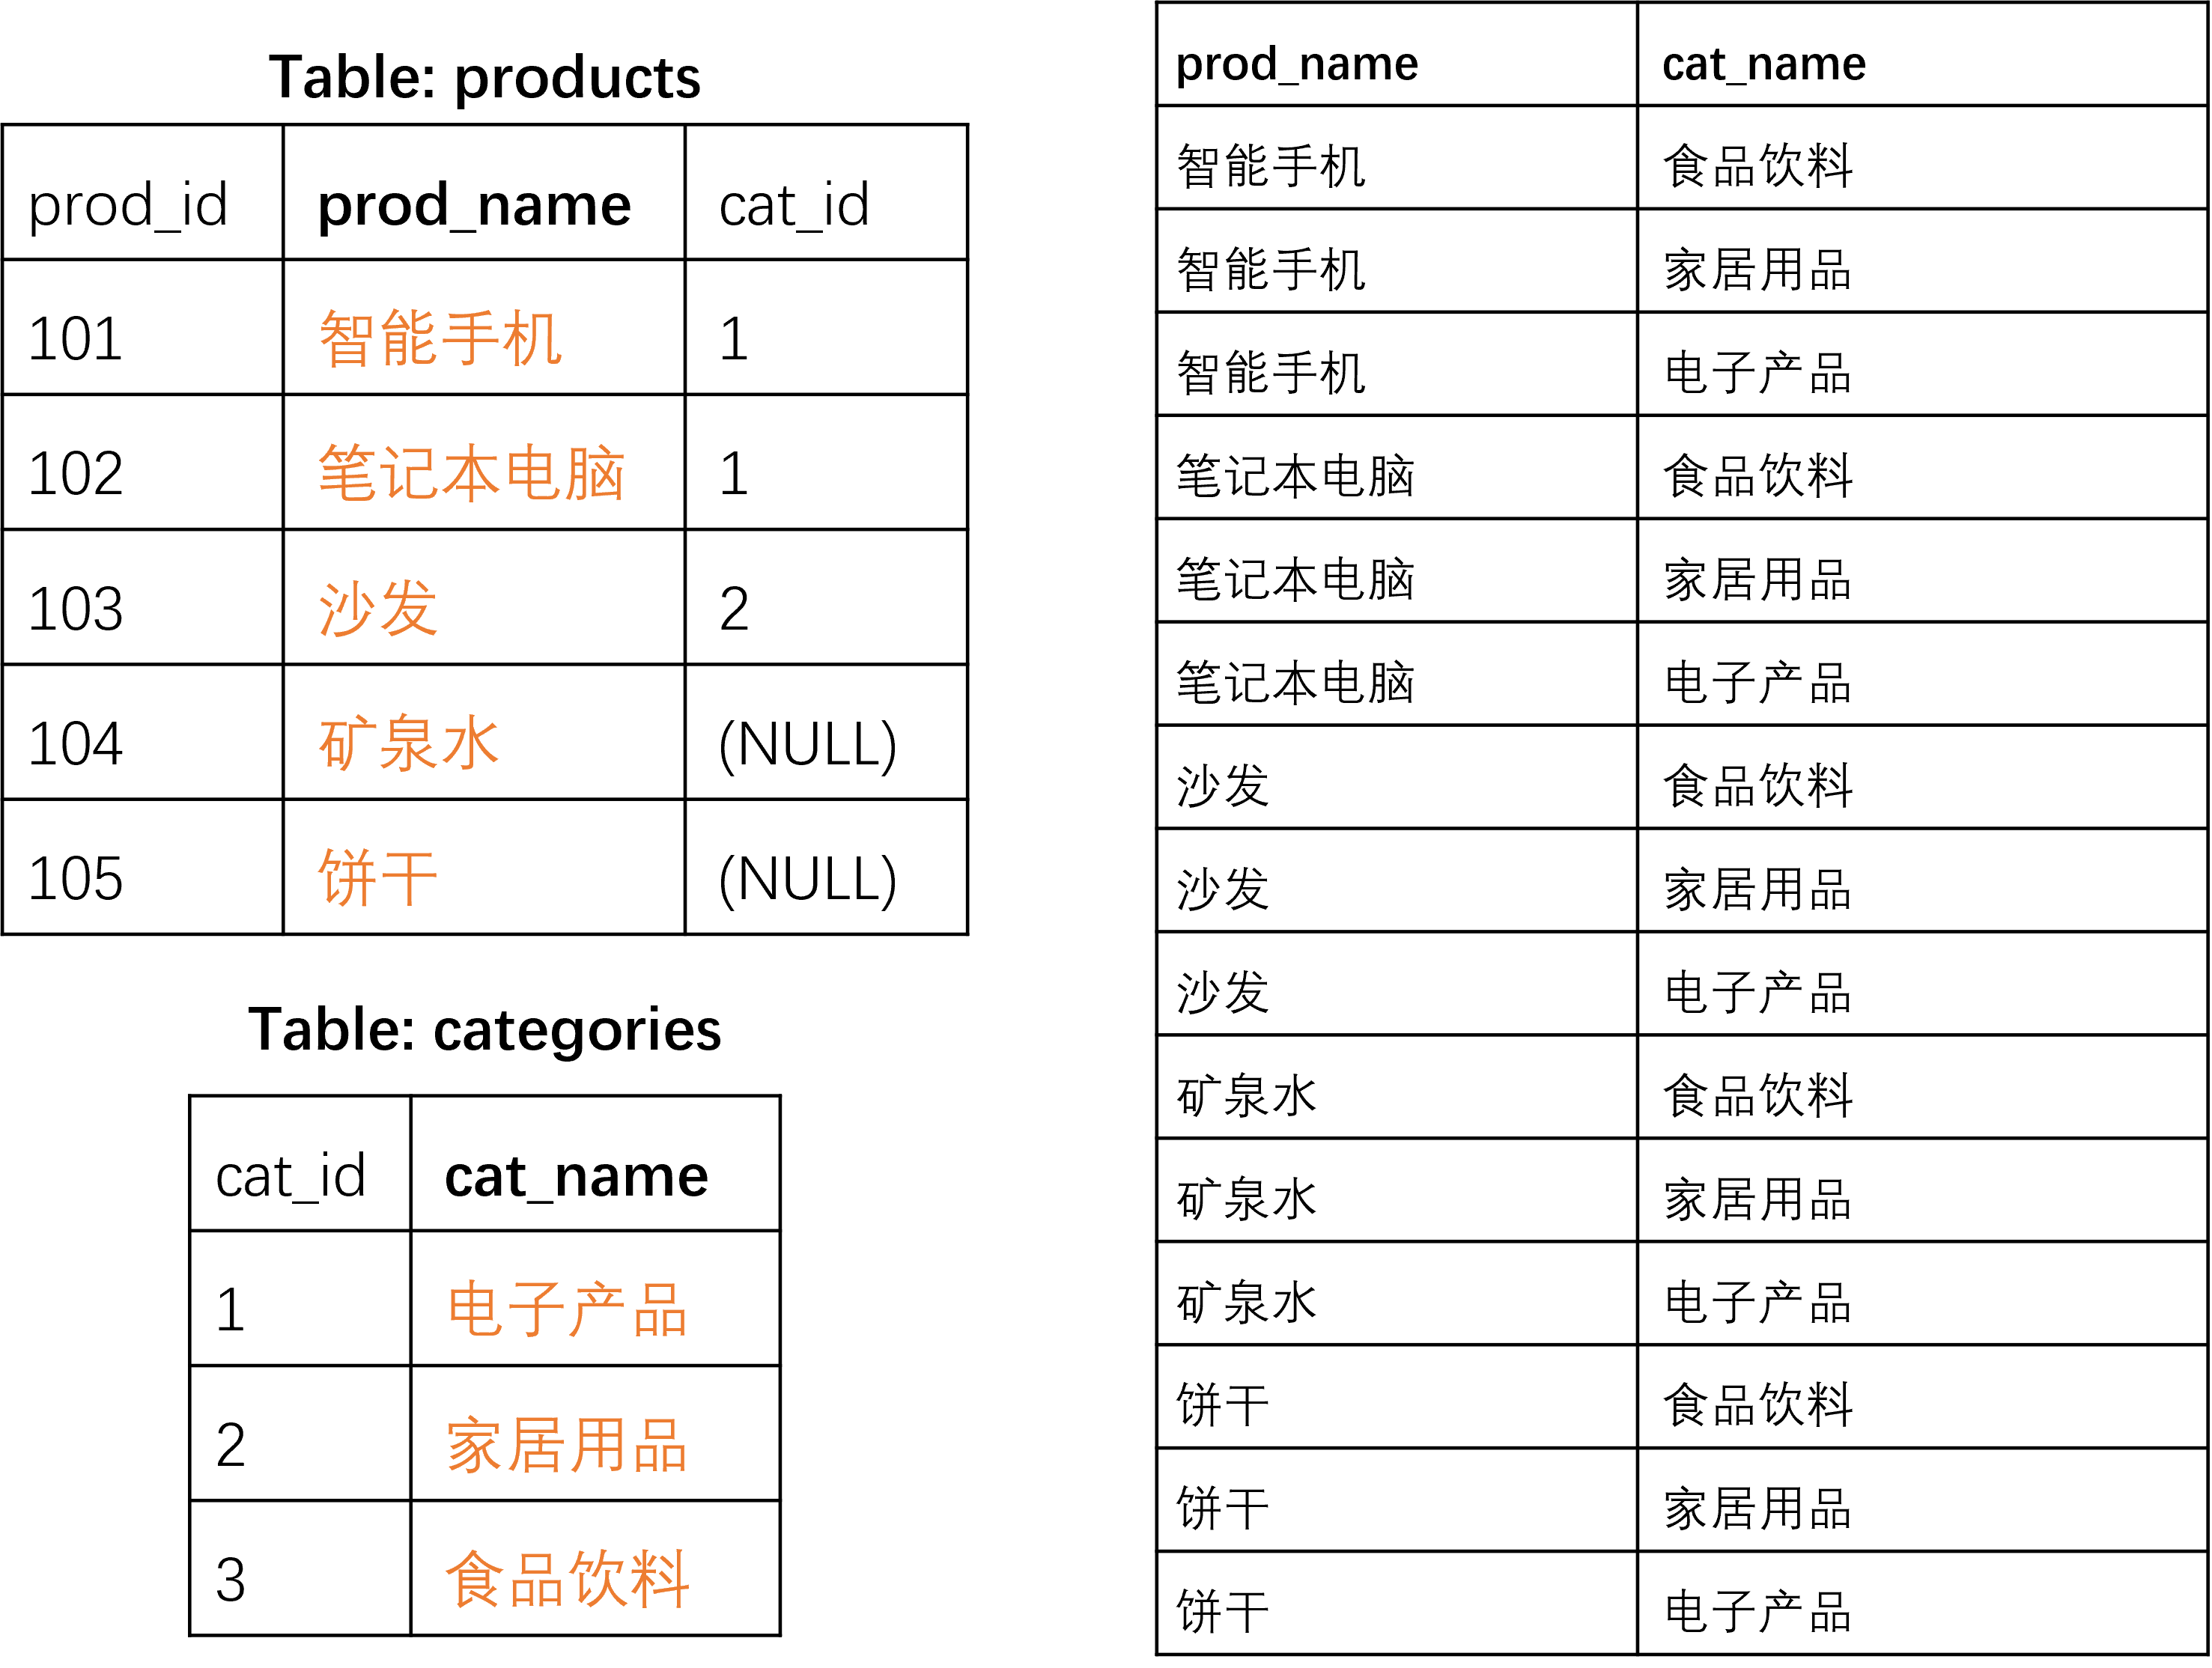
内连接:
SELECT p.prod_name, c.cat_name
FROM products p
INNER JOIN categories c ON p.cat_id = c.cat_id;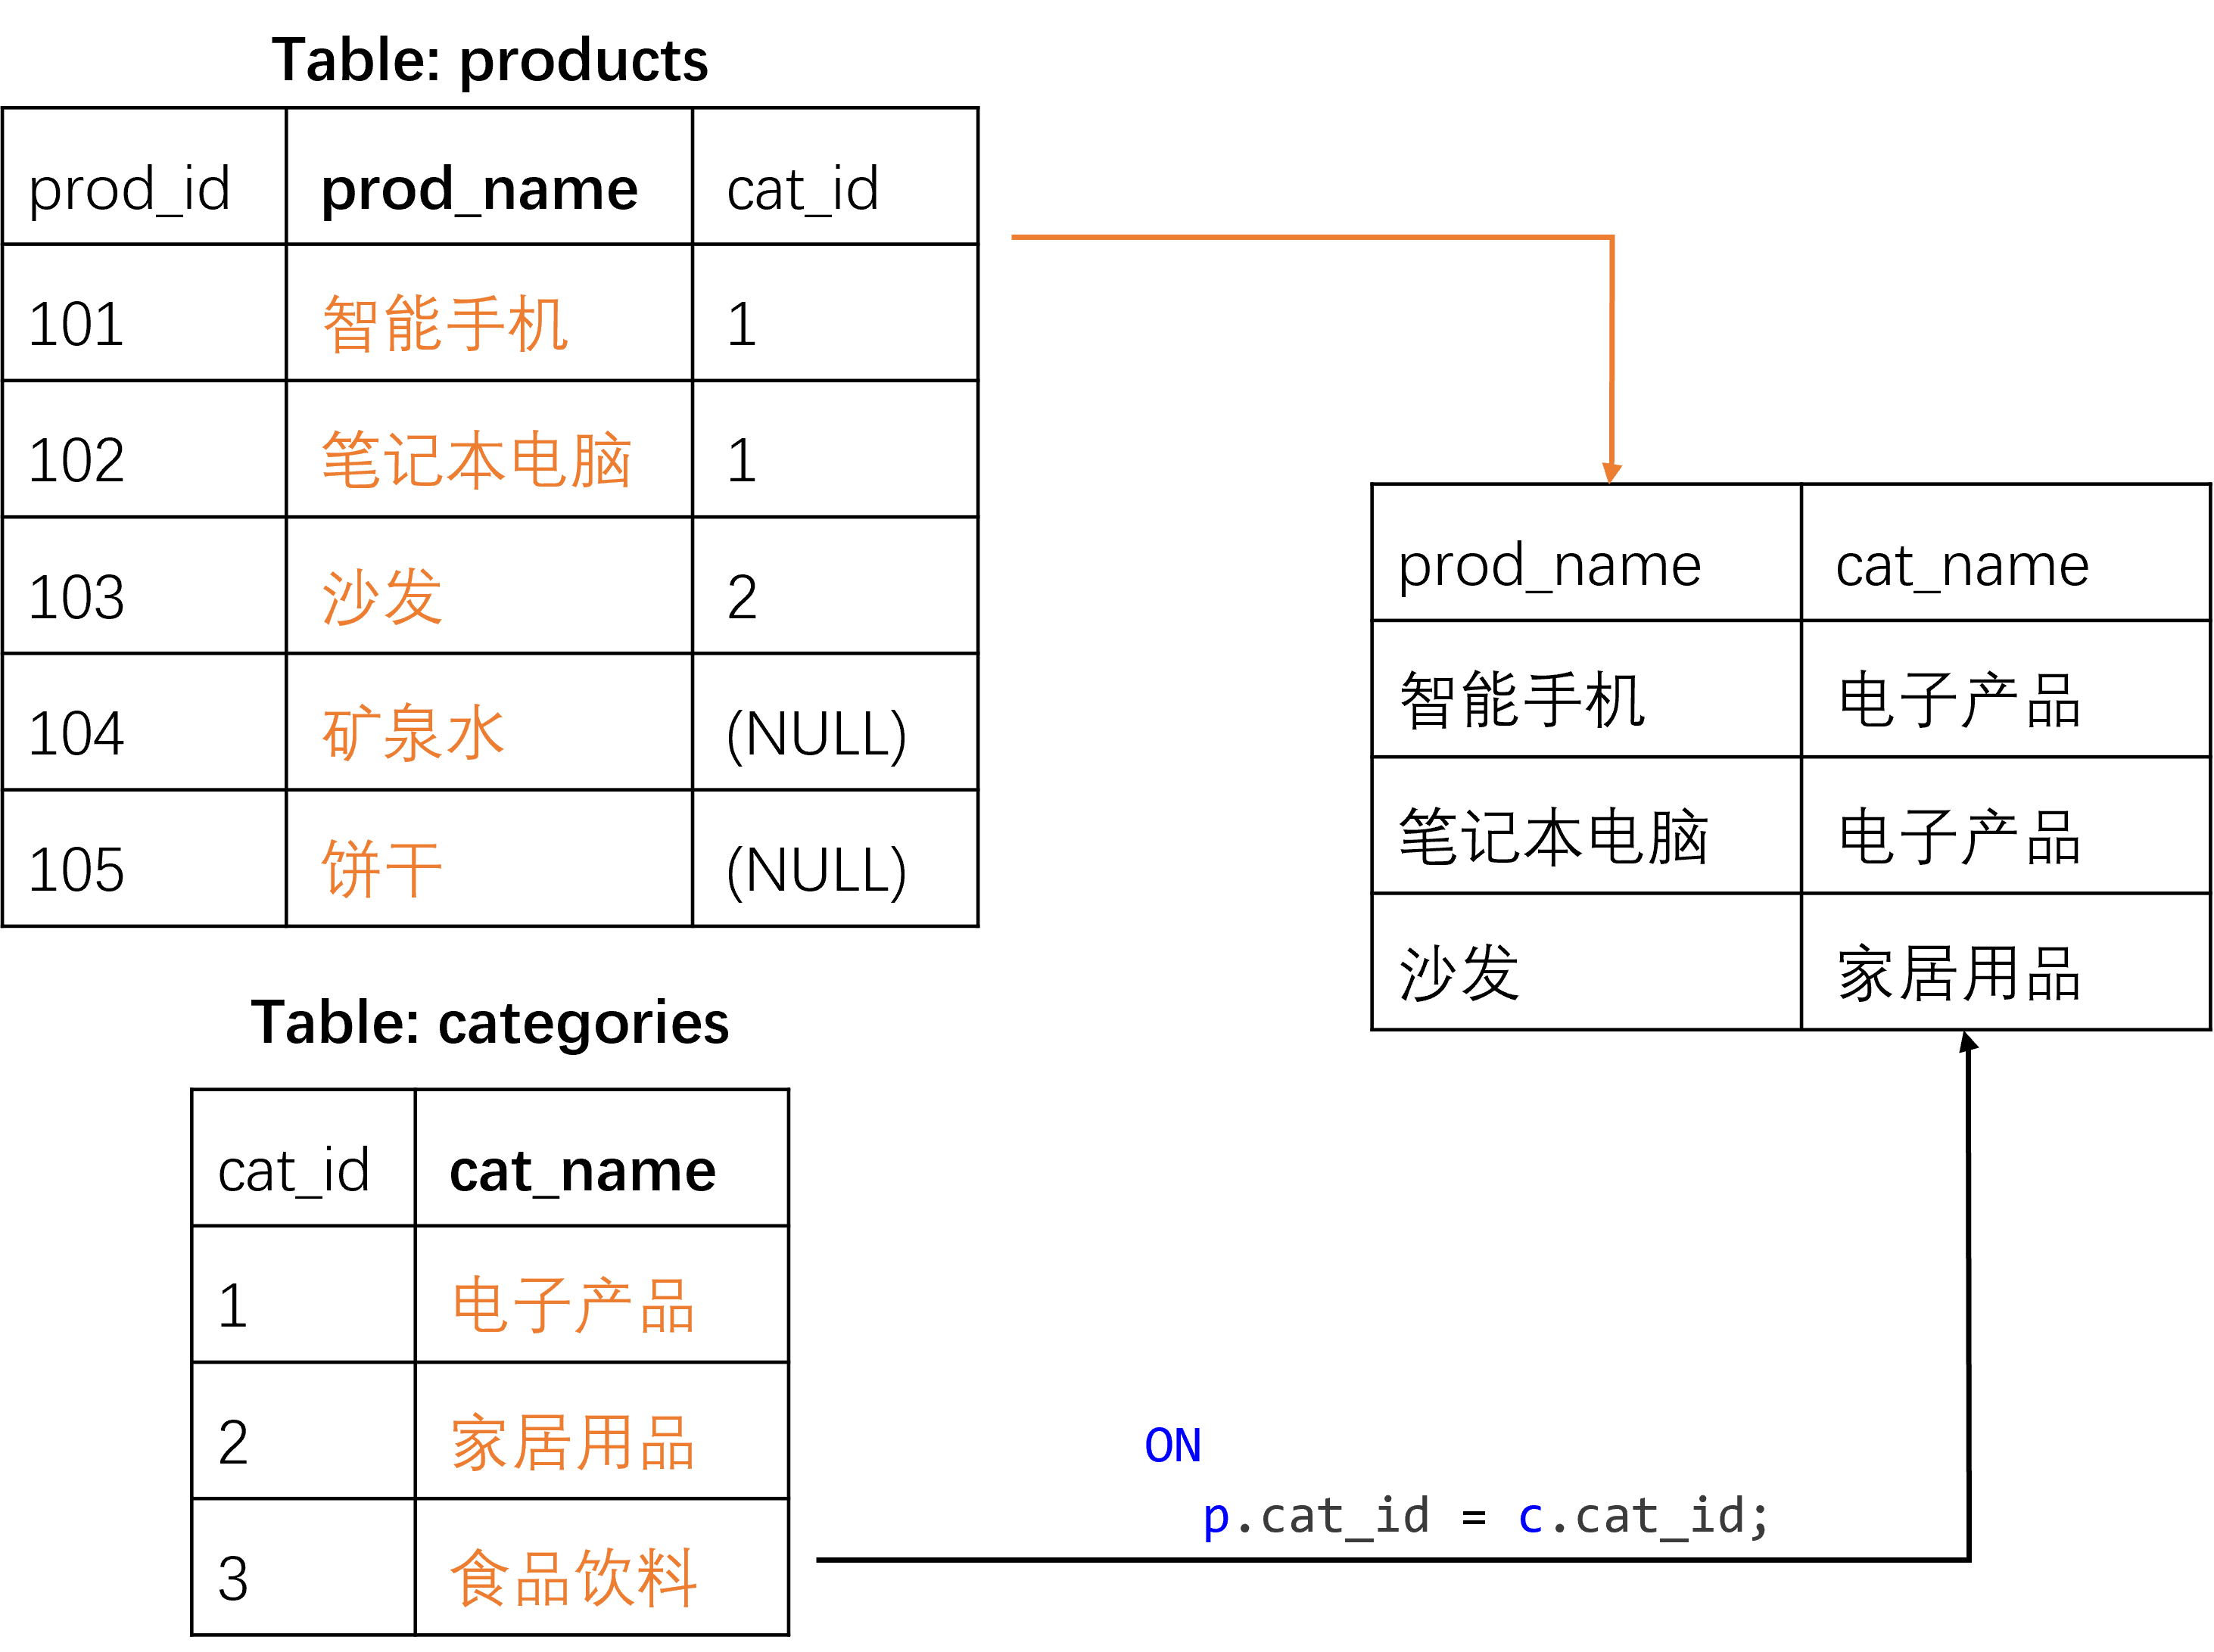
INNER JOIN 取的是两个表的交集,A ∩ B 和 B ∩ A 完全相等。上面的程序等价于:
SELECT p.prod_name, c.cat_name
FROM categories c
INNER JOIN products p ON p.cat_id = c.cat_id;
即使把表名写颠倒,MySQL 内部的优化器(Optimizer)在真正执行 SQL 之前,会根据表的数据量、索引情况重新计算最佳执行顺序。它会自动选择小表作为驱动表(先查),大表作为被驱动表(后查),以保证效率。
左外连接:
SELECT
    p.prod_name,
    c.cat_name
FROM products p
LEFT OUTER JOIN categories c
ON p.cat_id = c.cat_id;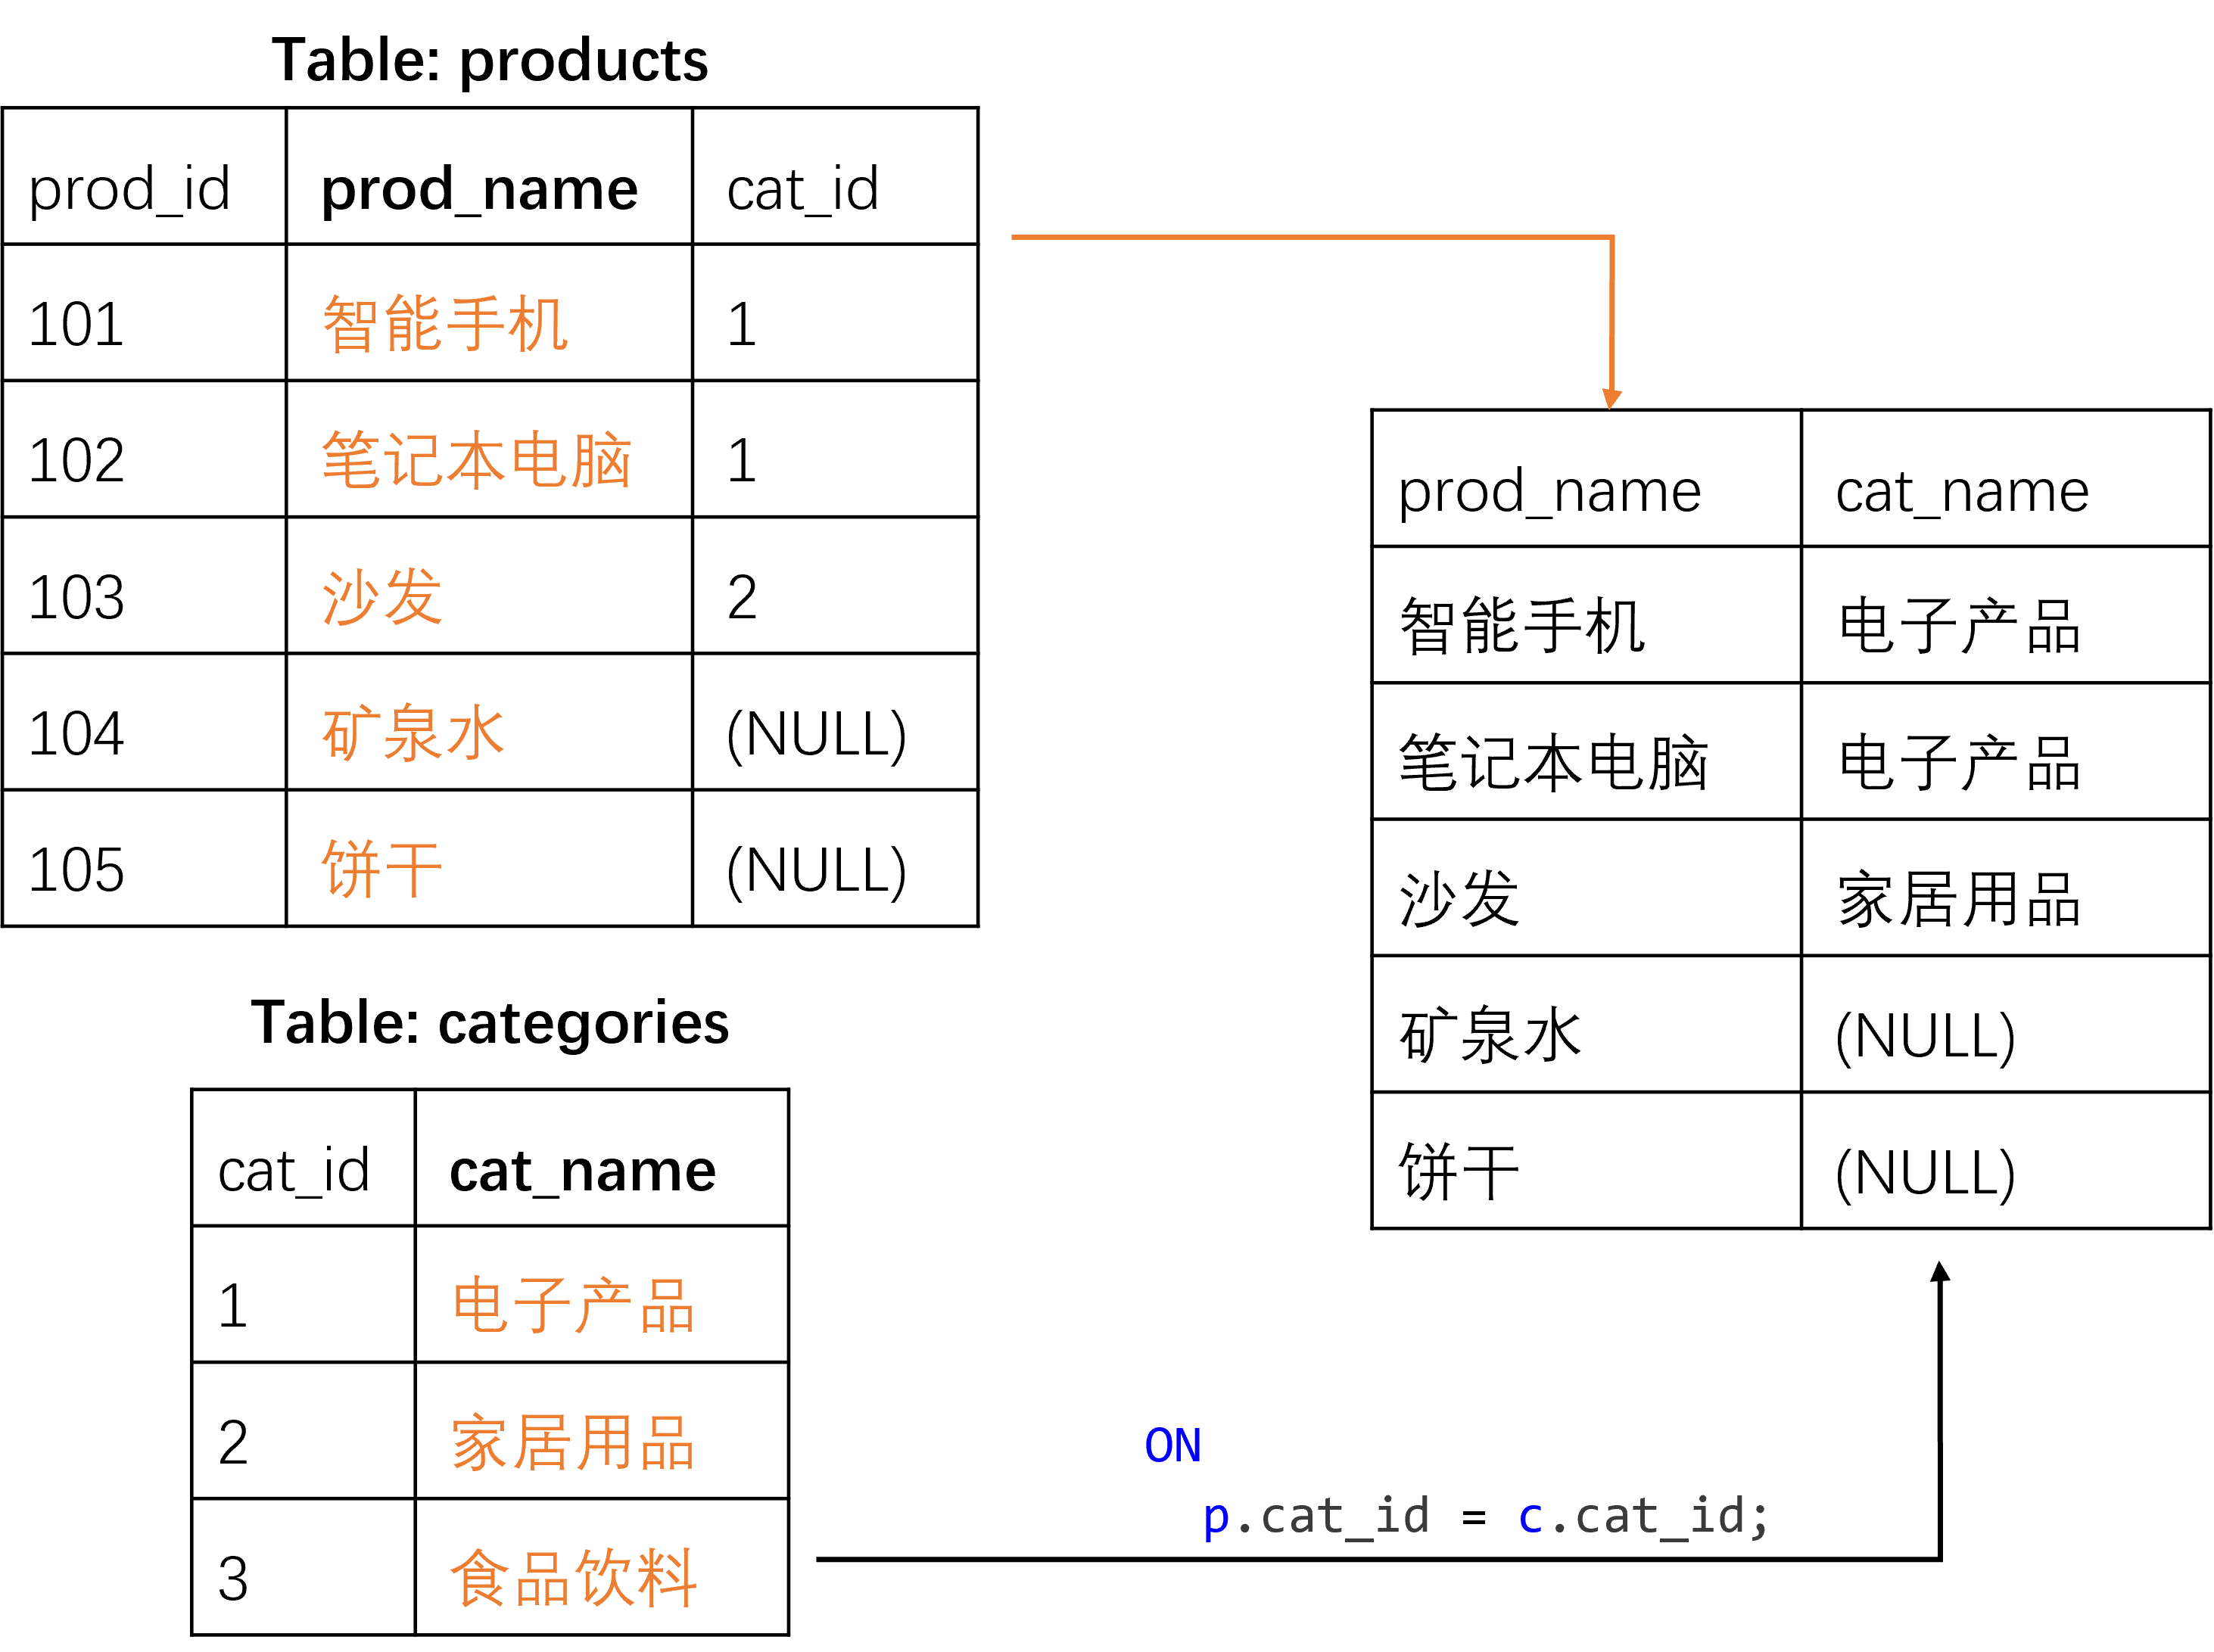
右外连接:
SELECT
    c.cat_name,
    p.prod_name
FROM products p
RIGHT OUTER JOIN categories c
ON p.cat_id = c.cat_id;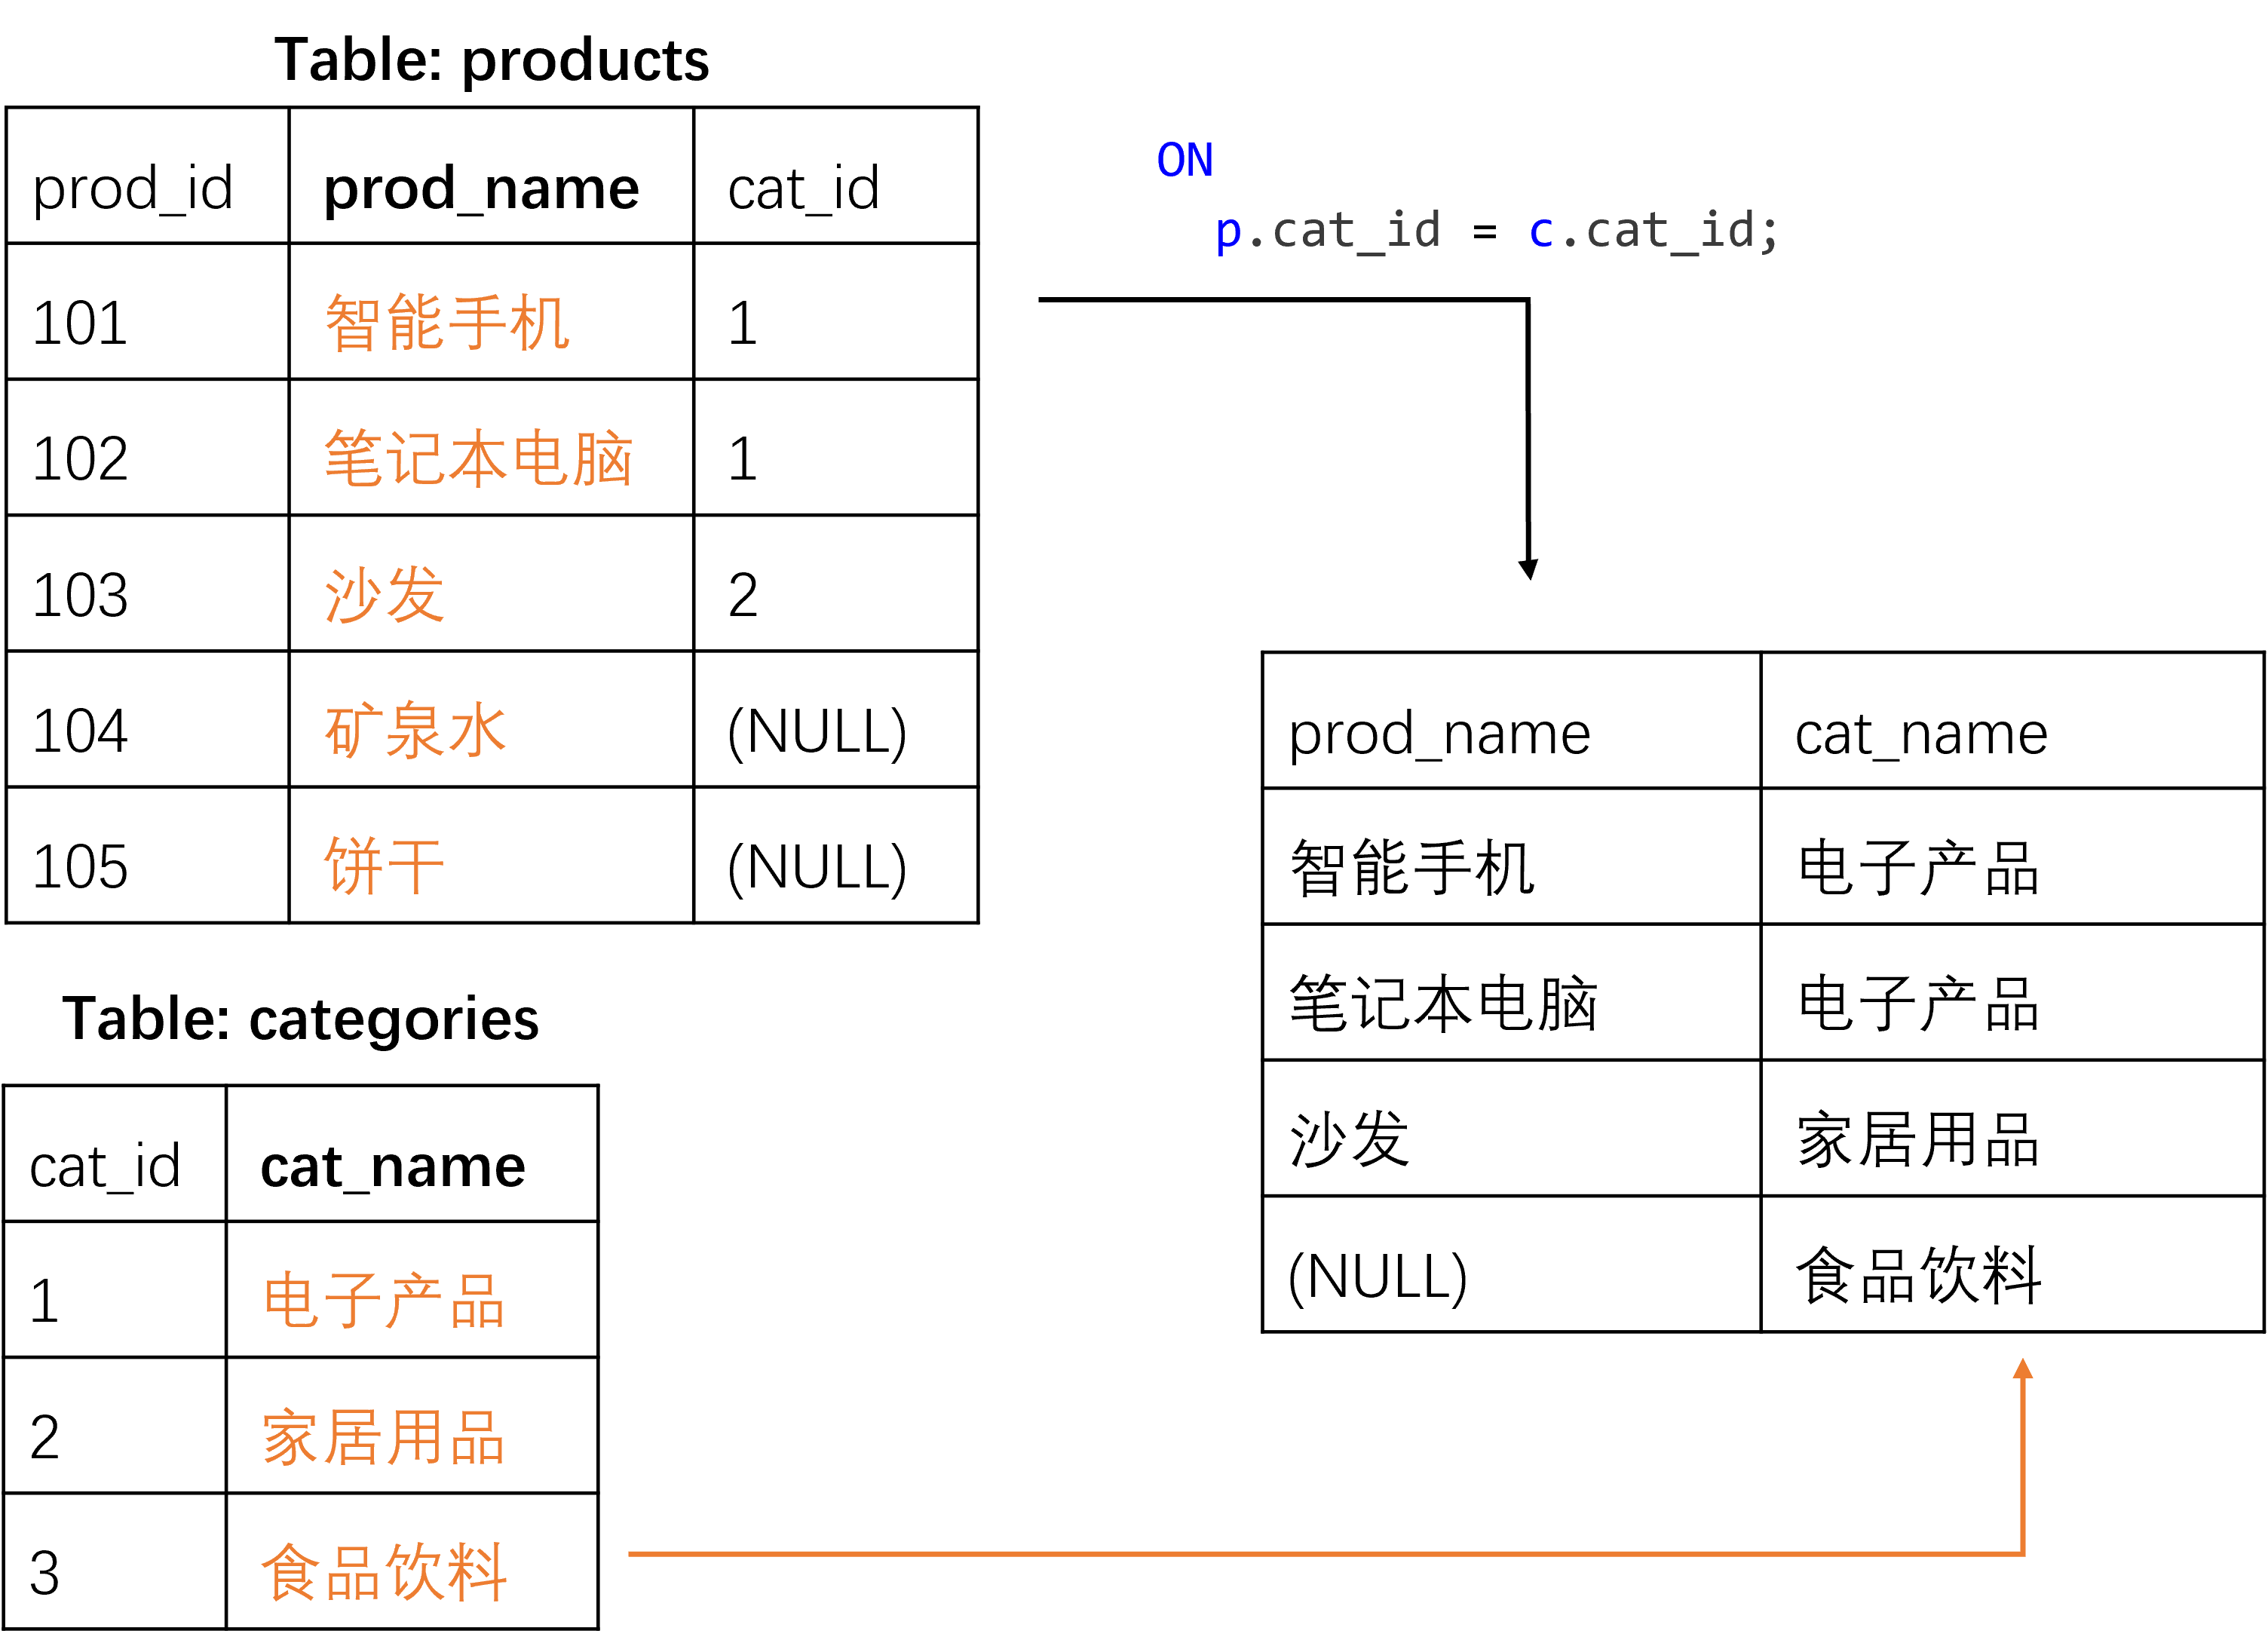
子查询
子查询是指在一个 SQL 语句(如 SELECT、INSERT、UPDATE 等)中嵌入另一个完整的查询语句,该查询作为外层语句的条件或数据源(例如替代 FROM 后的表)。被嵌入的查询称为子查询(Subquery),它是一条独立的 SELECT 语句,可单独执行。
子查询必须用圆括号 () 括起来。SQL 在执行时会先执行子查询,将其返回的结果作为外层 SQL 的过滤条件或数据来源。若语句中包含多层子查询,则执行顺序为从最内层开始,逐层向外。
子查询分类
- 按功能划分:
- 标量子查询:返回单个值(一行一列)
- 列子查询:返回一列多行
- 行子查询:返回一行多列
- 表子查询:返回多行多列(一张表)
- 按出现位置划分:
- WHERE 子查询:子查询出现在
WHERE条件子句中 - FROM 子查询:子查询出现在
FROM子句中,作为数据源(派生表)
- WHERE 子查询:子查询出现在
对应关系:标量子查询、列子查询、行子查询均属于 WHERE 子查询;表子查询属于 FROM 子查询。
标量子查询
标量子查询是指子查询返回的结果为单个值(即一行一列), 通常与比较运算符 = 或 <> 配合使用,用于判断子查询返回的值是否与指定条件相等或不等,并根据比较结果完成外层查询的需求。
WHERE 条件判断 {= | <>}
(SELECT 字段名 FROM 数据源 [WHERE] [GROUP BY] [HAVING] [ORDER BY] [LIMIT]);
列子查询
列子查询是指子查询返回的结果为一列多行(即单个字段的多条记录), 通常与 IN 或 NOT IN 运算符配合使用,用于判断指定条件是否匹配子查询返回的结果集中的任意一个值,并根据匹配结果完成外层查询的需求。
WHERE 条件判断 {IN | NOT IN}
(SELECT 字段名 FROM 数据源 [WHERE] [GROUP BY] [HAVING] [ORDER BY] [LIMIT]);
行子查询
行子查询是指子查询返回的结果为一条记录(即一行多列)。
WHERE (指定字段名1, 指定字段名2, ...) =
(SELECT 字段名1, 字段名2, ... FROM 数据源 [WHERE] [GROUP BY] [HAVING] [ORDER BY] [LIMIT]);
行子查询通常使用 = 运算符,表示子查询返回的多个字段必须同时与指定的字段匹配,WHERE 条件才成立。此外,也可以使用 <>、>、< 等其他比较运算符,其含义如下表所示。
| 行比较写法 | 等价逻辑表达式 |
|---|---|
(a, b) = (x, y) |
a = x AND b = y |
(a, b) <=> (x, y) |
a <=> x AND b <=> y |
(a, b) <> (x, y) 或 (a, b) != (x, y) |
a <> x OR b <> y |
(a, b) > (x, y) |
a > x OR (a = x AND b > y) |
(a, b) >= (x, y) |
a >= x OR (a = x AND b >= y) |
(a, b) < (x, y) |
a < x OR (a = x AND b < y) |
(a, b) <= (x, y) |
a <= x OR (a = x AND b <= y) |
- 相等比较(
=或<=>)时,各条件之间是 与(AND) 的逻辑关系。 - 不等比较(
<>或!=)时,各条件之间是 或(OR) 的逻辑关系。 - 其他比较运算符(如
>、<等)的条件逻辑包含两种情况(先比较第一个字段,若相等再比较第二个字段)。
例:从 sh_goods 表中查询出价格等于表中最高价格,并且评分等于表中最低评分的所有商品记录(可能为 NULL)。
SELECT id, name, price, score, content FROM sh_goods
WHERE (price, score) = (SELECT MAX(price), MIN(score) FROM sh_goods);
表子查询
表子查询是指子查询的返回结果作为 FROM 子句中的数据源使用,该结果是一个符合二维表结构的数据集合。
SELECT 字段列表 FROM (SELECT 语句) [AS] 别名
[WHERE] [GROUP BY] [HAVING] [ORDER BY] [LIMIT];FROM后的子查询必须为其指定别名,以便外层查询将其视为一张表进行引用。- 设置别名后,可对该 “临时表” 进行条件判断、分组、排序、限量等操作。
例:查询 sh_goods 表中每个分类下价格最高的商品信息。
SELECT a.id, a.name, a.price, a.category_id
FROM sh_goods a,
     (SELECT category_id, MAX(price) max_price
      FROM sh_goods
      GROUP BY category_id) b
WHERE a.category_id = b.category_id
AND a.price = b.max_price;子查询 b 返回每个分类的 category_id 及其最高价格 max_price,外层查询通过连接条件筛选出每个分类中价格等于最高价的商品记录。
语句运行顺序
MySQL(以及所有标准 SQL)在执行时,会按照以下顺序处理语句:
1. FROM → 2. JOIN / ON → 3. WHERE → 4. GROUP BY → 5. 聚合函数(COUNT/SUM/AVG) → 6. HAVING → 7. SELECT(含窗口) → 8. DISTINCT → 9. ORDER BY → 10. LIMIT
SELECT
    a.university,                               -- 7. 最后才取出来
    c.difficult_level,
    ROUND(COUNT(b.question_id) / COUNT(DISTINCT b.device_id), 4) AS avg_answer_cnt
FROM
    user_profile a                              -- 1. 最先加载主表
    JOIN question_practice_detail b ON a.device_id = b.device_id  -- 2. 连表,生成虚拟临时表
    JOIN question_detail c ON b.question_id = c.question_id
WHERE
    a.university = '山东大学'                   -- 3. 逐行过滤(先筛学校,减少数据量)
GROUP BY
    a.university, c.difficult_level             -- 4. 按照学校和难度分组(形成若干小组)
-- 5. 在这里执行 COUNT(b.question_id) 和 COUNT(DISTINCT b.device_id) 进行计算
HAVING
    COUNT(b.question_id) > 10                   -- 6. (假如有这句)过滤掉计算后不符合条件的小组
-- 7. SELECT 此时才真正把字段取出来,并将结果命名为 avg_answer_cnt(别名诞生)
ORDER BY
    c.difficult_level                           -- 9. 对最终结果进行排序
LIMIT 10; -- 10. 最后只取前 10 行avg_answer_cnt 是在 SELECT 阶段生成的,因此不能再在 JOIN、WHERE、GROUP BY、HAVING 中使用,除非嵌套一层子查询。
子查询关键字
在 WHERE 子查询中,不仅可以使用比较运算符,还可以使用 MySQL 提供的一些特定关键字,如 IN。此外,常用的子查询关键字还有 EXISTS、ANY 和 ALL。
- 带
ANY、SOME或ALL关键字的子查询中,不能使用<=>比较运算符。 - 若子查询结果中存在与条件匹配的
NULL值,则该条NULL记录不参与匹配(即NULL值不会影响比较结果)。
举例:子查询返回 (2, 5, NULL):
WHERE 6 > ALL (2, 5, NULL):6 > 2和6 > 5都为真,6 > NULL未知(不参与),结果视为TRUE。WHERE 4 > ALL (2, 5, NULL):虽然4 > 2为真,但4 > 5为假,因此结果为FALSE,NULL不影响这个判定。
EXISTS
EXISTS 关键字用于判断子查询是否有返回结果,若子查询返回了至少一行记录,则 EXISTS 的结果为 1(成立),否则为 0(不成立)。
WHERE EXISTS (子查询语句);ANY / SOME
使用带 ANY 关键字的子查询时,表示给定的判断条件只要符合子查询结果中的任意一个值,就返回 1(真),否则返回 0(假)。
WHERE 表达式 比较运算符 ANY (子查询语句);MySQL 中还有一个关键字 SOME,其功能与 ANY 完全相同。MySQL 同时保留 SOME 和 ANY 的原因主要与英语语法习惯相关:
ANY和SOME在肯定句中含义相近。- 但在否定句中(如
NOT ANY与NOT SOME),二者的逻辑含义差异较大:NOT ANY表示 “一点也不”,相当于NOT ALL。NOT SOME仅用于否定部分内容,语义上有所不同。
因此,为了便于以英语为母语的开发者更准确地理解语义,MySQL 同时提供了 SOME 和 ANY 两个关键字。
ALL
使用带 ALL 关键字的子查询时,表示给定的判断条件只有全部符合子查询结果中的每一个值时,才返回 1(真),否则返回 0(假)。
WHERE 表达式 比较运算符 ALL (子查询语句);公共表表达式 CTE
MySQL 中的 WITH 语句,也叫做公共表表达式(Common Table Expression,CTE),是自 MySQL 8.0 版本开始支持的一个强大功能。可视作在一个复杂查询中,为了简化而创建的临时命名结果集(可避免嵌套)。
WITH
    cte_name_1 [(column1, column2, ...)] AS (
        -- 子查询部分(定义这个 CTE 的内容)
        SELECT ...
    ),
    cte_name_2 [(column1, column2, ...)] AS (
        -- 第二个 CTE,可以引用上面的 cte_name_1
        SELECT ... FROM cte_name_1 ...
    )
-- 主查询(必须紧跟其后,且只能有一个主查询)
SELECT ... FROM cte_name_2 ...;WITH 子句必须放在最前面,且后面必须紧跟一条最终的 SELECT、UPDATE 或 DELETE 语句。
递归 CTE
WITH 语句最强大的功能之一是其递归能力,通过 WITH RECURSIVE 实现。这让 MySQL 能够优雅地处理具有层级或树形结构的数据,比如组织架构、商品分类、评论回复链等。
一个递归 CTE 必须包含两部分:
- 锚点成员(Anchor Member):递归的起点,一个普通的
SELECT查询,用于获取初始的数据集。 - 递归成员(Recursive Member):一个会引用 CTE 自身名称的
SELECT查询,通过UNION ALL与锚点成员连接,用于不断地迭代获取下一层数据。
假设有一个 departments 表,包含 id、name、parent_id 字段。要查询 “技术部” 及其所有子部门:
WITH RECURSIVE dept_tree AS (
    -- 1. 锚点成员:查询起点,即"技术部"
    SELECT id, name, parent_id, 1 AS level
    FROM departments
    WHERE name = '技术部'

    UNION ALL

    -- 2. 递归成员:查找子部门
    SELECT d.id, d.name, d.parent_id, dt.level + 1
    FROM departments d
    JOIN dept_tree dt ON d.parent_id = dt.id
)
SELECT * FROM dept_tree;- 锚点成员:首先找到 “技术部” 作为第一层数据。
- 递归成员:通过
JOIN dept_tree dt ON d.parent_id = dt.id,不断查找parent_id等于上一轮结果的id的记录,也就是查找下一级子部门。level + 1则记录了每个节点所在的层级深度。
递归深度限制:为防止无限递归,MySQL 默认的递归深度限制为 1000 层,可以通过修改 cte_max_recursion_depth 系统变量来调整这个值。在编写递归 CTE 时,务必确保有明确的终止条件,否则可能导致查询无法结束。
外键约束
在数据库设计时,为了保证不同表中相同含义数据的一致性和完整性,可为数据表添加外键约束。例如,员工表中添加了部门表中不存在的部门 ID,此时就会出现数据信息保存不对等的情况;若在员工表中将部门 ID 设置为外键,即可对相关的操作产生约束,例如员工表只能插入部门表中含有的记录 ID。
外键指的是在一个表中引用另一个表中的一列或多列,被引用的列应该具有主键约束或唯一性约束,从而保证数据的一致性和完整性。其中,被引用的表称为主表;引用外键的表称为从表。
外键约束在使用时既有一定的优势,同时也会带来一定的问题。
优势:
- 外键可节省开发量。
- 外键能约束数据有效性,防止非法数据的插入。
劣势:
- 使用外键约束,会带来额外的开销。
- 主表被锁定时,会引发从表也被锁定。
- 删除主表的数据时,需先删除从表的数据。
- 含有外键约束的从表字段不能修改表结构。
添加外键约束
在 CREATE TABLE(创建表)或 ALTER TABLE(修改表)语句中添加外键约束的基本语法格式如下:
[CONSTRAINT symbol] FOREIGN KEY [index_name] (index_col_name, ...)
REFERENCES tbl_name (index_col_name, ...)
[ON DELETE {RESTRICT | CASCADE | SET NULL | NO ACTION | SET DEFAULT}]
[ON UPDATE {RESTRICT | CASCADE | SET NULL | NO ACTION | SET DEFAULT}]
[CONSTRAINT symbol]:可选关键字,用于定义外键约束的名称。若省略,MySQL 会自动生成一个名称。[index_name]:可选参数,表示外键索引名称。若省略,MySQL 会自动创建一个外键索引,以加快查询速度。(index_col_name, ...):从表(子表)中的外键字段列表。REFERENCES tbl_name (index_col_name, ...):指定主表(父表)及其被引用的字段(必须具有主键约束或唯一性约束)。ON DELETE与ON UPDATE:用于设置主表中数据被删除或修改时,从表对应数据的处理方式。其后的参数取值说明如下:
| 参数名称 | 功能描述 |
|---|---|
RESTRICT |
默认值。拒绝主表删除或修改外键关联字段 |
CASCADE |
主表中删除或更新记录时,同时自动删除或更新从表中对应的记录 |
SET NULL |
主表中删除或更新记录时,使用 NULL 值替换从表中对应的记录(不适用于 NOT NULL 字段) |
NO ACTION |
与默认值 RESTRICT 相同,拒绝主表删除或修改外键关联字段 |
SET DEFAULT |
设默认值,但 InnoDB 存储引擎目前不支持 |
目前只有 InnoDB 存储引擎支持外键约束。此外,建立外键关系的两个数据表的相关字段数据类型必须相似,即要求字段的数据类型可以相互转换。例如,INT 和 TINYINT 类型的字段可以建立外键关系,而 INT 和 CHAR 类型的字段则不可以。
为 employees 表中的 dept_id 字段添加外键约束,与主表 department 中的主键 id 相关联,同时结合 ON DELETE 和 ON UPDATE 子句指定级联行为。
注意事项:定义外键约束名称(如 FK_ID)时,不能加单引号或双引号。例如,使用 CONSTRAINT 'FK_ID' 或 CONSTRAINT "FK_ID" 都会导致语法错误。
-- ① 在 mydb 数据库下创建主表(部门表)
CREATE TABLE mydb.department (
    id INT UNSIGNED PRIMARY KEY AUTO_INCREMENT COMMENT '部门编号',
    name VARCHAR(50) NOT NULL COMMENT '部门名称'
) DEFAULT CHARSET=utf8;

-- ② 在 mydb 数据库下创建从表(员工表),添加外键约束
CREATE TABLE mydb.employees (
    id INT UNSIGNED PRIMARY KEY AUTO_INCREMENT COMMENT '员工编号',
    name VARCHAR(120) NOT NULL COMMENT '员工姓名',
    dept_id INT UNSIGNED NOT NULL COMMENT '部门编号',
    CONSTRAINT FK_ID FOREIGN KEY (dept_id) REFERENCES department(id)
    ON DELETE RESTRICT ON UPDATE CASCADE
) DEFAULT CHARSET=utf8;

-- ③ 在 mydb 数据库下创建索引
CREATE INDEX ON employees (id);
CREATE INDEX ON department (id);
CREATE INDEX ON department (name);
CREATE INDEX ON employees (dept_id);对于已经创建的数据表,可以通过 ALTER TABLE 方式添加外键约束。例如,若 mydb 数据库中已存在 department 和 employees 两个表,且 employees 表在创建时未添加外键约束,此时可使用以下语句添加:
ALTER TABLE mydb.employees
ADD CONSTRAINT FK_ID FOREIGN KEY (dept_id) REFERENCES department (id)
ON DELETE RESTRICT ON UPDATE CASCADE;
查看外键约束
添加外键约束后,可以通过 DESC 命令查看从表 employees 中添加了外键约束的字段信息:
DESC mydb.employees dept_id;添加外键约束的 dept_id 字段的 Key 值为 MUL(表示非唯一性索引,即 MULTIPLE KEY),说明该字段的值可以重复。
也可以使用 SHOW CREATE TABLE 查看 employees 表的完整定义:
SHOW CREATE TABLE mydb.employees;在创建外键约束时,MySQL 会自动为没有索引的外键字段创建索引。
删除外键约束
ALTER TABLE 表名 DROP FOREIGN KEY 外键名;删除外键约束后,可以通过 DESC 查看从表中相关字段的信息。但此时相应字段的 Key 值依然为 MUL(非唯一索引),这是因为删除外键约束时不会自动删除系统为该外键创建的普通索引。此时可使用 SHOW CREATE TABLE 查看表的详细定义,确认索引仍然存在。
若需要在删除外键约束的同时删除系统自动创建的普通索引,需手动执行删除索引操作。
视图
前面操作的表都是真实存在的表,数据库中还存在一种虚拟的表,数据从真实的表中获取,称为视图。它的结构和数据都依赖于基本表,通过视图不仅可以看到存放在基本表中的数据,还可以像操作基本表一样,对数据进行查询、添加、修改和删除。
创建视图的基本语法:
CREATE [OR REPLACE] [ALGORITHM = {UNDEFINED | MERGE | TEMPTABLE}]
[SQL SECURITY {DEFINER | INVOKER}]
VIEW view_name [(column_list)]
AS select_statement
[WITH [CASCADED | LOCAL] CHECK OPTION];CREATE:创建新视图的关键字。OR REPLACE:可选。如果视图已存在,则替换其定义;若不存在,则等同于CREATE VIEW。使用此选项可避免因视图已存在而导致的错误。VIEW view_name:指定要创建或替换的视图名称。[(column_list)]:可选。为视图的列指定自定义名称,需与SELECT语句中的列数量一致。若不指定,则直接使用SELECT语句中的列名。
处理算法(ALGORITHM):该子句影响 MySQL 执行视图查询的方式。
UNDEFINED:默认值。由 MySQL 自动选择使用MERGE还是TEMPTABLE算法。MERGE:将视图的SELECT语句与外部查询合并,然后统一执行。这通常效率更高。TEMPTABLE:先执行视图的SELECT语句,将结果存入一个临时表,再在临时表上执行外部查询。使用此算法时,视图通常不可更新。
安全与权限(DEFINER、SQL SECURITY):这些子句决定了在调用视图时,以哪个用户的权限来检查访问权限。
DEFINER = user:可选。指定一个 MySQL 账户,用于定义视图的 “安全上下文”。SQL SECURITY { DEFINER | INVOKER }:DEFINER:默认值。使用DEFINER子句指定的用户(或创建者,如果未指定)的权限来执行视图。INVOKER:使用调用视图的当前用户的权限来执行。
数据一致性检查(WITH CHECK OPTION):该子句用于约束对视图的插入或更新操作,确保这些操作的结果行仍满足视图的定义(即 WHERE 条件)。
WITH CHECK OPTION:当视图基于另一个视图定义时,LOCAL和CASCADED用于定义检查的范围,默认值为CASCADED。LOCAL:仅检查当前视图自身的WHERE条件。CASCADED:不仅检查当前视图的WHERE条件,还会递归检查其依赖的所有基础视图,并强制应用WITH CASCADED CHECK OPTION规则。
其他注意事项:
- 在默认情况下,新创建的视图保存在当前选择的数据库中。若要指明在某个数据库中创建视图,在创建时应将名称指定为 “数据库.视图名”。
- 使用
SHOW TABLES的查询结果中会包含已经创建的视图。 - 创建视图要求用户具有
CREATE VIEW权限,以及查询涉及的列的SELECT权限;如果还有OR REPLACE,还必须有DROP权限。 - 在同一个数据库中,视图名称和已存在的表名称不能相同。为了区分,建议在命名时添加
view_前缀。 - 创建视图后,会在数据库创建对应的 frm 文件。
数据库编程
函数是一段用于完成特定功能的代码。
内置函数
内置函数也称为系统函数,无需定义即可直接调用。
数学函数
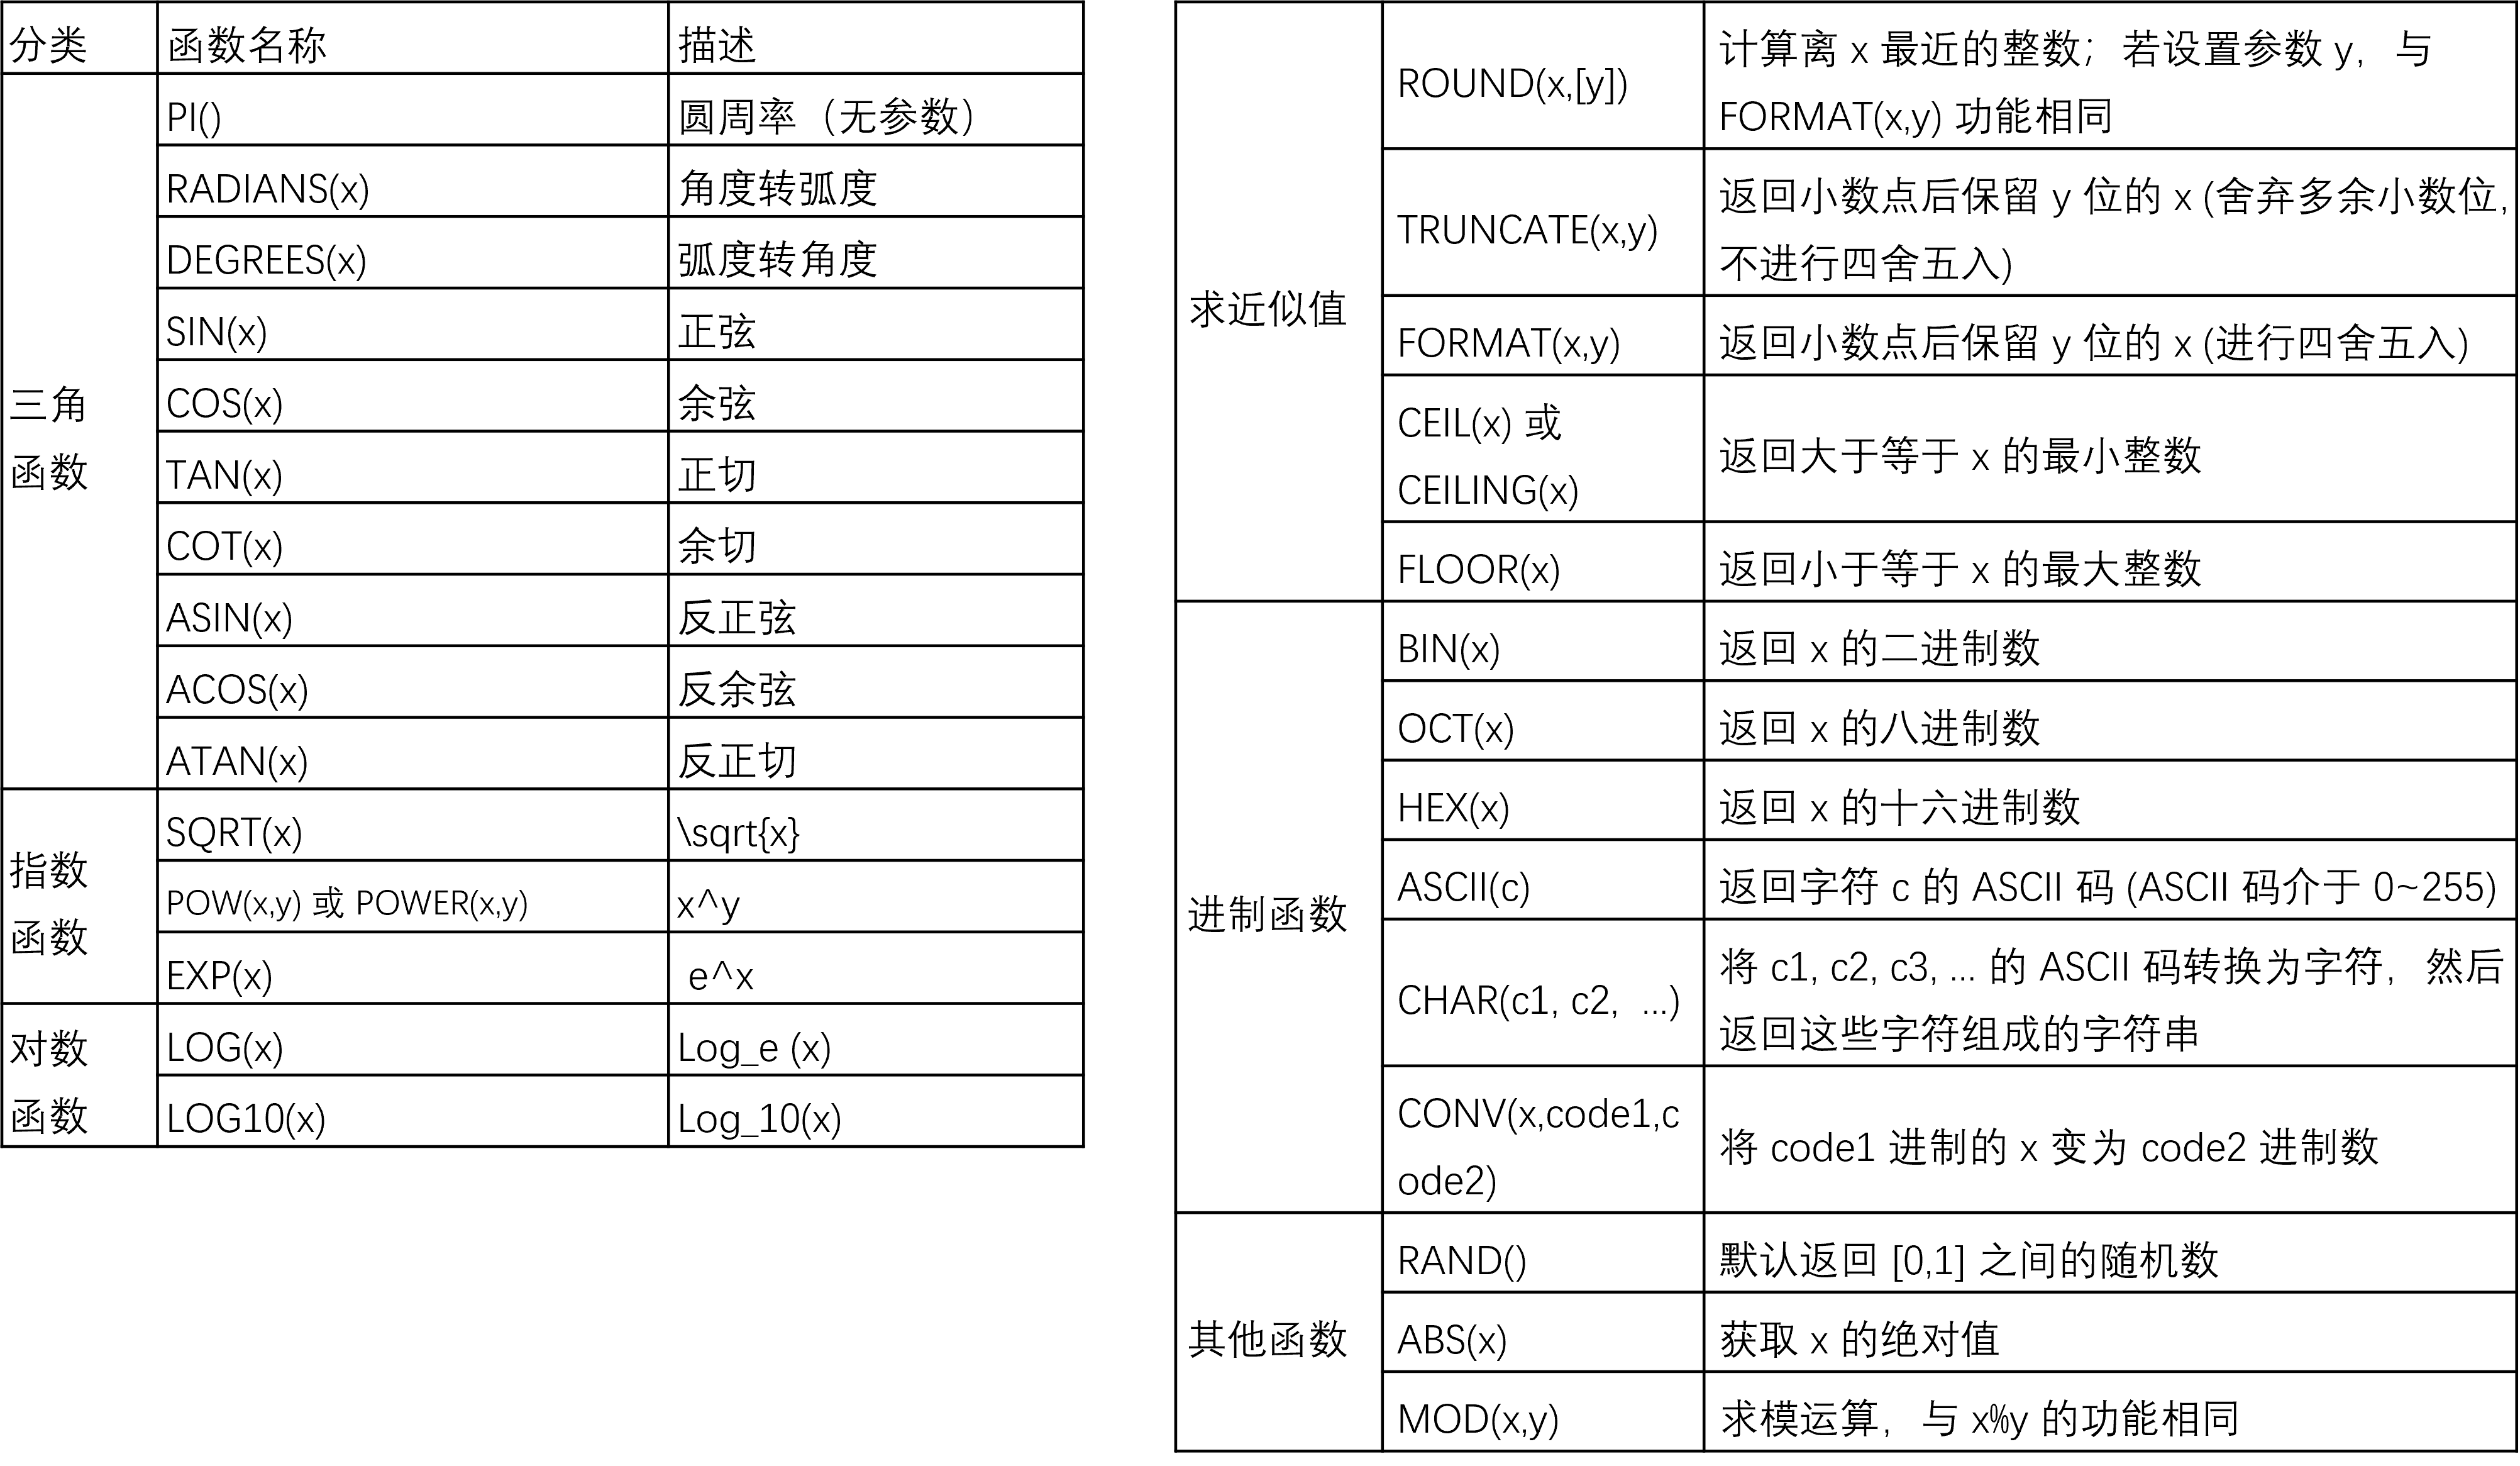
数据类型转换函数
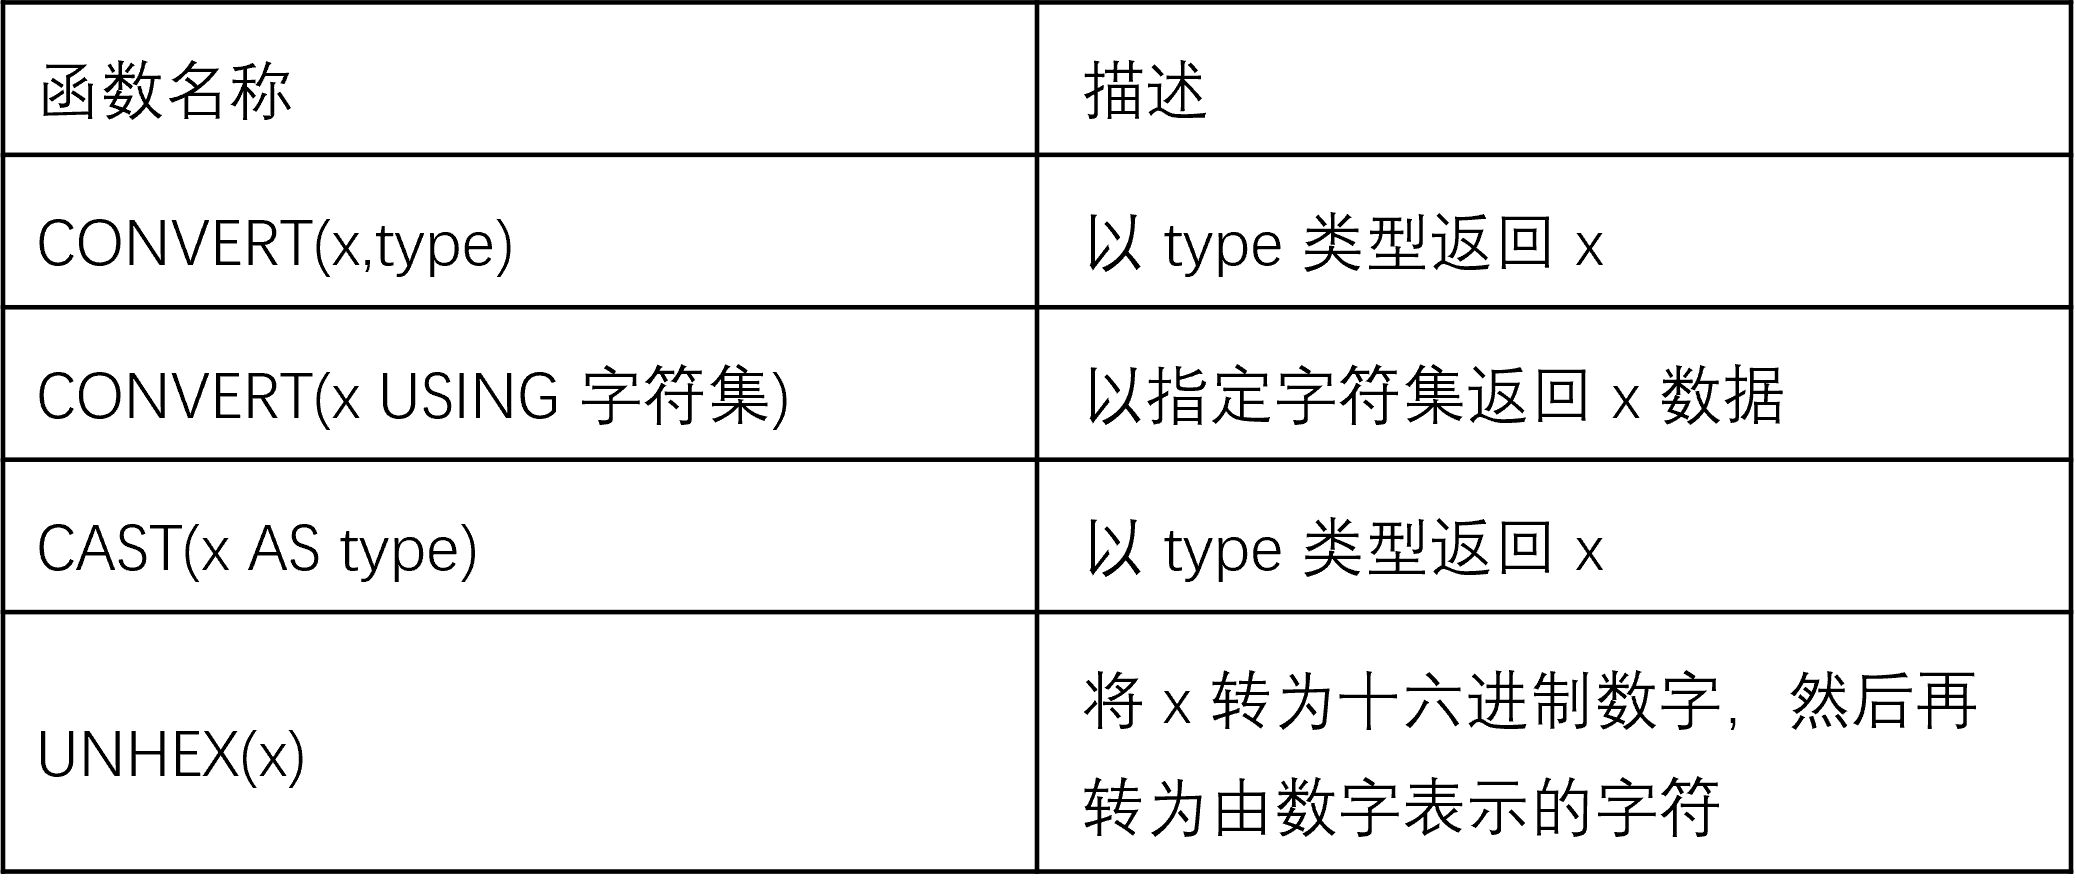
CONVERT() 和 CAST() 函数的参数 x 可以是任何类型的表达式,参数 type 的可选值如下:
BINARYCHARDATEDATETIMEDECIMALJSONSIGNED [INTEGER](INTEGER可省略)TIMEUNSIGNED [INTEGER](INTEGER可省略)
字符串长度与统计
CHAR_LENGTH('你好MySQL')  -- 7, 字符串的字符数
LENGTH('你好MySQL') -- 字符串占用的字节数
INSTR('www.mysql.com', 'mysql') -- 5, 子串在字符串中第一次出现的位置
-- LOCATE(substr, str) 和 POSITION(substr IN str) 也是常用的定位函数,参数顺序与 INSTR 相反。
FIND_IN_SET('b', 'a,b,c') -- 2,  以逗号分隔的字符串列表中查找指定字符串的位置。
字符串大小写转化
UPPER('mysql') --'MYSQL'
LOWER('MYSQL') -- 'mysql'
字符串拼接与重复
CONCAT('My', 'SQL') --'MySQL'
CONCAT_WS('-', '2023', '10', '27') -- '2023-10-27'
REPEAT('ab', 3) --'ababab'
CONCAT('a', SPACE(3), 'b') --'a   b', 生成指定次数的空格。
需要注意:
- CONCAT 如果有任何一个参数为 NULL,结果直接为 NULL
- CONCAT_WS 会忽略 NULL 值
字符串截取与填充
SUBSTRING('MySQL', 3, 2) -- 'SQ' ,若为负数则从末尾倒数。
SUBSTRING('MySQL', -3) -- 'SQL'
RIGHT('MySQL', 3) -- 'SQL'
LEFT('MySQL', 2) -- 'My'
SUBSTRING_INDEX('www.mysql.com', '.', 2)  -- 'www.mysql'
SUBSTRING_INDEX('www.mysql.com', '.', -1) -- 'com'
SUBSTRING_INDEX(SUBSTRING_INDEX(profile, ',', count1), ',', count2) -- 可截取任意区间(特别的,可取第 n 个字段)
LPAD('MySQL', 8, '*') -- '***MySQL'  ,反之若超出,则从左向右截断。
RPAD('MySQL', 8, '*') -- 'MySQL***' ,反之若超出,则从右向左截断应用:
表 user_submit:
| device_id | profile | blog_url |
|---|---|---|
| 2138 | 180 cm, 75 kg, 27, male | http:/url/bigboy 777 |
| 3214 | 165 cm, 45 kg, 26, female | http:/url/kittycc |
| 6543 | 178 cm, 65 kg, 25, male | http:/url/tiger |
| 4321 | 171 cm, 55 kg, 23, female | http:/url/uhksd |
| 2131 | 168 cm, 45 kg, 22, female | http:/urlsydney |
需求一:统计每个性别的用户分别有多少参赛者。
方法 1:
SELECT
    SUBSTRING_INDEX(profile, ',', -1) AS gender,  -- 提取性别信息
    COUNT(*) AS number                            -- 统计数量
FROM user_submit
GROUP BY gender;
方法 2:
SELECT
    CASE
        WHEN profile LIKE '%,male' THEN 'male'
        WHEN profile LIKE '%,female' THEN 'female'
    END gender,
    COUNT(device_id)
FROM user_submit
GROUP BY gender;方法 3:
SELECT
    REGEXP_SUBSTR(profile, '[^,]+$') AS gender,
    COUNT(*) AS number
FROM user_submit
GROUP BY gender;
需求二:blog_url 字段中 url 字符后的字符串为用户个人博客的用户名,将用户名提取为单独字段。
SELECT
    device_id,
    SUBSTRING_INDEX(blog_url, '/', -1) AS user_name
FROM user_submit;
需求三:统计每个年龄的用户分别有多少参赛者。
SELECT
    SUBSTRING_INDEX(SUBSTRING_INDEX(profile, ',', -2), ',', 1) AS age,
    COUNT(device_id) AS number
FROM user_submit
GROUP BY age;
字符串替换与插入
INSERT('MySQL', 3, 2, 'ABC') -- 'MyABC', 从指定位置开始,替换指定长度的子串。
SELECT REPLACE('www.mysql.com', 'mysql', 'baidu') -- 'www.baidu.com'
字符串修剪与反转类
LTRIM(' MySQL') --'MySQL'
RTRIM('MySQL ') --'MySQL'
TRIM(' MySQL ') --'MySQL', 删两侧空格
REVERSE('MySQL') --'LQSyM'
字符串的比较
SELECT STRCMP('a', 'b') -- -1
SELECT STRCMP('b', 'a') -- 1
SELECT STRCMP('a', 'a') -- 0
返回 0 表示相等,-1 表示前者小于后者,1 表示前者大于后者。
字符串的 ASCLL 码
ASCII('A');  -- 结果:65
CHAR(65);    -- 结果:'A'
字符串其它函数
ELT(2, 'a', 'b', 'c') -- 'b', 返回第 n 个字符串
FIELD('b', 'a', 'b', 'c') -- 2, 返回 str 在列表中的位置(与 ELT 相反)
FORMAT(1234567.891, 2) -- '1,234,567.89', 格式化数字,添加千分位分隔符。
SELECT GROUP_CONCAT(username) FROM users -- 聚合函数,将分组中的字符串连接起来(常用于一对多查询)- 如果拼接结果中有
NULL,GROUP_CONCAT()会自动忽略NULL值。
CREATE TABLE users (
    id INT PRIMARY KEY,
    username VARCHAR(20),
    dept VARCHAR(20)
);

INSERT INTO users VALUES
(1, '张三', '技术部'),
(2, '李四', '技术部'),
(3, '王五', '市场部'),
(4, '赵六', '市场部'),
(5, '孙七', '技术部');

SELECT GROUP_CONCAT(username) FROM users;
--- 张三,李四,王五,赵六,孙七
SELECT GROUP_CONCAT(username ORDER BY id SEPARATOR '、') AS all_users
FROM users;
-- 按 `id` 排序后再拼接,指定分隔符为中文顿号。
-- 张三、李四、王五、赵六、孙七
SELECT
    dept,
    GROUP_CONCAT(username ORDER BY id SEPARATOR ', ') AS members
FROM users
GROUP BY dept;
-- 技术部 | 张三, 李四, 孙七
-- 市场部 | 王五, 赵六需要注意的是,GROUP_CONCAT() 默认最大长度是 1024 字节,超出会被截断。可通过以下命令查看和修改:
SHOW VARIABLES LIKE 'group_concat_max_len';

SET SESSION group_concat_max_len = 1000000;
获取当前时间和日期
CURDATE() -- 2023-10-27
CURTIME() -- 14:30:00
NOW() --2023-10-27 14:30:00
日期与时间提取
DATE('2023-10-27 14:30:00') -- 2023-10-27
TIME('2023-10-27 14:30:00') -- 14:30:00
EXTRACT(YEAR FROM '2023-10-27') -- 2023
EXTRACT(MONTH FROM '2023-10-27') -- 10
注意: EXTRACT 不接受纯数字的 UNIX 时间戳。
日期时间的运算
-- 方式 1:直接加或减(简洁):
日期时间 +/- INTERVAL 表达式 日期时间类型
-- 方式 2:使用函数(标准):
DATE_ADD | ADDDATE(日期时间, INTERVAL 表达式 日期时间类型)
DATE_SUB | SUBDATE(日期时间, INTERVAL 表达式 日期时间类型)
-- 嵌套
DATE_ADD(DATE_ADD(start_time, INTERVAL 1 DAY),INTERVAL -2 HOUR) -- 加一天减两小时
-- INTERVAL 复合格式。
start_time + INTERVAL '1 2' -- DAY_HOUR 加 1 天 2 小时(使用 DAY_HOUR)

DATEDIFF('2023-10-27', '2023-10-20') -- 7 计算两个日期之间的天数差(前减后)
TIMESTAMPDIFF(YEAR, '1998-07-15', CURDATE()) -- 算任意单位的精准差值。
TIMESTAMPDIFF(unit, date1, date2) -- (单位, 开始时间, 结束时间)ADDDATE与DATE_ADD等价,SUBDATE与DATE_SUB等价;- 可同时省略
INTERVAL和日期时间类型,此时默认单位为日; - 表达式的值可以是负数。
特别注意:
- 加减月份时:如
2026-01-31 + 1 MONTH,MySQL 会返回2026-02-28(因为 2 月没有 31 日,自动取月末),不会报错。 - 当前时间:如果想对
NOW()(当前时间)进行操作,直接替换start_time即可。 - DATETIME 和 DATE 的区别:上述所有方法对
DATE(只有年月日)和DATETIME(含时分秒)都适用。如果对DATE加小时,它会变成DATETIME类型返回(以 0 时 0 分 0 秒为基准)
CREATE TABLE demo (
    d DATE,
    dt DATETIME
);
INSERT INTO demo (d, dt) VALUES ('2026-08-31', '2026-08-31 10:00:00');
-- 验证:对 DATE 加小时
SELECT
    d,
    d + INTERVAL 2 HOUR AS date_加小时,
    dt,
    dt + INTERVAL 2 HOUR AS datetime_加小时
FROM demo;| d | date_加小时 | dt | datetime_加小时 |
|---|---|---|---|
| 2026-08-31 | 2026-08-31 02:00 | 2026-08-31 10:00 | 2026-08-31 12:00 |
DATE_ADD 的单位粒度最小到“秒”,但如果字段是 DATETIME(包含毫秒或微秒),或者想加减“微秒”,就需要用到 TIMESTAMPADD
注意:TIMESTAMPADD 的参数顺序和 DATE_ADD 完全相反。
| 函数 | 顺序 | 示例 |
|---|---|---|
DATE_ADD |
(起始日期, INTERVAL 数字 单位) |
DATE_ADD('2026-08-29', INTERVAL 1 HOUR) |
TIMESTAMPADD |
(单位, 数字, 起始日期) |
TIMESTAMPADD(HOUR, 1, '2026-08-29') |
获取特定日期信息
WEEK('2023-10-27') -- 43 ,一年中的第13周
DAYNAME('2023-10-27') -- 'Friday', 星期名称(英文全称)
DAYOFMONTH('2023-10-27') -- 27 ,(与 DAY() 等价)
DAYOFYEAR('2023-10-27') -- 300 ,当年的第几天
DAYOFWEEK('2023-10-27') -- 6, 1=周日,7=周六| 函数名 | 提取粒度 | 返回值范围 | 示例(针对 2026-08-29 14:30:25) |
|---|---|---|---|
YEAR(date) |
年 | 四位数 | 2026 |
MONTH(date) |
月 | 1 ~ 12 | 8 |
DAY(date) / DAYOFMONTH |
日(月中第几天) | 1 ~ 31 | 29 |
HOUR(time) |
小时 | 0 ~ 23 | 14 |
MINUTE(time) |
分钟 | 0 ~ 59 | 30 |
SECOND(time) |
秒 | 0 ~ 59 | 25 |
QUARTER(date) |
季度 | 1 ~ 4 | 3(8 月属于第 3 季度) |
WEEK(date) |
一年中的第几周 | 0 ~ 53 | 35(约数) |
DAYOFWEEK(date) |
星期几(1=周日) | 1 ~ 7 | 7(2026-08-29 是周六) |
WEEKDAY(date) |
星期几(0=周一) | 0 ~ 6 | 5(周六) |
UNIX 时间戳获取和转换
UNIX_TIMESTAMP() -- 1698388200
UNIX_TIMESTAMP('2023-10-27 14:30:00') -- 1698388200
FROM_UNIXTIME(1698417000) --2023-10-27 14:30:00
日期格式的转化
| 函数 | 方向 | 说明 |
|---|---|---|
DATE_FORMAT(date, format) |
日期 → 字符串 | 按指定格式输出日期字符串 |
STR_TO_DATE(str, format) |
字符串 → 日期 | 按指定格式解析字符串为日期 |
FROM_UNIXTIME(timestamp) |
时间戳 → 日期时间 | 把 UNIX 时间戳转为日期时间 |
UNIX_TIMESTAMP(date) |
日期时间 → 时间戳 | 把日期时间转为 UNIX 时间戳 |
DATE_FORMAT('2023-10-27 14:30:00', '%Y-%m-%d') -- '2023-10-27'
DATE_FORMAT('2023-10-27 14:30:00', '%Y年%m月%d日 %H:%i:%s') -- '2023年10月27日 14:30:00'
DATE_FORMAT(NOW(), '%W, %M %d, %Y') -- 'Friday, October 27, 2023'
STR_TO_DATE('2023-10-27', '%Y-%m-%d') -- 2023-10-27(DATE 类型)
STR_TO_DATE('27/10/2023 14:30', '%d/%m/%Y %H:%i') -- 2023-10-27 14:30:00
STR_TO_DATE('2023年10月27日', '%Y年%m月%d日') -- 2023-10-27
FROM_UNIXTIME(1698388200) -- 2023-10-27 14:30:00
FROM_UNIXTIME(1698388200, '%Y-%m-%d') -- 2023-10-27
UNIX_TIMESTAMP('2023-10-27 14:30:00') -- 1698388200
UNIX_TIMESTAMP() -- 当前时间戳,例如 1789000000
-- 时间戳与自定义格式互转
DATE_FORMAT(FROM_UNIXTIME(1698388200), '%Y/%m/%d %H:%i') -- 2023/10/27 14:30
UNIX_TIMESTAMP(STR_TO_DATE('2023/10/27 14:30', '%Y/%m/%d %H:%i')) -- 1698388200需要注意:
DATE_FORMAT返回的是字符串,不是日期类型。STR_TO_DATE返回的是日期/日期时间类型,可用于后续日期计算。- 格式符区分大小写:
%m是月份,%i是分钟,%s是秒。 - 如果字符串格式与格式串不匹配,
STR_TO_DATE会返回NULL。 - 时间戳单位是秒,不是毫秒;如果是毫秒需先除以 1000。
| 格式符 | 含义 | 示例 |
|---|---|---|
%Y |
四位年份 | 2023 |
%y |
两位年份 | 23 |
%m |
月份(01-12) | 10 |
%c |
月份(1-12) | 10 |
%d |
日(01-31) | 27 |
%e |
日(1-31) | 27 |
%H |
小时(00-23) | 14 |
%i |
分钟(00-59) | 30 |
%s |
秒(00-59) | 00 |
%W |
星期英文全称 | Friday |
%a |
星期英文缩写 | Fri |
%M |
月份英文全称 | October |
%b |
月份英文缩写 | Oct |
窗口函数
窗口函数(Window Function)是 MySQL 8.0 引入的功能,用于在保留每一行原始数据的基础上,进行复杂的数据分析。它在结果集的每一行上都开了一个“窗口”,并基于这个窗口进行计算。
| 特性 | 普通聚合函数(与 GROUP BY 合用) |
窗口函数(与 OVER() 合用) |
|---|---|---|
| 输出结果 | 将多行数据折叠为一行结果 | 不改变原有行数,为每行数据都生成一个结果 |
| 典型函数 | SUM(), AVG(), COUNT(), MAX(), MIN() |
ROW_NUMBER(), RANK(), SUM() OVER(), LAG() 等 |
| 主要用途 | 数据汇总,如计算每个部门的总工资 | 复杂分析,如计算排名、累计和、同比环比等 |
语法:
函数名() OVER (
    [PARTITION BY 列名1, 列名2, ...]
    [ORDER BY 列名3 [ASC|DESC], ...]
    [frame_clause]
)函数名():要使用的窗口函数,如ROW_NUMBER()、SUM()等;OVER():窗口函数的关键字,用于定义数据窗口;PARTITION BY:可选。将数据按指定列分组,窗口函数在每个分组内独立计算;ORDER BY:可选。定义窗口内数据的排序方式,对排名类函数至关重要;frame_clause:可选。进一步限定窗口内的行范围,用于计算移动平均、累计和等。
group by 和partition by的区别:
第一,作用不同。GROUP BY 是分组聚合,它会把多行合并成一组,每组输出一行;PARTITION BY 是窗口函数的一部分,它把数据逻辑分区,但每行都保留,只是多算出一个窗口内的结果。
第二,语法位置不同。GROUP BY 是独立子句;PARTITION BY 必须写在 OVER() 里面,比如 ROW_NUMBER() OVER (PARTITION BY dept ORDER BY sal DESC)。
第三,业务场景不同。比如订单表里,如果我要每个用户的订单总额,每个用户一行,我会用 GROUP BY user_id。但如果我要保留每笔订单明细,同时算每个用户的累计消费、订单排名,或者每个品类下销售额 Top 3 的商品,我就会用 PARTITION BY。
第四,执行顺序和过滤不同。窗口函数在 WHERE、GROUP BY、HAVING 之后执行,所以不能直接在 WHERE 里过滤 ROW_NUMBER() 的结果,必须套一层子查询或 CTE。
最后,MySQL 8.0 才支持窗口函数。性能上,GROUP BY 会减少行数,PARTITION BY 保留行数,窗口内排序开销可能更大,大数据量时要注意。
窗口函数:排名
排名函数:ROW_NUMBER()、RANK()、DENSE_RANK()
ROW_NUMBER():为每一行分配一个唯一且连续的序号,即使排序值相同,序号也不同;RANK():计算排名,值相同则排名相同,但会产生跳跃;DENSE_RANK():计算密集排名,值相同则排名相同,但排名连续,不会跳跃。
-- 使用 WITH 构造临时数据(MySQL 8.0+)
WITH student_scores AS (
    SELECT 'Alice' AS name, 95 AS score
    UNION ALL
    SELECT 'Bob', 95
    UNION ALL
    SELECT 'Charlie', 90
    UNION ALL
    SELECT 'David', 85
)
SELECT
    name,
    score,
    ROW_NUMBER() OVER (ORDER BY score DESC) AS row_number_rank,
    RANK()       OVER (ORDER BY score DESC) AS rank_rank,
    DENSE_RANK() OVER (ORDER BY score DESC) AS dense_rank_rank
FROM student_scores
ORDER BY score DESC;| name | score | row_number_rank | rank_rank | dense_rank_rank |
|---|---|---|---|---|
| Alice | 95 | 1 | 1 | 1 |
| Bob | 95 | 2 | 1 | 1 |
| Charlie | 90 | 3 | 3 | 2 |
| David | 85 | 4 | 4 | 3 |
窗口函数:聚合
聚合窗口函数
将聚合函数 SUM() 与 OVER() 结合,可以在每一行上看到聚合计算的结果。
WITH sales_data AS (
    SELECT '销售部' AS dept, 'Alice' AS emp, 100 AS amount
    UNION ALL SELECT '销售部', 'Bob',   200
    UNION ALL SELECT '销售部', 'Charlie', 150
    UNION ALL SELECT '人事部', 'David', 300
    UNION ALL SELECT '人事部', 'Eve',   250
)
SELECT
    dept,
    emp,
    amount,
    -- 聚合窗口函数:计算部门总业绩和平均业绩(每行都附带汇总值)
    SUM(amount) OVER (PARTITION BY dept) AS 部门总业绩,
    ROUND(AVG(amount) OVER (PARTITION BY dept), 2) AS 部门平均业绩
FROM sales_data
ORDER BY dept, amount;| dept | emp | amount | 部门总业绩 | 部门平均业绩 |
|---|---|---|---|---|
| 人事部 | Eve | 250 | 550 | 275.00 |
| 人事部 | David | 300 | 550 | 275.00 |
| 销售部 | Alice | 100 | 450 | 150.00 |
| 销售部 | Charlie | 150 | 450 | 150.00 |
窗口函数 :偏移
取值函数:LAG() 和 LEAD()
LAG():访问当前行之前第 N 行的数据;LEAD():访问当前行之后第 N 行的数据。
LAG(column_name[, offset][, default_value]) OVER ([PARTITION BY ...] ORDER BY ...)
LEAD(column_name[, offset][, default_value]) OVER ([PARTITION BY ...] ORDER BY ...)column_name:指定要获取哪一列的值,返回的数据类型与此列类型一致;offset:偏移量,默认为 1,必须是非负整数(0 表示取当前行自身,但通常无意义);default_value:当偏移量超出窗口边界时(例如第一行取 LAG,最后一行取 LEAD),返回指定的默认值而不是 NULL。该参数的数据类型必须与column_name兼容,否则会报错;PARTITION BY:将数据按指定字段分组。核心特性(容易踩坑):LAG 和 LEAD 绝不会跨分区取值。当前行位于分区第一行时,LAG 会立即触发 default_value;位于分区最后一行时,LEAD 同理;ORDER BY(必写):定义分区内的数据排序规则,决定哪一行是“前”、哪一行是“后”。如果不加 ORDER BY,MySQL 会直接报错(因为“前后顺序”没有逻辑依据)。
-- 创建测试表
CREATE TABLE demo (
    id INT,
    value INT
);

-- 插入数据
INSERT INTO demo (id, value) VALUES
(1, 10),
(2, 20),
(3, 30),
(4, 40);

SELECT
    id,
    value,
    LAG(value) OVER (ORDER BY id) AS prev_value,
    LEAD(value) OVER (ORDER BY id) AS next_value
FROM demo;| id | value | prev_value | next_value |
|---|---|---|---|
| 1 | 10 | NULL | 20 |
| 2 | 20 | 10 | 30 |
| 3 | 30 | 20 | 40 |
| 4 | 40 | 30 | NULL |
窗口函数:首尾值
首尾值函数:FIRST_VALUE() 和 LAST_VALUE()
CREATE TABLE student (
    class CHAR(1),
    score INT
);

INSERT INTO student (class, score) VALUES
('A', 80),
('A', 90),
('A', 100),
('B', 60),
('B', 70);为方便对比,先按班级和分数排序查看原始数据:
SELECT class, score FROM student ORDER BY class, score;| class | score |
|---|---|
| A | 80 |
| A | 90 |
| A | 100 |
| B | 60 |
| B | 70 |
FIRST_VALUE() 默认取分区内第一行:
SELECT
    class,
    score,
    FIRST_VALUE(score) OVER (PARTITION BY class ORDER BY score) AS first_score
FROM student;| class | score | first_score |
|---|---|---|
| A | 80 | 80 |
| A | 90 | 80 |
| A | 100 | 80 |
| B | 60 | 60 |
| B | 70 | 60 |
LAST_VALUE() 的陷阱——错误写法(默认情况):
SELECT
    class,
    score,
    LAST_VALUE(score) OVER (PARTITION BY class ORDER BY score) AS last_score
FROM student;| class | score | last_score |
|---|---|---|
| A | 80 | 80(等于当前行) |
| A | 90 | 90(等于当前行) |
| A | 100 | 100(等于当前行) |
| B | 60 | 60(等于当前行) |
| B | 70 | 70(等于当前行) |
原因:MySQL 默认的窗口框架是
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW(从分区第一行到当前行)。因为“当前行”就是框架内的最后一行,所以LAST_VALUE返回的永远是自己的值。即使改为ORDER BY score DESC也有类似的问题。
| 当前行 | 当前行内容 | 此时的“窗口框架” | 框架内“最后一行” | LAST_VALUE() |
|---|---|---|---|---|
| 第 1 行 | 80 | 从第一行(80)到当前行(80),只有 [80] | 80 | 返回 80 |
| 第 2 行 | 90 | 从第一行(80)到当前行(90),包含 [80, 90] | 90(90 是框架末尾) | 返回 90 |
| 第 3 行 | 100 | 从第一行(80)到当前行(100),包含 [80, 90, 100] | 100(100 是框架末尾) | 返回 100 |
解决方法:显式指定框架为 ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING(从分区第一行到最后一行):
SELECT
    class,
    score,
    LAST_VALUE(score) OVER (
        PARTITION BY class
        ORDER BY score
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
    ) AS last_score
FROM student;| class | score | last_score |
|---|---|---|
| A | 80 | 100 |
| A | 90 | 100 |
| A | 100 | 100 |
| B | 60 | 70 |
| B | 70 | 70 |
窗口框架 Frame 子句
窗口框架可以更精细地控制聚合计算所包含的行范围,是实现移动平均和累计求和的关键。
ROWS | RANGE BETWEEN 起点 AND 终点ROWS:按物理行数滑动(前 N 行、后 N 行),最常用;RANGE:按数值范围滑动(例如取当前价格 ±10 的所有行);- 常用边界:
UNBOUNDED PRECEDING:分区内的第一行;n PRECEDING:当前行之前的第 n 行;CURRENT ROW:当前行;n FOLLOWING:当前行之后的第 n 行;UNBOUNDED FOLLOWING:分区内的最后一行。
- 常用组合:
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW:从分区第一行到当前行;ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING:从前一行到后一行(共 3 行)。
CREATE TABLE sales (
    month INT,
    amount INT
);

INSERT INTO sales (month, amount) VALUES
(1, 100),
(2, 200),
(3, 300),
(4, 400),
(5, 500);累计求和——窗口必须从分区第一行开始,到当前行结束:
SELECT
    month,
    amount,
    SUM(amount) OVER (
        ORDER BY month
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total
FROM sales;| month | amount | running_total |
|---|---|---|
| 1 | 100 | 100 |
| 2 | 200 | 300 |
| 3 | 300 | 600 |
| 4 | 400 | 1000 |
| 5 | 500 | 1500 |
移动平均——窗口起点是当前行的前 2 行,终点是当前行:
SELECT
    month,
    amount,
    AVG(amount) OVER (
        ORDER BY month
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS moving_avg_3months
FROM sales;| month | amount | moving_avg_3months |
|---|---|---|
| 1 | 100 | 100.00(100/1) |
| 2 | 200 | 150.00(300/2) |
| 3 | 300 | 200.00(600/3) |
| 4 | 400 | 300.00(900/3) |
| 5 | 500 | 400.00(1200/3) |
中心移动平均——前后各取 1 行:
SELECT
    month,
    amount,
    AVG(amount) OVER (
        ORDER BY month
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS center_moving_avg
FROM sales;| month | amount | center_moving_avg |
|---|---|---|
| 1 | 100 | 150.00((100+200)/2) |
| 2 | 200 | 200.00((100+200+300)/3) |
| 3 | 300 | 300.00((200+300+400)/3) |
| 4 | 400 | 400.00((300+400+500)/3) |
| 5 | 500 | 450.00((400+500)/2) |
加密和散列函数
- 加密函数主要用于对数据进行加密,相对明文存储,经过算法计算后的字符串不会被人直接看出保存的是什么数据,在一定程度上能够有效保证数据的安全;
- 散列函数又称为哈希(Hash)函数,用于通过散列算法计算数据的散列值。
| 函数名称 | 作用 |
|---|---|
MD5() |
使用 MD5 计算并返回一个 32 位的散列字符串 |
AES_ENCRYPT() |
使用密钥对字符串进行加密,默认返回一个 128 位的二进制数 |
AES_DECRYPT() |
使用密钥对密码进行解密 |
SHA1() 或 SHA() |
利用安全散列算法 SHA-1 计算字符串,返回 40 个十六进制数字组成的字符串 |
SHA2() |
利用安全散列算法 SHA-2 计算字符串 |
ENCODE() |
使用密钥对字符串进行编码,默认返回一个二进制数 |
DECODE() |
使用密钥对密码进行解码 |
PASSWORD() |
计算并返回一个 41 位的密码字符串 |
注意:加密函数
ENCODE()、DECODE()从 MySQL 5.7 起,以及PASSWORD()函数从 5.7.6 起,都已不推荐使用,并将在之后的 MySQL 版本中被删除。
系统信息函数
系统信息函数用于方便地查看 MySQL 服务器的系统信息,如 MySQL 版本号、登录服务器的用户名、主机地址等。
| 函数名称 | 作用 |
|---|---|
VERSION() |
获取当前 MySQL 服务实例使用的 MySQL 版本号 |
DATABASE() |
获取当前操作的数据库,与 SCHEMA() 函数等价 |
USER() |
获取登录服务器的主机地址及用户名,与 SYSTEM_USER() 和 SESSION_USER() 等价 |
CURRENT_USER() |
获取该账户允许通过哪些登录主机连接 MySQL 服务器 |
CONNECTION_ID() |
获取当前 MySQL 服务器的连接 ID |
BENCHMARK() |
重复执行一个表达式 |
LAST_INSERT_ID() |
获取当前会话中最后一个插入的 AUTO_INCREMENT 列的值 |
BENCHMARK() 函数经常用于检测标量表达式的运行性能,这对优化 MySQL 数据库具有重要意义。
BENCHMARK(重复执行次数, 标量表达式或标量子查询)BENCHMARK 执行后的返回值始终为 0:
mysql> SELECT BENCHMARK(10, '3 * 7');
+------------------------+
| BENCHMARK(10, '3 * 7') |
+------------------------+
|                      0 |
+------------------------+
1 row in set (0.00 sec)
JSON 函数
MySQL 为方便操作 JSON 类型的数据,提供了很多 JSON 函数。
| 函数名称 | 描述 |
|---|---|
JSON_ARRAY() |
创建 JSON 数组 |
JSON_OBJECT() |
创建 JSON 对象 |
JSON_CONTAINS() |
JSON 文档中是否包含路径中指定对象 |
JSON_CONTAINS_PATH() |
JSON 文档中是否包含路径中的任意数据 |
JSON_EXTRACT() |
从 JSON 文档返回数据 |
JSON_KEY() |
从 JSON 文档中获取数组中的键 |
JSON_SEARCH() |
获取 JSON 文档中的路径 |
JSON_ARRAY_APPEND() |
将数据追加到 JSON 文档的指定路径中 |
JSON_ARRAY_INSERT() |
将数据插入到 JSON 数组指定路径前 |
JSON_DEPTH() |
获取 JSON 文档的最大深度 |
JSON_INSERT() |
将数据插入 JSON 文档 |
JSON_LENGTH() |
获取 JSON 文档中元素的数量 |
JSON_MERGE_PATCH() |
合并 JSON 文档,替换重复键的值 |
JSON_MERGE_PRESERVE() |
合并 JSON 文档,保留重复键的值 |
JSON_PRETTY() |
以友好的格式打印 JSON 文档 |
JSON_REMOVE() |
从 JSON 文档中删除数据 |
JSON_REPLACE() |
替换 JSON 文档中的值 |
JSON_SET() |
向 JSON 文档中插入数据 |
JSON_TYPE() |
获取 JSON 值的类型 |
JSON_VALID() |
JSON 值是否有效 |
创建 JSON
用 JSON_ARRAY() 和 JSON_OBJECT() 可以将给定值或键值对转换为 JSON 数组或对象:
JSON_ARRAY([val[, val] ...])               -- 创建 JSON 数组
JSON_OBJECT([key, val[, key, val] ...]) -- 创建 JSON 对象JSON_ARRAY()的参数val为数组元素,可以是任意类型(包括NULL);JSON_OBJECT()的参数key和val必须成对出现,若参数个数为奇数或key为NULL,则会报错。
mysql> SELECT JSON_ARRAY('cake', 2, NULL),
       JSON_OBJECT("id", 12, "name", "Tom");
+---------------------------+-----------------------------------+
| JSON_ARRAY('cake',2,NULL) | JSON_OBJECT("id",12,"name","Tom") |
+---------------------------+-----------------------------------+
| ["cake", 2, null]         | {"id": 12, "name": "Tom"}         |
+---------------------------+-----------------------------------+
1 row in set (0.00 sec)
插入与更新:JSON_SET / JSON_INSERT / JSON_REPLACE
若要在已有 JSON 文档中添加新数据或更新现有值,可以使用以下三个函数,它们的区别如下:
JSON_SET():若键不存在则添加,若存在则替换为新值;JSON_INSERT():若键不存在则插入,若存在则保留原值(不覆盖);JSON_REPLACE():只替换已存在的键的值,若键不存在则不操作。
mysql> SELECT JSON_SET('{"id": 12}', "$.email", "test@163.com") AS c1,
       JSON_SET('{"id": 12}', "$.id", "8") AS c2 \G
*************************** 1. row ***************************
c1: {"id": 12, "email": "test@163.com"}
c2: {"id": "8"}
1 row in set (0.00 sec)- 第一个操作中,键
email不存在,因此被添加; - 第二个操作中,键
id已存在,因此值被替换为"8"; "$.email"的含义:$表示整个 JSON 文档,$.email表示获取该文档中键为email的值。
删除:JSON_REMOVE()
使用 JSON_REMOVE() 函数可以删除 JSON 文档中指定路径的数据:
mysql> SELECT JSON_REMOVE('["a", [2,3], "b"]', "$[1]");
+------------------------------------------+
| JSON_REMOVE('["a", [2,3], "b"]', "$[1]") |
+------------------------------------------+
| ["a", "b"]                               |
+------------------------------------------+
1 row in set (0.00 sec)- 第一个参数为 JSON 文档;
- 第二个参数为待删除数据的路径(这里
$[1]表示删除数组索引为 1 的元素[2,3])。
合并:JSON_MERGE_PATCH() / JSON_MERGE_PRESERVE()
JSON_MERGE_PATCH():合并时,若出现相同键,则用新值覆盖旧值;JSON_MERGE_PRESERVE():合并时,若出现相同键,则保留所有值(通常以数组形式合并)。
查找与提取:JSON_SEARCH() / JSON_EXTRACT()
MySQL 提供了两个互补的函数:
JSON_SEARCH():根据给定的值,在 JSON 文档中查找其对应的路径;JSON_EXTRACT():根据给定的路径,从 JSON 文档中提取对应的值。
mysql> SELECT
    ->   JSON_SEARCH('{"cookie":"23","eat":"cookie"}', 'all', 'cookie') AS c1,
    ->   JSON_EXTRACT('{"cookie":"23","eat":"cookie"}', '$.cookie', '$.eat') AS c2 \G
*************************** 1. row ***************************
c1: ["$.cookie", "$.eat"]
c2: ["23", "cookie"]
1 row in set (0.00 sec)JSON_SEARCH()的第二个参数可取'one'或'all':'one'表示找到第一个匹配值即停止,'all'返回所有匹配值的路径(以数组形式);JSON_EXTRACT()可以指定多个路径参数,用逗号分隔,返回对应的值数组。
-> 与 ->> 操作符
查询数据表时提取 JSON 字段的值,可以使用更简洁的运算符,替代 JSON_EXTRACT() 和 JSON_UNQUOTE():
| 完整写法 | 等价简写 | 说明 |
|---|---|---|
JSON_EXTRACT(column, path) |
column -> path |
提取 JSON 值(保留引号) |
JSON_UNQUOTE(JSON_EXTRACT(column, path)) |
column ->> path |
提取 JSON 值并移除引号(返回纯字符串) |
-- 等价于 JSON_EXTRACT(info, '$.name')
SELECT info -> '$.name' FROM users;

-- 等价于 JSON_UNQUOTE(JSON_EXTRACT(info, '$.name'))
SELECT info ->> '$.name' FROM users;
IP 地址与数字的转换
在项目开发中,为了节省存储 IP 地址的空间并提升处理效率,推荐使用 INET_ATON() 函数将 IP 地址转换为数字后存入数据库,使用时再通过 INET_NTOA() 将数字还原为 IP 地址。
mysql> SELECT INET_ATON('192.168.22.11');
+----------------------------+
| INET_ATON('192.168.22.11') |
+----------------------------+
|                 3232241163 |
+----------------------------+
1 row in set (0.00 sec)其计算方式为:11 + 22 * 256 + 168 * 256^2 + 192 * 256^3。若传入非法 IP 地址(如 '1.1.1.1.1'),函数将返回 NULL。
反向转换:
mysql> SELECT INET_NTOA(3232241163);
+-----------------------+
| INET_NTOA(3232241163) |
+-----------------------+
| 192.168.22.11         |
+-----------------------+
1 row in set (0.00 sec)
延迟语句执行:SLEEP()
使用 SLEEP() 函数可以延迟当前语句的执行,参数为延迟的秒数:
mysql> SELECT SLEEP(2);
+----------+
| SLEEP(2) |
+----------+
|        0 |
+----------+
1 row in set (2.00 sec)
获取唯一标识符:UUID()
除了使用 AUTO_INCREMENT 自增列外,MySQL 还提供了 UUID() 函数,用于在同一时间、同一空间内生成唯一的标识符:
mysql> SELECT UUID();
+--------------------------------------+
| UUID()                               |
+--------------------------------------+
| 7e0072e3-6bb4-11e8-9ebb-40167e6696ec |
+--------------------------------------+
1 row in set (0.00 sec)
生成的 UUID 由 32 位小写十六进制数字组成,分为 5 部分:
- 前 3 部分基于时间戳(低、中、高位,高位含 UUID 版本号);
- 第 4 部分用于保证时间的唯一性;
- 第 5 部分用于保证空间的唯一性。
注意:理论上 UUID 是唯一的,但并不能绝对保证其他方式不会产生相同的标识符。
自定义函数
DELIMITER 的作用
默认语句结束符为 ;,与函数体内的 ; 冲突。定义函数前先用 DELIMITER $$ 临时更换结束符,定义完再改回 DELIMITER ;。
基本语法
DELIMITER $$
CREATE FUNCTION 函数名(参数1 类型, ...)
RETURNS 返回类型
[DETERMINISTIC | NO SQL | READS SQL DATA | MODIFIES SQL DATA]
BEGIN
    -- 函数体
    RETURN 值;
END$$
DELIMITER ;特性声明(binlog 相关)
开启二进制日志时,MySQL 要求声明函数的确定性,否则可能报错(log_bin_trust_function_creators):
DETERMINISTIC:相同输入总是产生相同输出;NO SQL:函数体内不含 SQL 语句;READS SQL DATA:只读数据,不修改;MODIFIES SQL DATA:会修改数据。
局部变量
DECLARE 变量名 类型 [DEFAULT 默认值];  -- 只能出现在 BEGIN 开头
SET 变量名 = 值;
SELECT 列 INTO 变量名 FROM ...;        -- 赋值
流程控制
-- IF
IF 条件 THEN ...
ELSEIF 条件 THEN ...
ELSE ...
END IF;
-- CASE
CASE 表达式
WHEN 值1 THEN ...
ELSE ...
END CASE;
-- WHILE(先判断后执行)
WHILE 条件 DO ... END WHILE;
-- LOOP + LEAVE(需要手动退出)
循环标号: LOOP
...
IF 条件 THEN LEAVE 循环标号; END IF;
END LOOP;完整示例:根据分数返回等级
DELIMITER $$
CREATE FUNCTION score_level(score INT)
RETURNS VARCHAR(10)
DETERMINISTIC
BEGIN
DECLARE level VARCHAR(10);
IF score >= 90 THEN SET level = '优秀';
ELSEIF score >= 80 THEN SET level = '良好';
ELSEIF score >= 60 THEN SET level = '及格';
ELSE SET level = '不及格';
END IF;
RETURN level;
END$$
DELIMITER ;
-- 调用
SELECT student_no, score, score_level(score) AS level FROM score;查看与删除
SHOW CREATE FUNCTION score_level; -- 查看定义
DROP FUNCTION [IF EXISTS] score_level;